DynamoDB のグローバルセカンダリインデックス(GSI)
キーのないアクセスパターンごとに GSI を足し、書き込みコストが 3 倍になって目覚め、強整合を想定したせいでインデックスから古い行をまだ読む。グローバルセカンダリインデックスは AWS が維持してくれる第 2 のテーブルだ。同じ課金ルール、結果整合の読み取りのみ、そしてそれに触れるベーステーブル書き込みのたびに 1 回の追加書き込み。
毎秒 100 書き込みの 1 KB アイテム、us-east-1 オンデマンドの定価では、インデックスなしで書き込みは月 $164.25、GSI 1 つで $328.50、2 つで $492.75。足す各 ALL 射影 GSI が書き込みスループットを買い直す。
このセクションで身につくこと
- 2 つ目や 3 つ目のインデックスにコミットする前に GSI 書き込み増幅を見積もれる。
- 特定のアクセスパターンに対して GSI 対 LSI 対フィルター式を選べる。
- 結果が半分の RCU レートで結果整合であることを知りつつ GSI から読める。
- 射影とクォータ上限を破らずにスパースキーとオーバーロードキーを設計できる。
読む順番
- GSI 対 LSI: 再パーティション化された読み取り対同じハッシュの代替ソート。作成時ルールと 10 GB LSI コレクション上限。
- インデックス射影:
ALL、KEYS_ONLY、INCLUDE。ストレージ、読み取り、書き込みのトレードオフ。 - スパースインデックス: 冷たい行でインデックスキーを省略し、ホットな部分集合だけがコピーされるようにする。
- キーのオーバーロード: 型付きの値を持つ汎用の
pk/sk名を、テーブル上と 1 つの GSI 上でbegins_withによって切り分ける。 - GSI の結果整合: read-your-writes の失敗と、ベーステーブル読み取りが必要な UI パターン。
- GSI がベーステーブルをスロットルする: プロビジョニング不足またはホットな GSI パーティションがベーステーブルの書き込みをスロットルする。
- ベクトル検索: ベクトルインデックス、
SearchVectors、バイト単位の課金、そして S3 Vectors のほうが安くなるとき。
グローバルセカンダリインデックスとは?
GSI は、トップレベルの String、Number、または Binary 属性から選んだ独自のパーティションキーと任意のソートキーを持つインデックスだ。2025 年 11 月以降、それぞれが最大 4 つの属性を組み合わせられる。インデックスキーはテーブルのキーを含む必要はない。
DynamoDB がコピーを維持する。アイテムを put、update、delete すると、影響を受けるすべての GSI が非同期に更新される。インデックスへ直接書くことはない。インデックス名に対する Query または Scan で読む。
| field | value | note |
|---|---|---|
| PK | "ACCOUNT#9313" | table partition key |
| SK | "TICKET#2026-08-01#K4" | table sort key |
| status | "CLOSED" | GSI partition key |
| opened | "2026-08-01" | GSI sort key |
status-opened GSI を status = "OPEN" でクエリすると、すべてのアカウントにまたがるオープンなチケットを日付順で得る。ベーステーブルは Scan なしではそれに答えられない。
インデックスキー属性を欠くアイテムは、インデックスに存在しない。その隙間をスパースインデックス が利用し、巨大テーブルの小さなホット部分集合を、それ自体の事前フィルターされたコレクションに変える。
GSI はいくらかかるか?
書き込み側が支配する。1 KB アイテムは 1 書き込みキャパシティユニット(書き込みは 1 KB ごとに切り上げ)で、
ALL 射影ならすべてのベーステーブル書き込みがすべての GSI へ繰り返される。
3 つの持続書き込みレートについて定価で計算した:
| 持続書き込み | GSI 0 | GSI 1 | GSI 2 |
|---|---|---|---|
| 10 writes/s | $16.43/mo | $32.85/mo | $49.28/mo |
| 100 writes/s | $164.25/mo | $328.50/mo | $492.75/mo |
| 1,000 writes/s | $1,642.50/mo | $3,285.00/mo | $4,927.50/mo |
最大 1 KB のアイテム、オンデマンド、us-east-1、AWS 公開の百万書き込みリクエストユニットあたり $0.625(2026-07-29 に料金を同期)。10 writes/s は 730 時間の請求月で 2,628 万 WRU。
GSI 列は正確な倍数ではなく下限として読む。インデックスアイテムはベーステーブルのキー、インデックス自身のキー、約 100 バイトのオーバーヘッドを運ぶので、1 KB の線に近いベースアイテムは各インデックスへ 1 ではなく 2 WRU を書き、×2 と ×3 はそこから増える。
GSI キー値を変える更新は 2 回のインデックス書き込みを請求する(古いエントリを削除し、新しいものを put する)ので、揮発性のインデックスキーは安定したものより高い。インデックスが格納する属性に触れない更新は、そのインデックスに何のコストもかけない。
ストレージも繰り返す。ALL 射影は us-east-1 で月 $0.25/GB(同じ同期)でテーブルを再格納し、インデックスアイテムあたり 100 バイトのオーバーヘッドが加わる。10 GB のテーブルは GSI あたり月 $2.50 の追加だ。
射影 を KEYS_ONLY または INCLUDE に縮めると両方の請求が縮む。インデックス射影 を参照。
プロビジョンドモードでは同じ増幅がキャパシティとして現れ、プロビジョニング不足の GSI がベーステーブルの書き込みをスロットルする。なぜ GSI がベーステーブルの書き込みをスロットルするかがその失敗を順に追う。
自分のワークロードを見積もるには、料金計算機 が上の数字と同じ料金表で走る。
GSI が読み取りをどう課金するか
GSI の読み取りは常に 結果整合 で、結果整合の読み取りは半額レートで課金される。4 KB あたり 0.5 RCU。
二十個の 1 KB アイテムを返す Query は合計 20 KB、五つの 4 KB ユニットに切り上げ、
2.5 RCU を請求する。同じ二十アイテムをベーステーブルから強整合で読むと 5 RCU。
半額はラグを買う。変更は GSI へ "within a fraction of a second, under normal conditions"
(AWS の文言)に伝播し、それを待ち切る ConsistentRead オプションはない。
コードが自分の書き込みを GSI 経由で読み戻すなら、本番で刺さる前になぜ GSI は結果整合か を読む。
GSI 対 LSI 対フィルター式
| あなたのアクセスパターン | 手に取るもの | なぜ |
|---|---|---|
| テーブルキーではない属性でクエリする | GSI | 再パーティション化する唯一のインデックス。ライブテーブルへいつでも追加できる |
| 同じパーティション内の第 2 ソート順、強整合読み取り | LSI | テーブルキャパシティを共有し ConsistentRead をサポート。作成時のみ、10 GB コレクション上限 |
| 巨大テーブルの小さなホット部分集合をクエリする | スパース GSI | インデックスキーを運ぶアイテムだけがコピーされ、インデックスが小さく安く保たれる |
すでに安い 1 回の Query である結果セットを絞る | フィルター式 | 維持するコピーはないが、捨てる各アイテムを読む分は支払う |
| 二度と聞かないワンオフの質問 | インデックスなし | Scan またはエクスポートは一度のコスト。インデックスは毎月コストがかかる |
LSI の上限は聞こえるより厳しい。パーティションキー値あたり 10 GB は、ベーステーブルアイテムとそのキーを持つすべての LSI エントリを数える。上限に達すると DynamoDB はコレクションを大きくする書き込みを拒否しうる。縮める書き込みはそのまま通る。
書き込みに ReturnItemCollectionMetrics: "SIZE" を渡し、10 GB よりかなり手前(AWS は 8 GB を勧める)でアラートを出し、そのコレクションを削るかアーカイブする。その上限と作成時のみのルールが、GSI が既定である理由だ。
GSI 対 LSI が全体の論を立てる。
インデックス設計を形づくる上限
これらは GSI と LSI に適用される。ベクトルインデックスには独自の上限があり、
SearchVectors で読む(ベクトル検索 を参照)。
- テーブルあたり 20 GSI: 既定クォータで、AWS サポートに引き上げを依頼できる。
- テーブルあたり 5 LSI: 固定で、
CreateTable時のみ。あとから追加できない。 - 100 の射影属性: テーブルの全インデックスにまたがる
INCLUDE属性の合計。KEYS_ONLYとALL射影はそれにカウントされない。 QueryとScanのみ:GetItemとBatchGetItemは GSI でも LSI でも動かない。- GSI からのベーステーブル取得なし: GSI クエリは射影された属性だけを返し、それ以外の属性を求めるとエラーになる。その属性を射影するか、すべての GSI エントリが運ぶベースキーを取り、アイテムを
BatchGetItemする(1 回の呼び出しで最大 100 件)。 LSI クエリは追加の読み取りコストで未射影属性を取得できる。 - インデックスキーはトップレベルのスカラー:
String、Number、またはBinary。セット、リスト、マップ、ネスト属性は不可。address.cityのようなネストした値をインデックスするには、同じ書き込みでトップレベルのコピー(address_city)を書く。 - 複数属性の GSI キー: GSI のパーティションキーとソートキーはそれぞれ最大 4 つの属性を組み合わせられる。LSI のソートキーはちょうど 1 つの属性だ。
稼働中のテーブルに GSI を追加する
LSI と違い、GSI はすでにトラフィックを捌いているテーブルにも追加できる。
UpdateTable は 1 回の呼び出しにつきインデックスの作成または削除を 1 つ受け付け、その間もテーブルは読み書きを捌き続ける(ステータスは UPDATING を経由する)。
DynamoDB は新しいインデックスを 2 つのフェーズで構築する。インデックスのリソースを割り当て、次にインデックスキー属性を持つ既存アイテムをすべてバックフィルする。
バックフィルには 3 つの帰結がある:
- 完了するまでインデックスをクエリできない。 インデックスは
CREATINGを報告し(コピーが始まるとBackfillingフラグが立つ)、ステータスがACTIVEになるまでそのインデックスへのQueryは拒否される。 - バックフィルの読み取りは無料で、インデックスのキャパシティを増やしても速くならない。 DynamoDB は既存アイテムを内部キャパシティで読むので、その走査はテーブルに課金されない。 AWS は、インデックスの書き込みキャパシティを上げても構築は短くならないと述べている。
- 所要時間はテーブル次第だ。 テーブルサイズ、対象となるアイテム数、射影属性、構築中の書き込み活動がそれを決める。小さなテーブルなら数分、数百ギガバイトなら数時間。進捗は CloudWatch メトリクス
OnlineIndexPercentageProgressで見る。
AWS が挙げるリスクは、偏った新しいインデックスキーが構築中にライブの書き込みをスロットルすることだ。トラフィックの少ないときにインデックスを追加し、テーブルの
WriteThrottleEvents を見張る。バックフィル中のインデックスは削除できる。
よくある質問
既存の DynamoDB テーブルに GSI を追加できるか?できる。GSI は UpdateTable でいつでも稼働中のテーブルに追加でき、1 回の呼び出しにつきインデックスは 1 つ、DynamoDB がインデックスをバックフィルするあいだもテーブルは読み書きを捌き続ける。テーブル作成時に固定されるのは LSI だけだ。
GSI のバックフィルにはどれくらいかかるか?テーブルサイズ、インデックスの対象となるアイテム数、射影属性、構築中の書き込み活動次第で、インデックスの書き込みキャパシティには左右されない。小さなテーブルなら数分、大きなテーブルなら数時間。進捗は OnlineIndexPercentageProgress で見る。ステータスが
ACTIVE になるまで、そのインデックスへのクエリは拒否される。
作成したあとに GSI を変更できるか?できない。既存の GSI のキーや射影を変える手段は DynamoDB にない。望む形の代わりのインデックスを作り、ACTIVE になるのを待ち、読み取り側をそちらへ移し、古いほうを削除する。例外はスループット設定(プロビジョンドキャパシティ、オンデマンドの最大値、ウォームスループット)で、これらはその場で更新できる。
既存のテーブルに LSI を追加できるか?できない。LSI は CreateTable で宣言した場合にのみ存在し、あとからどんなツールでも追加できない。既存のテーブルで第 2 ソート順が必要なら、同じパーティションキーを持つ
GSI を追加する。そこで強整合読み取りが必要なら、LSI 付きの新しいテーブルを作ってアイテムをコピーする。Import from S3 では LSI を作れない。
DynoTable を開く
DynoTable のテーブル設定ダイアログはテーブルのキー構造と、キー付きのすべての GSI と LSI を一覧するので、自分で DescribeTable を走らせずに、テーブルがすでにどのアクセスパターンを満たすかが見える。

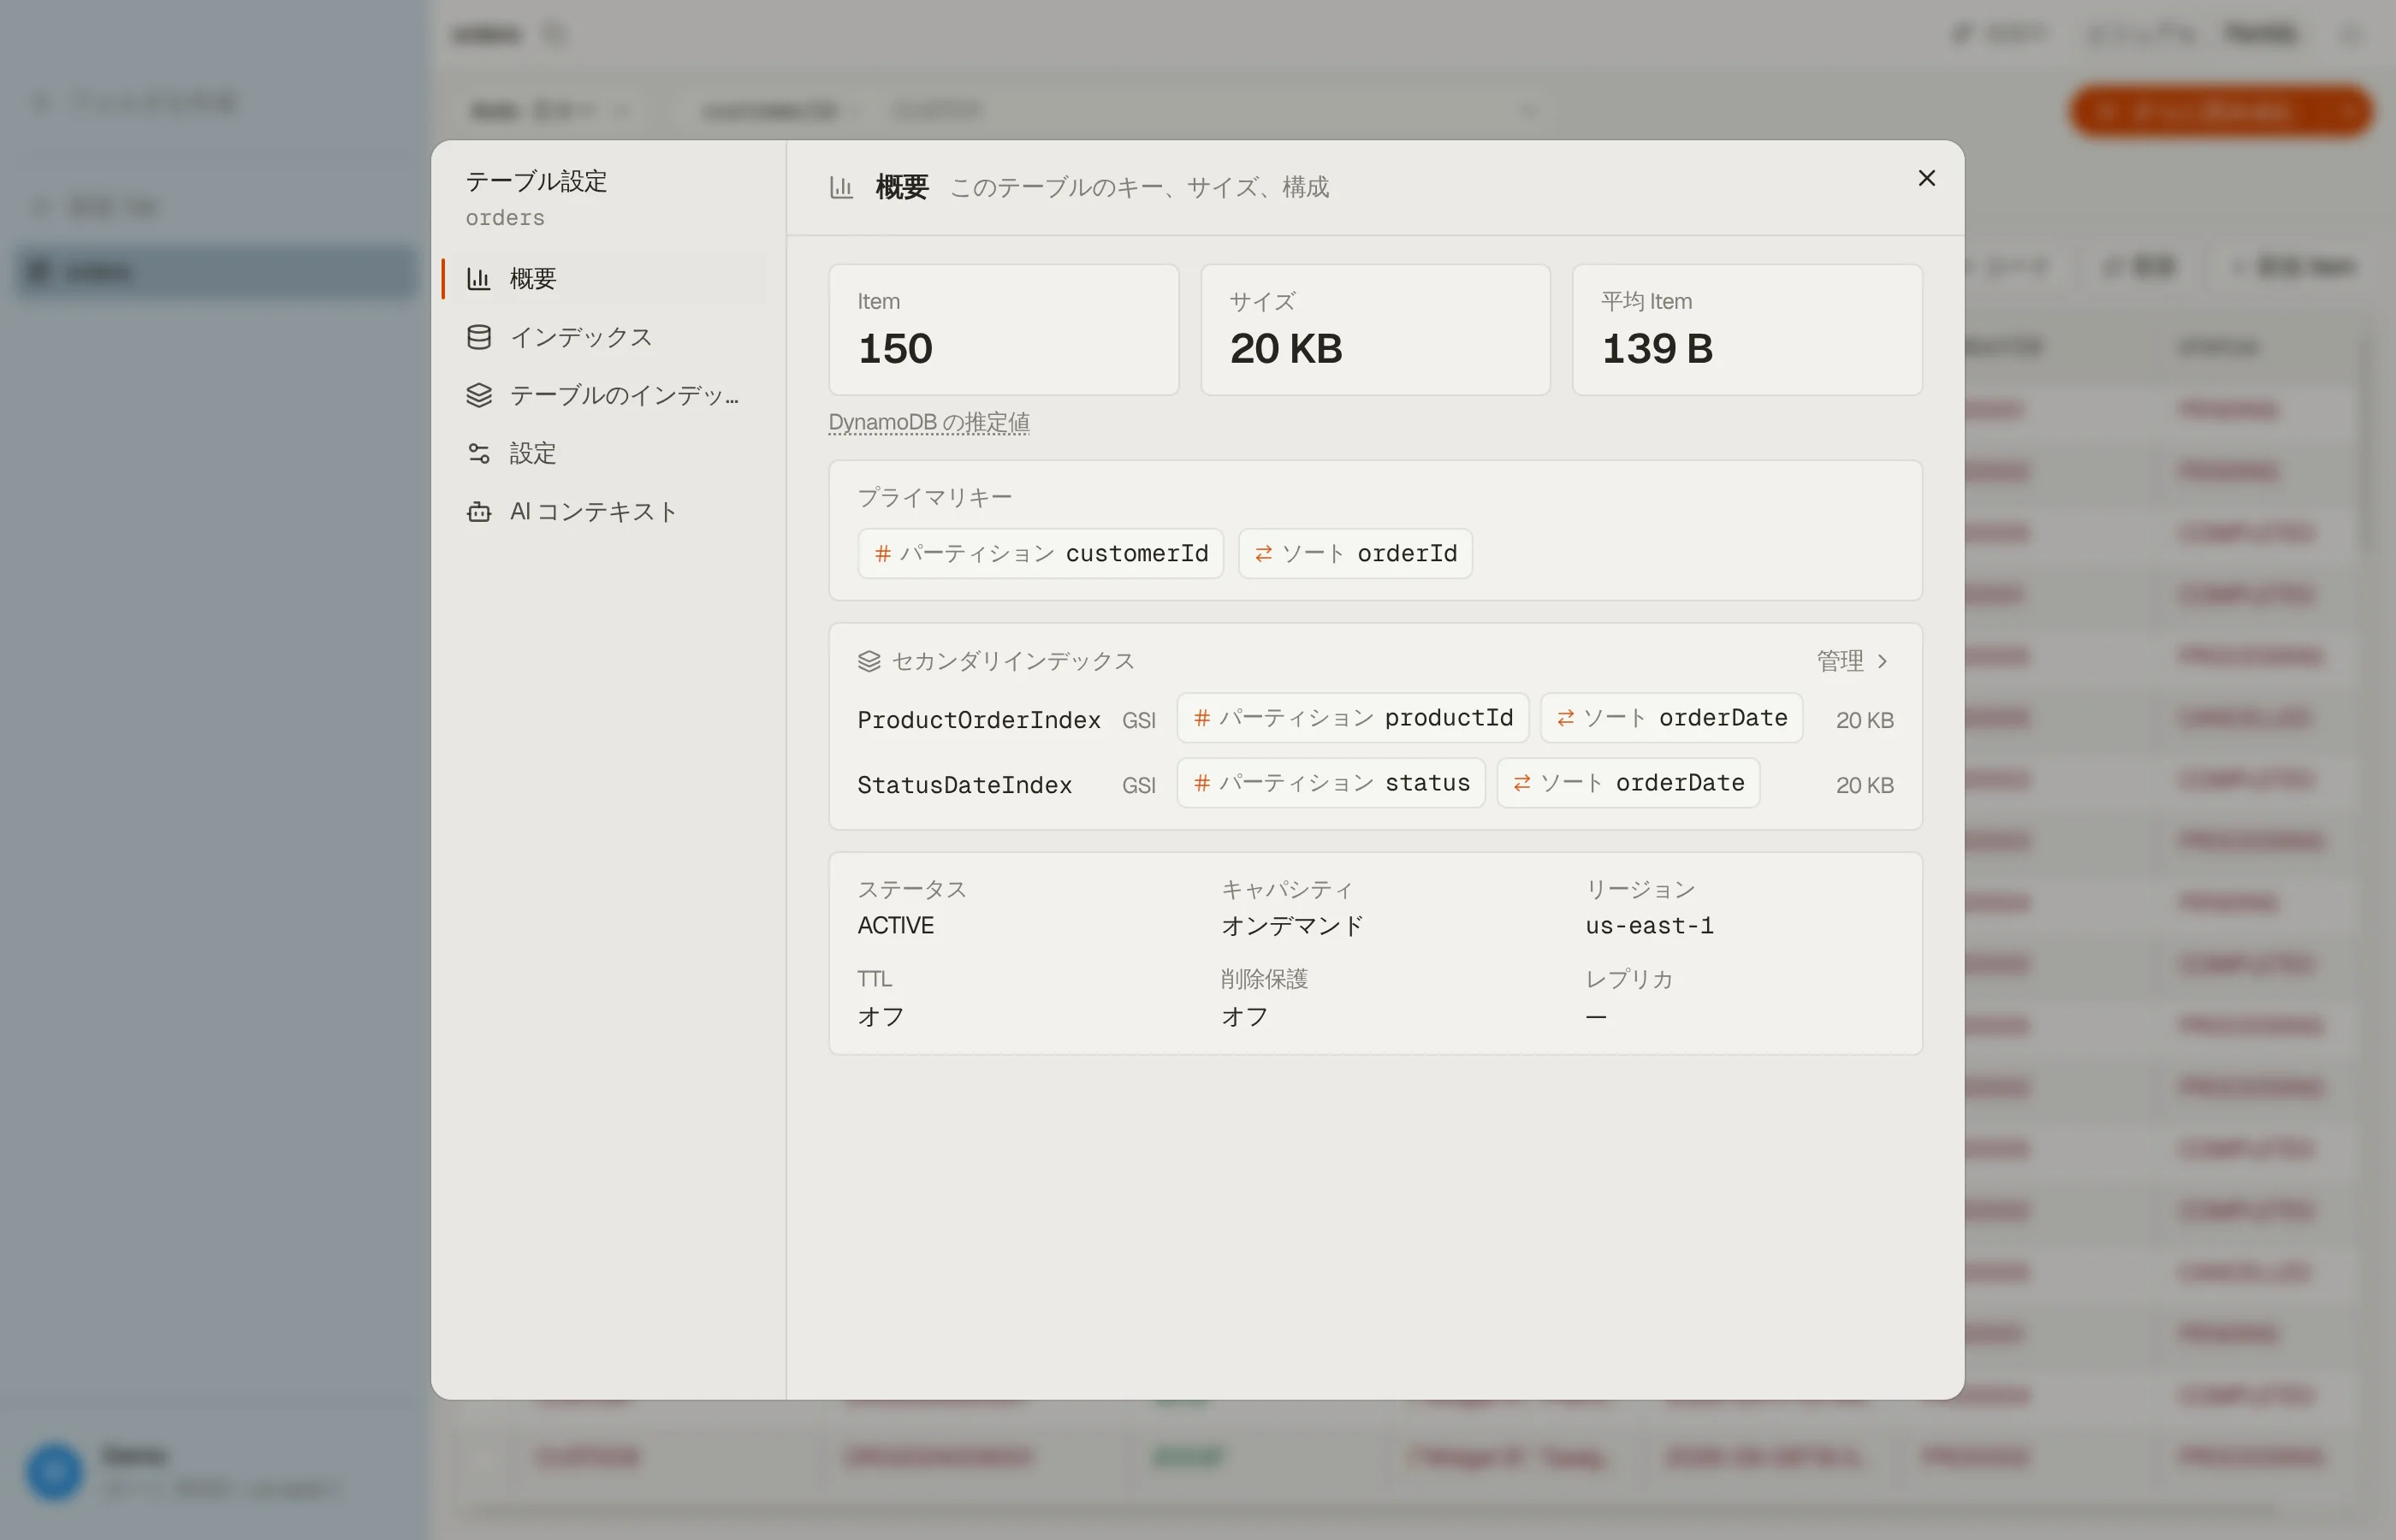

ビジュアルなフィルタービルダーにはインデックスピッカーがあり、条件を足すにつれて
Query 対 Scan を導出するので、フル Scan への高いフォールバックが何も走らせる前に見える。

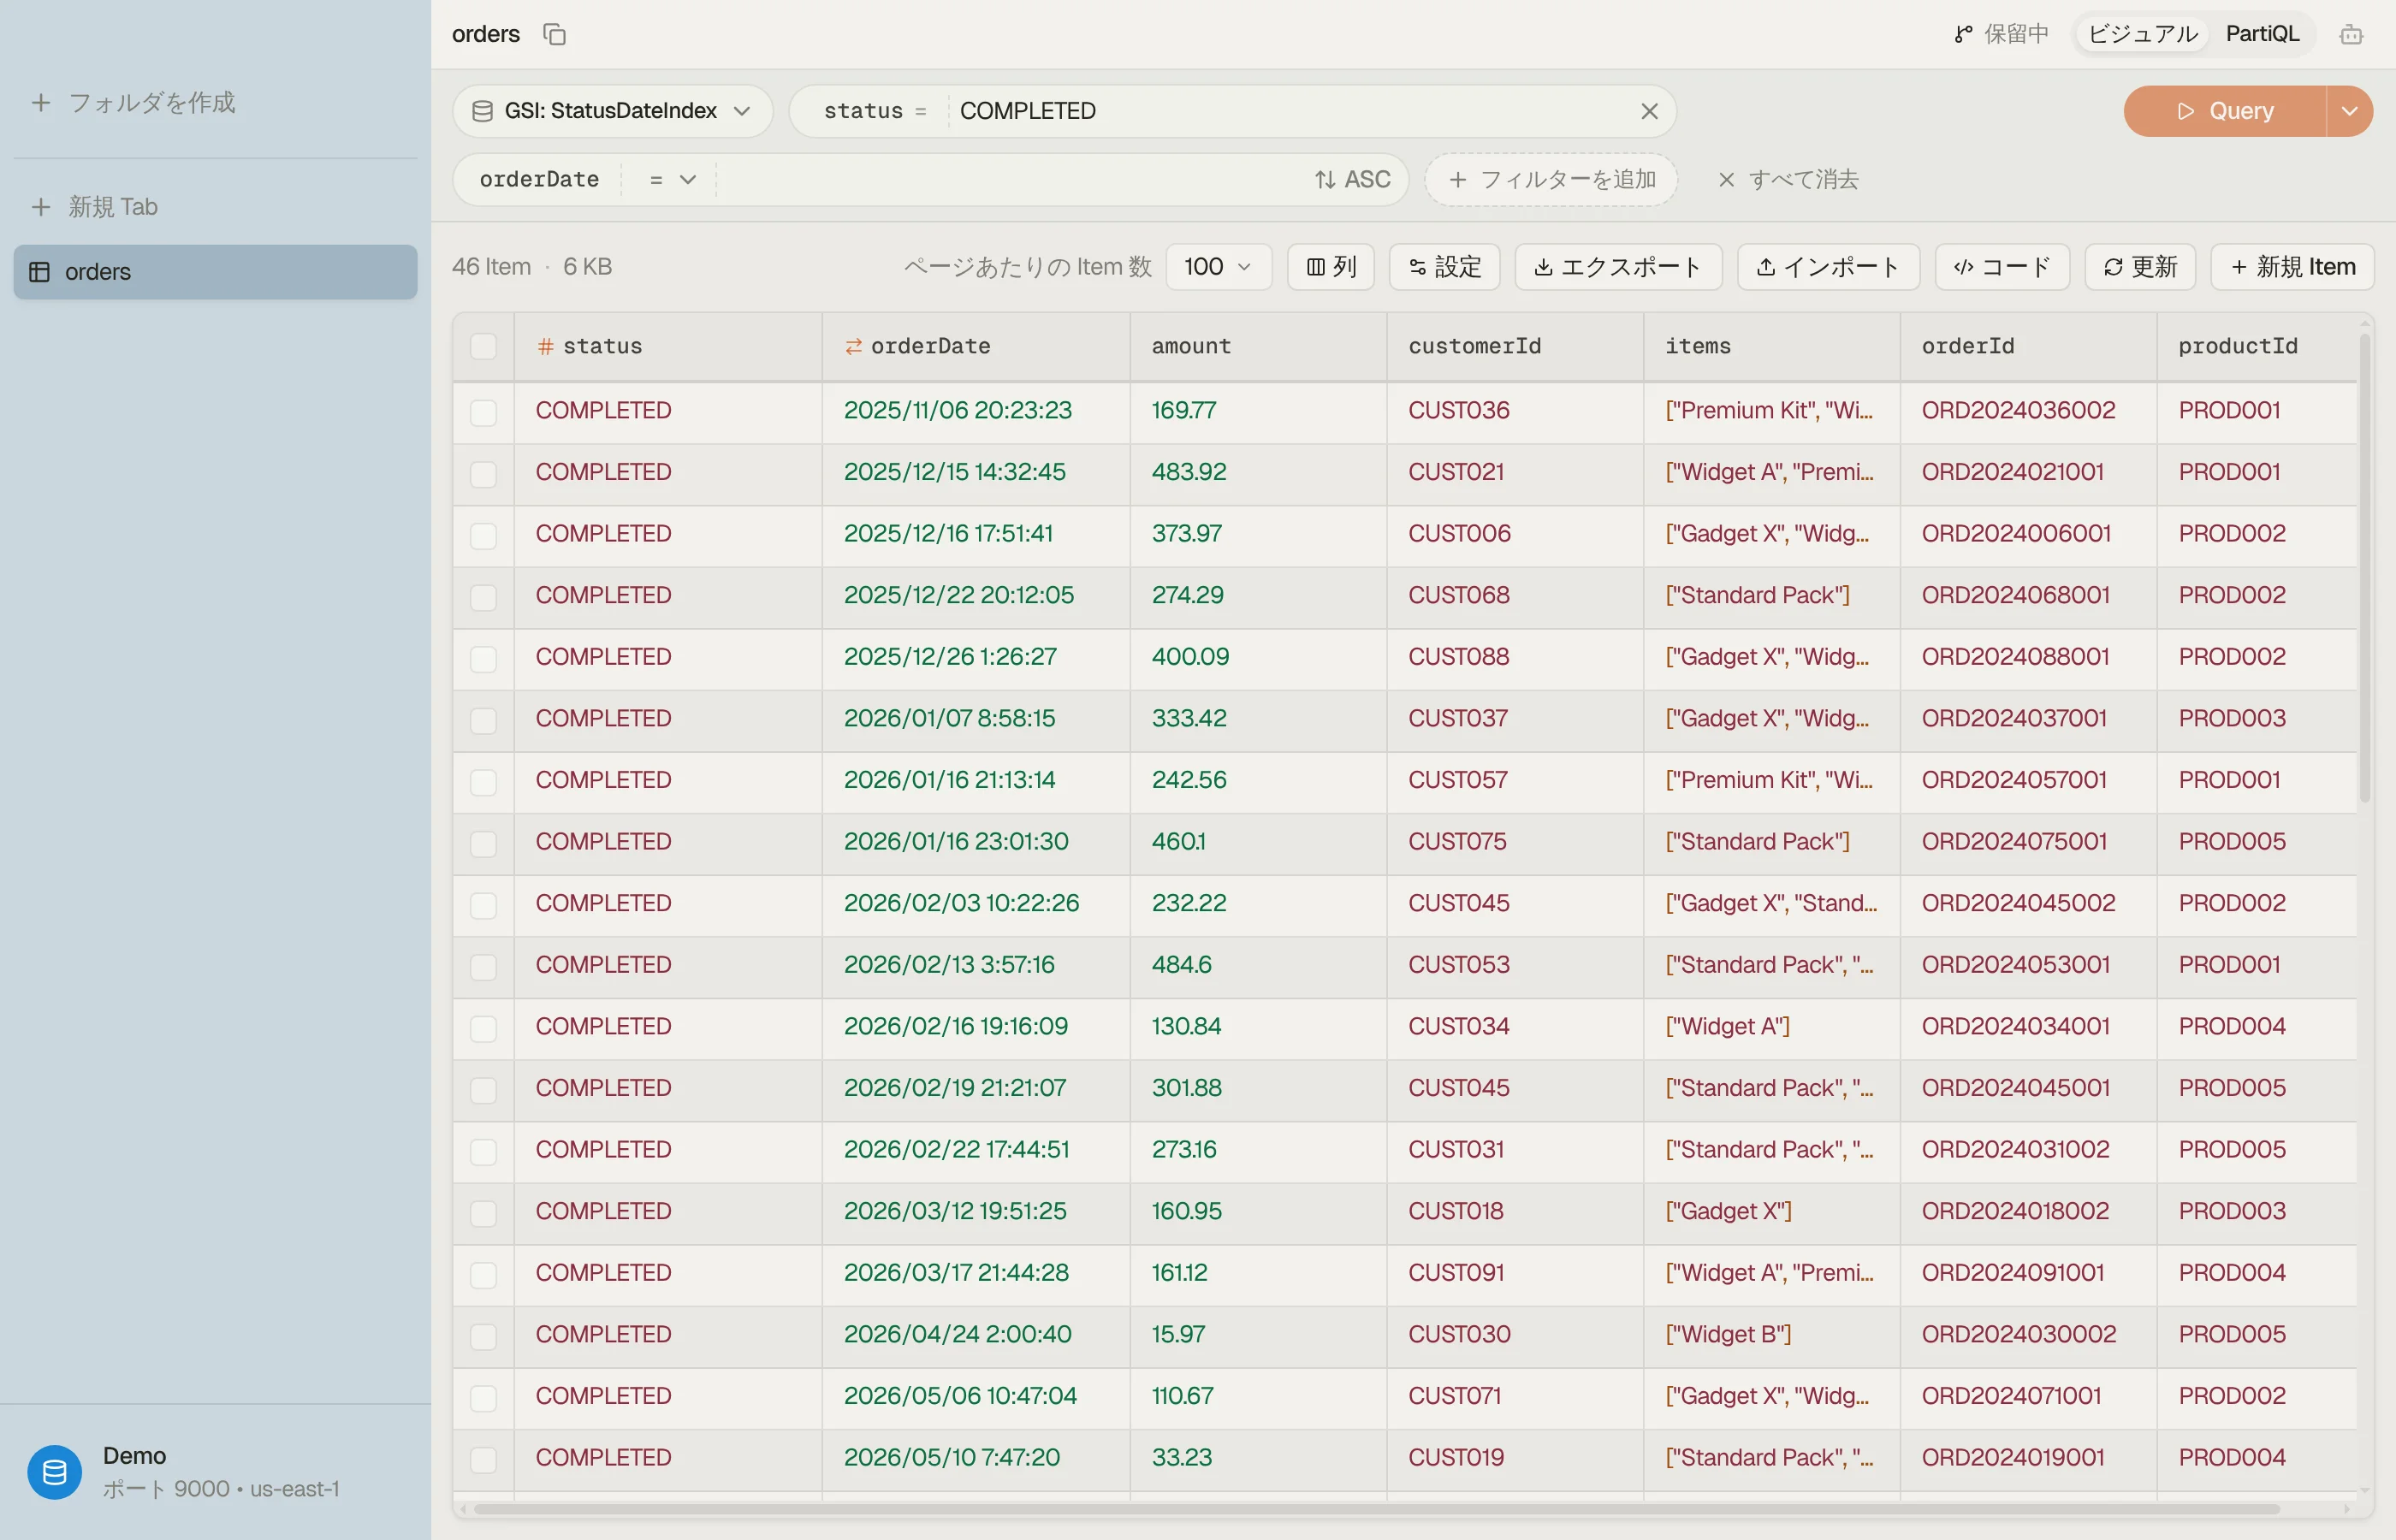

同じダイアログから GSI の作成と削除もできる。キースキーマを指定し、ALL /
KEYS_ONLY / INCLUDE の射影を選び、プロビジョンドテーブルではインデックスごとのスループットを設定し、CREATING/Backfilling ステータスを追う。ダイアログは
DynamoDB がインデックスを構築し終えるまでそれを再ポーリングする。
LSI は読み取り専用で一覧される。DynamoDB がテーブル作成時に固定するからだ。また既存の GSI は置き換えられるが編集はできない。テーブル管理は有料プランの機能で、トライアルにも含まれる。
DynoTable をダウンロードしてインデックスを直接調べてクエリし、シングルテーブル設計プランナー でアクセスパターンの一覧を、コミット前に PK/SK/GSI レイアウトへ変えよう。