DynamoDB のキーオーバーロード
SQL から来ると、列は永遠に1つの意味を持ちます。tickets.created_at は常に日付、
users.email は常にメールです。キーオーバーロードはそれを捨てます。パーティションキーとソートキーに pk、sk といった汎用的な名前を付け、各アイテム型がそれぞれ異なる意味をそこに流し込めるようにするのです。
そうすると、多数のエンティティ型が1つのテーブルと1つのキーの形を共有します。
DynamoDB のキーオーバーロードとは何ですか?
キーオーバーロードとは、多数のエンティティ型を pk/sk のような汎用的なキー名の下に1つのテーブルへ格納し、型を値にエンコードすること(USER#u_3001、INVOICE#2026-0014)です。そうすればユーザー、請求書、イベントが1つのパーティションを共有でき、ソートキーのプレフィックスによって1回の Query が begins_with で各エンティティを切り出せます。
- 汎用的なキー名、型付きの値: キーに
pk/skと名付け、エンティティ型を値に入れます。たとえばpk = "TENANT#acme"、sk = "USER#u_3001"です。 begins_withが見返り: ソートキーの型プレフィックスによって、1回のQueryがエンティティ全体を、あるいはその一部を、Scanもフィルターもなしに引き出せます。- 代償は可読性: 生の
pk/skのダンプは読みにくいものです。すべてのアイテムに明示的なentityType属性を書いておけば、エクスポート、Streams のコンシューマー、フィルターがプレフィックスを解析せずにそれで分岐できます。
汎用的な名前が具体的な名前に勝る理由
DynamoDB はテーブルごとに最大2つのキー属性しか与えず、Query は1つのパーティションキーしか対象にできません。ですからキーを userId と名付ければ、そのテーブルにきれいに置けるのはユーザーアイテムだけになり、それ以外はすべて userId を偽装するか、自前のテーブルに移すしかありません。
pk のような中立的な名前はどのエンティティにも縛られないので、ユーザー、請求書、監査イベントがすべて同じキー属性と同じテーブルを共有できます。これがシングルテーブル設計をクエリ可能にするものです。
マルチテナントの例
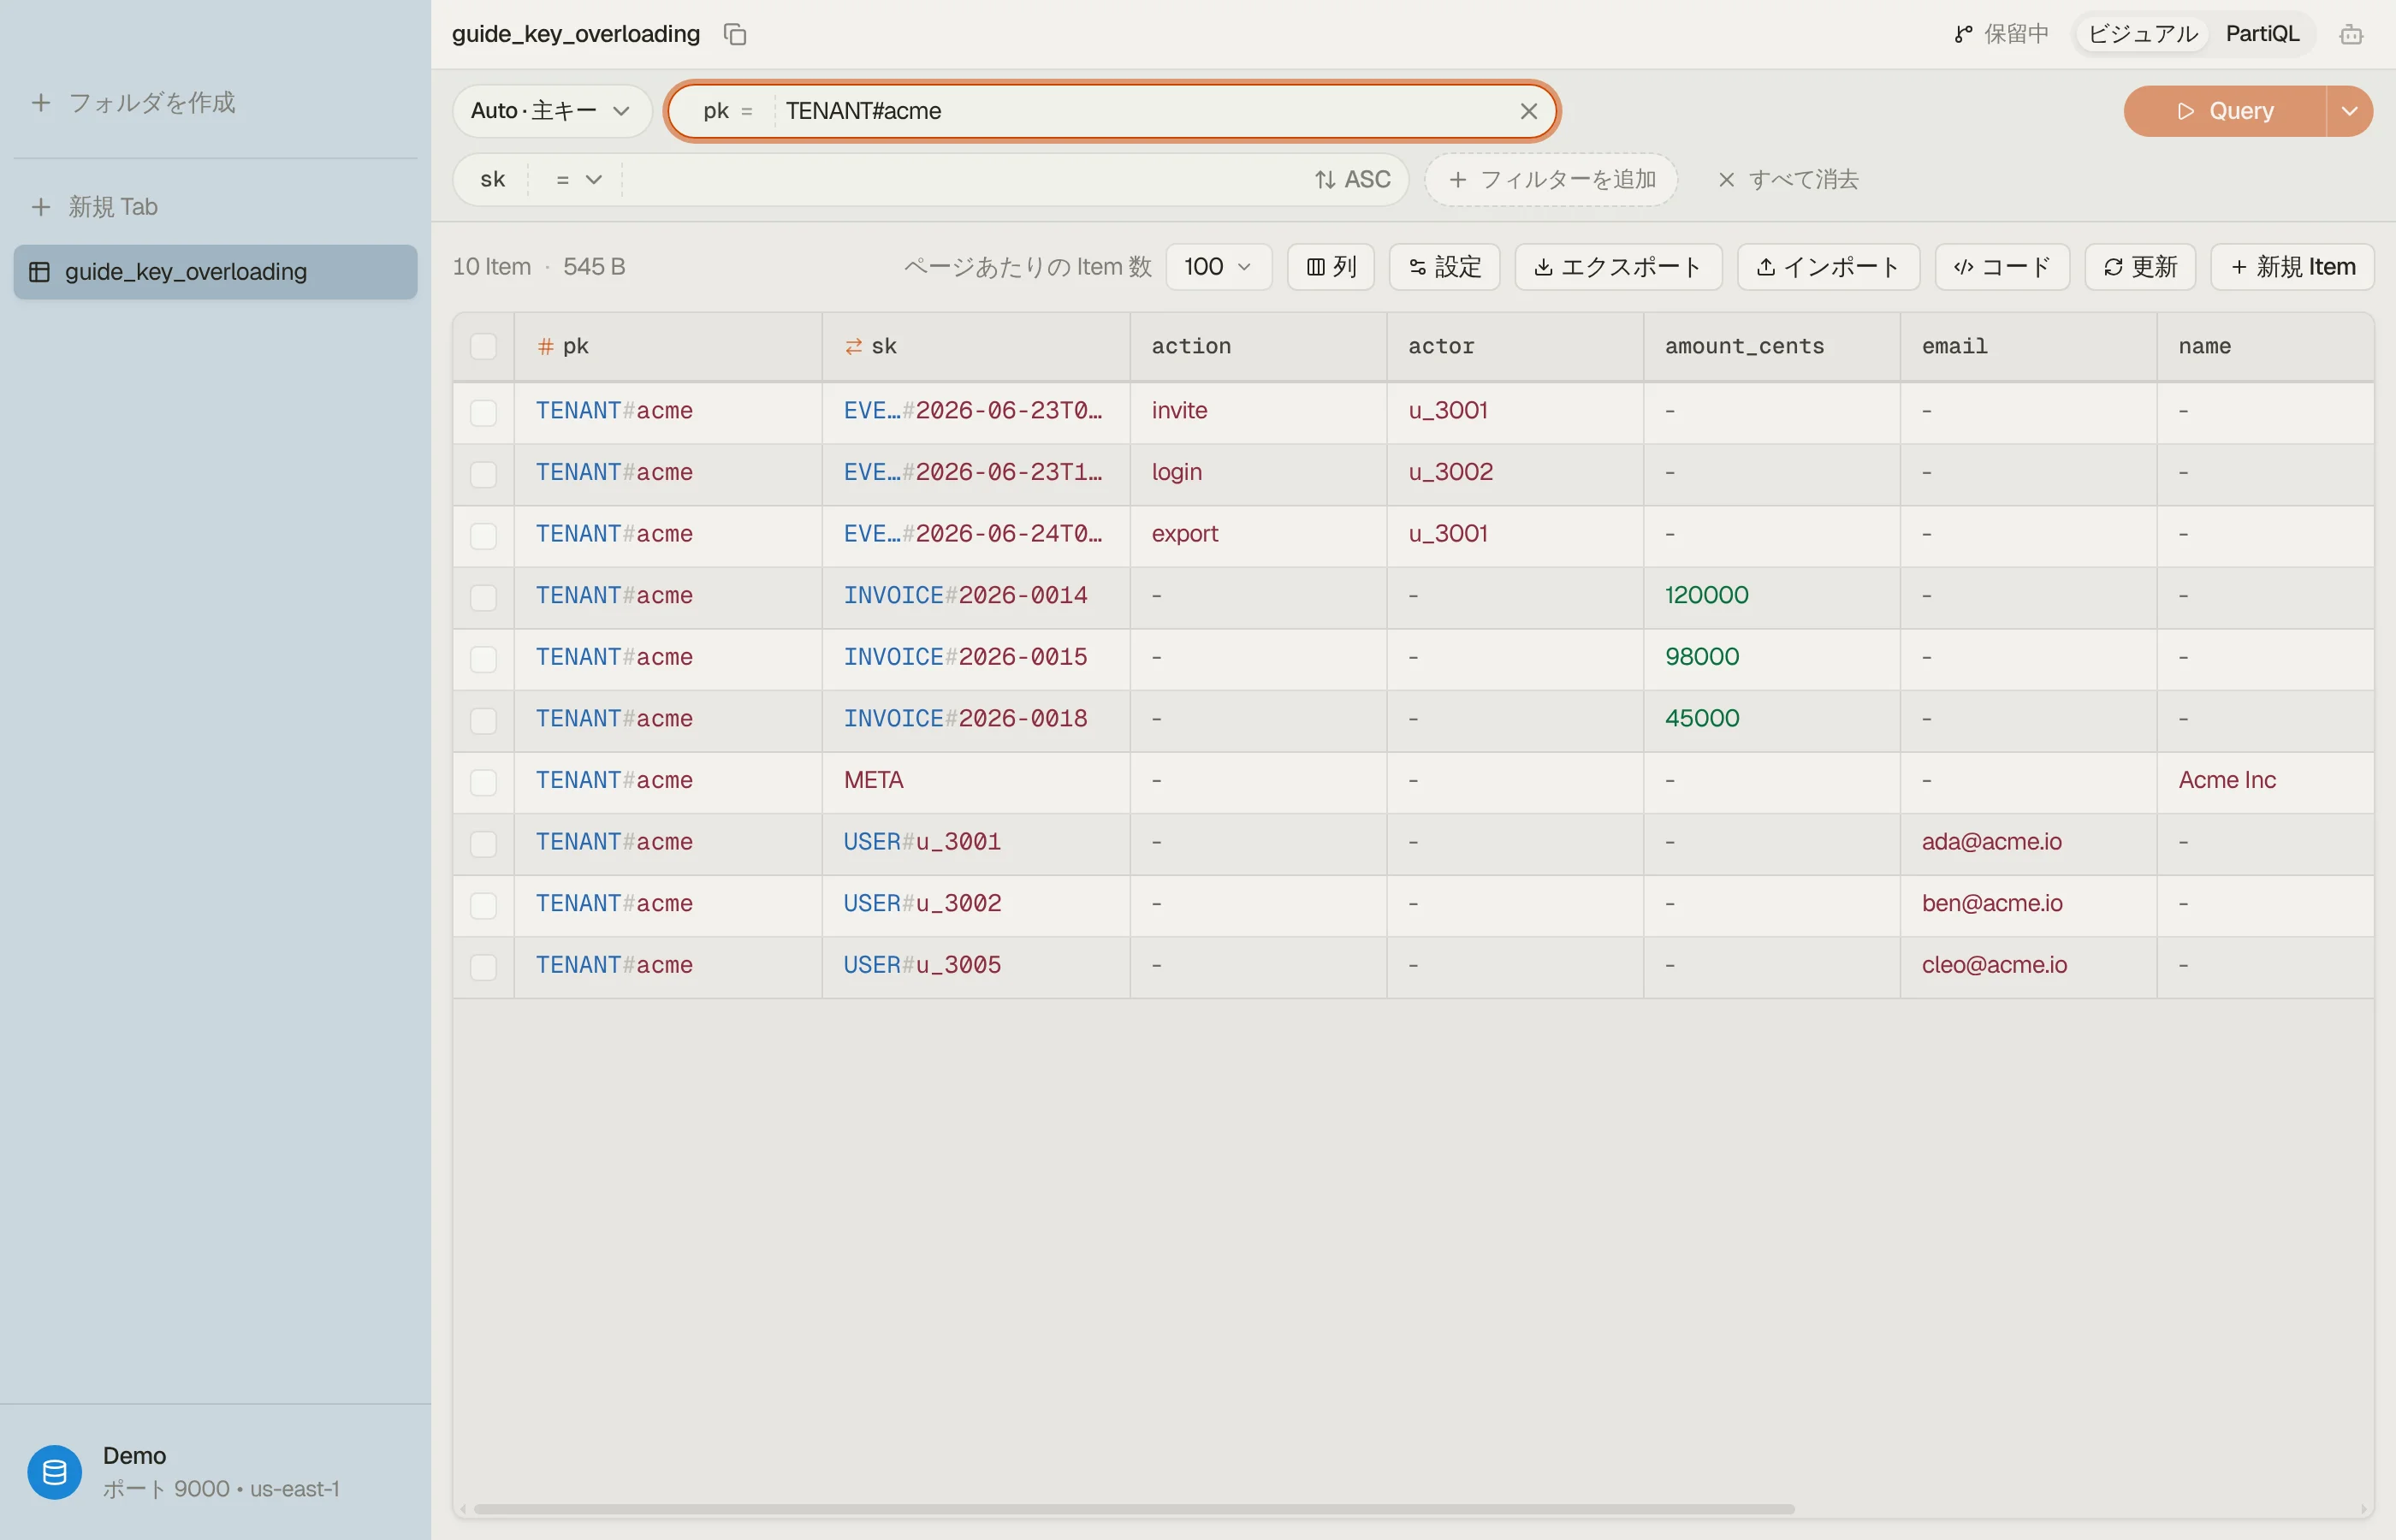
SaaS の請求プロダクトを運営しているとしましょう。各テナントにはメンバー、請求書、監査証跡があります。3つのテーブルの代わりに、すべてを1つに入れてキーをオーバーロードします。
| pk | sk | attributes |
|---|---|---|
| TENANT#acme | EVENT#2026-06-23T09:12Z | actor="u_3001", action="invite" |
| TENANT#acme | INVOICE#2026-0014 | amount_cents, status="paid" |
| TENANT#acme | INVOICE#2026-0015 | amount_cents, status="open" |
| TENANT#acme | META | name="Acme Inc", plan="team" |
| TENANT#acme | USER#u_3001 | email, role="admin" |
| TENANT#acme | USER#u_3002 | email, role="member" |
どの行も pk = "TENANT#acme" を共有するので、1つのアイテムコレクションを形成します。まとめて格納され、1つのキー条件で読み取れます。行はソートキーの順序で返るので、META
は請求書とユーザーの間に入ります。先頭にしたいなら #META と名付けてください。
ソートキーのプレフィックスがエンティティをグループ化し、順序付けます。
オーバーロードされたコレクションをクエリする
型がソートキーのプレフィックスに宿っているので、begins_with は何もスキャンせずにパーティションをエンティティ単位で切り出します。
Query pk = "TENANT#acme"  -- the entire tenant, every type
Query pk = "TENANT#acme" AND begins_with(sk, "USER#")  -- just members
Query pk = "TENANT#acme" AND begins_with(sk, "INVOICE#") -- just invoices支払うのは条件に一致したアイテムの分だけで、パーティション全体ではありません。フィルター付きのScanはその正反対で、後で捨てる行を読むために支払います。AWS はこれをキー条件と呼びます。データがパーティションを離れる前に、キーに対して実行されます。
テナントにユーザーが 200 人(各 2 KB)、監査イベントが 5,000 件(各 1 KB)あるとします。
USER# のクエリが読むのは約 400 KB で、強い整合性なら 100 読み取りユニット、結果整合性なら 50 読み取りユニットです。ユーザーを探す Scan は、すべてのテナントのすべてのアイテムを計測します。
Query の呼び出しは1回あたり最大 1 MB を返すので、テナント全体の読み取り(ここでは約 5.4 MB)には複数回の呼び出しが必要です。各レスポンスの LastEvaluatedKey を、それがなくなるまで次の ExclusiveStartKey として渡してください。
クエリするプレフィックスには必ず区切り文字を含めましょう。begins_with(sk, "USER#") は
USERGROUP# のアイテムを飛ばしますが、begins_with(sk, "USER") は両方に一致します。
USERS# のようなタイプミスは、エラーなしに何も返しません。
Expression Builder は KeyConditionExpression
と値のマップを生成し、クエリビルダーはページネーションのループを出力します。
インデックスもオーバーロードする
同じ手口はGSIにも当てはまります。汎用的なキー名(gsi1pk、gsi1sk)を与え、各エンティティに必要なものを書かせます。そうすれば1つのインデックスが、ベーステーブルには答えられないパターンに答えます。
| pk | sk | gsi1pk | gsi1sk |
|---|---|---|---|
| TENANT#acme | INVOICE#2026-0015 | STATUS#open | 2026-06-30 |
| TENANT#acme | INVOICE#2026-0014 | STATUS#paid | 2026-06-12 |
| TENANT#beta | INVOICE#2026-0099 | STATUS#open | 2026-06-25 |
これで Query gsi1 WHERE gsi1pk = "STATUS#open" は、すべてのテナントにまたがって未払いの請求書をすべて期日順で列挙します。ベーステーブルのテナント単位のキーでは提供できないクロスパーティションのビューです。
別のエンティティが gsi1 を自分なりの意味で再利用できる(たとえば
gsi1pk = "ROLE#admin")ので、1つのインデックスが複数の読み取りをカバーします。
2025年11月以降、GSI のキーは最大4つのパーティションキー属性と最大4つのソートキー属性から組み立てることもできるので、status と dueDate を STATUS#open という文字列ではなく、型付きのキー属性にすることもできます。それでも、複数のエンティティ型が1つのインデックスを共有するなら、オーバーロードは役に立ちます。
注意点が2つあります。1つ目に、STATUS#open はすべてのテナントで1つのキー値なので、請求書の作成、ステータスの変更、ダッシュボードの読み取りがすべて1つの GSI パーティションに集中します。毎秒数百件の書き込みを超えるなら、シャーディングしてください(STATUS#open#0 から #9)。ホットパーティションを参照してください。
2つ目に、GSI は結果整合性です。直前の書き込みを読み取りで確実に見る必要があるなら、ConsistentRead: true でベーステーブルを読んでください(pk/sk での GetItem、またはテナントに対する Query)。
シングルテーブル設計ツールで設計する
キーを確定する前に、エンティティ(Tenant、User、Invoice、Event)とそのアクセスパターンをシングルテーブル設計ツールに入力してみてください。ルールベースのツールで、あなた自身のパターンに対するオーバーロードの形を示してくれます。
「親の下のアイテムを一覧」のパターン(たとえばテナントごとのユーザー)は、子を親のパーティションに移します。pk = TENANT#<tenantId>、sk = USER#… です(ツールでは属性名が PK と
SK になります)。ベーステーブルでは提供できない各パターンは、汎用的な GSI1PK/GSI1SK キー上の GSI の提案になります。そのため「テナントをまたいだ未払いの請求書」を status に対する「別の属性で検索」として入力すると、INVOICE#STATUS#<status> が返ってきます。
出力は出発点として扱ってください。このツールはテナント自身のアイテムに
sk = TENANT#<tenantId> を与えますが、このページでは META を使っています。また、ホットなステータスキーをシャーディングしてはくれないので、ローンチ前に上で説明したシャーディングを適用してください。
DynoTable でやってみる
生のオーバーロードされたキーは読みにくいものです。INVOICE#2026-0015 と
EVENT#2026-06-23T09:12Z はフラットなリストでは混ざり合ってしまいます。DynoTable は複合キーをセグメントにデコードし、プレフィックスを右クリックすれば、ビューをそのエンティティ型に絞り込めます。


落とし穴
- 区切り文字は一度で決める。
#が慣例です。エンティティ間で#と:を混ぜると、何も警告しないままbegins_withが壊れます。移行する場合、ベーステーブルのキーはUpdateItemできません。新しいキーをPutし(attribute_not_exists(pk)付きで)、古いキーをDeleteするTransactWriteItemsで、各アイテムを書き直してください。gsi1pkのような GSI のキー属性は普通の属性なので、UpdateItemでその場で変更できます。書き直しが終わったら、読み取り側を新しいプレフィックスに切り替えましょう。 - 範囲演算が必要な値をオーバーロードしない。
INVOICE#2026-0015というソートキーは数値ではなく辞書順でソートされます。id をゼロ埋めし、文字列順が意図する順序に一致するよう ISO-8601 の日付を使いましょう。 - キーの前に読み取りを設計する。 オーバーロードは、列挙済みのアクセスパターンに応えるものです。まず上の設計ツールにそれらを通し、まだ読み取りが分からないならシングルテーブル設計を参照してください。
- プレフィックスの名前空間を予約する。 この例の下の表のような、プレフィックスの短い登録簿を維持しましょう。そうすれば新しいエンティティ型が
begins_withの下で既存のものと衝突しません。
| エンティティ | ソートプレフィックス | SK の例 | クエリのスライス |
|---|---|---|---|
| イベント | EVENT# | EVENT#2026-06-23T09:12Z | 降順読み取りによる時系列の末尾 |
| 請求書 | INVOICE# | INVOICE#2026-0015 | begins_with(sk, "INVOICE#") |
| テナントのメタ | META | META | 単一アイテムの取得 |
| ユーザー | USER# | USER#u_3001 | begins_with(sk, "USER#") |
代表的なアイテムのサイズをアイテムサイズ計算機で見積もり、DynoTable をダウンロードして、オーバーロードされたキーをデコードした状態でテナントのコレクション全体を閲覧しましょう。