DynamoDB のアイテムコレクション
アイテムコレクション とは、テーブル(またはインデックス)内で同じパーティションキー の値を共有するすべてのアイテムの集合です。誰かが宣言するものではなく、キースキーマから自然に生じます。
2つのアイテムが同じパーティションキーを持った瞬間、それらはコレクションを形成し、
DynamoDB はコレクションを1回の Query でまとめて読み取らせてくれます。正しく設計すれば関連するアイテムが1回のラウンドトリップで返ってきます。間違えると Scan から抜け出せなくなります。
DynamoDB のアイテムコレクションとは?
- コレクションとは「同じパーティションキー」です。 同じパーティションキーの値を持つアイテムはまとめて格納され、ソートキー で並べられます。
- これは1回の
Queryの単位です。Queryは1つのコレクションの中を読み、Scanはすべてのパーティションを歩きます。 - 複数のアイテムタイプを混在させられます。 親アイテムとその子がキーを共有できるので、
1回の
Queryでプロフィールとその履歴をまとめて返せます。 - ハードな制限は1つだけで、LSI がある場合に限ります: LSI のあるテーブルのコレクションは 10 GB が上限です。LSI がなければ、DynamoDB はコレクションを複数のパーティションに分割できます。
問題: 関連するアイテムをまとめて読む
各車両が数秒ごとにテレメトリ(速度、冷却水温度、燃料残量)をストリーミングする車両群を運用しているとします。支配的な読み取りは、車両 V-7741 について「車両のプロフィールと最近の測定値をくれ」です。
SQL から来ると、vehicle_id 列にインデックスを張り、プランナに仕事をさせるでしょう。素朴なキーバリューストアは各測定値を孤立したレコードとして扱うので、同じ問いはテーブル全体をフィルタ付きでスキャンすることを意味し、車両群が増えるほど高くつきます。
DynamoDB の答えは、「1台の車両に関するすべて」を 物理的に グループ化された、直接アドレス指定可能なものにすることです。そのグループ化がアイテムコレクションです。
DynamoDB はコレクションをどう格納するか
DynamoDB は各アイテムをそのパーティションキーのハッシュによってパーティションへルーティングし、同じパーティションキーを持つアイテムをまとめて、ソートキー で並べて格納します。AWS はそのグループを アイテムコレクション と呼んでいます。
コレクションは1つのパーティションで始まります。LSI がなければ、DynamoDB は大きく、またはホットになったコレクションを必要なだけ多くのパーティションに分割します(AWS ドキュメント)。 LSI はコレクションを1つのパーティションに固定します。それが以下の 10 GB 上限の理由です。
コレクションはソートされているので、Query はその連続した範囲を読み、読んだアイテムの分だけ課金されます。
コレクションを形成するには 複合プライマリキー、つまりパーティションキー と ソートキーが必要です。パーティションキーだけでキー付けしたテーブルはキー値ごとに 1アイテムしか持たないので、集めるものがありません。そのキーの選び方は複合プライマリキーのガイド で扱っています。
具体例: 車両 → テレメトリ測定値
テレメトリストリームを複合キーでモデル化します。パーティションキーが車両を識別し、ソートキーはプロフィールなら META、各測定値ならタイムスタンプです。測定値は古い順に並びます。最新を先頭にするには ScanIndexForward=false を渡します。
| PK (vehicleId) | SK (recordedAt) | attributes |
|---|---|---|
| VEH#V-7741 | META | plate, model, depotCode |
| VEH#V-7741 | TS#2026-06-23T09:00:01Z | speedKph, coolantC, fuelPct, depotCode |
| VEH#V-7741 | TS#2026-06-23T09:00:06Z | speedKph, coolantC, fuelPct, depotCode |
| VEH#V-7741 | TS#2026-06-23T09:00:11Z | speedKph, coolantC, fuelPct, depotCode |
| VEH#V-7742 | META | plate, model, depotCode |
| VEH#V-7742 | TS#2026-06-23T09:00:02Z | speedKph, coolantC, fuelPct, depotCode |
ここには2つのコレクションが存在し、車両ごとに1つです。META アイテムと V-7741 のすべての測定値が1つのコレクションを形成し、V-7742 のアイテムが別のコレクションを形成します。各測定値は車両のデポも記録しており、後述のインデックスのセクションはそれを前提にしています。
META はどの TS#... の値よりも前にソートされるので、PK = "VEH#V-7741" に対する単一の Query が、車両のプロフィール と その測定値をまとめて返します。これが シングルテーブル設計 の核心にある、親子パターンです。
各ボックスが1つのアイテムコレクションです。同じパーティションキーで、アイテムはソートキーで並んでいます。Query はちょうど1つのボックスを読みます。
コレクションにクエリする
コレクションは複数のアイテムタイプを保持できるので、どれを返すかを選ぶのがソートキーの条件です。測定値だけを新しい順に読むには:
# Query
KeyConditionExpression   vehicleId = :v AND begins_with(recordedAt, :ts)   # :ts = "TS#"
ScanIndexForward         false        # newest first
ソートキーの条件を外すと、同じ Query がプロフィールとすべての測定値を返します。
recordedAt = "META" ならプロフィールだけを取得します。時間ウィンドウ(ソート可能なタイムスタンプに対する BETWEEN)と 1 MB を超えるページングは複合プライマリキーのガイド で扱っています。
これらのキー条件を手で組み立てるのは面倒です。
DynamoDB Expression Builder は
KeyConditionExpression、ExpressionAttributeNames、ExpressionAttributeValues を生成するので、予約語やプレースホルダに噛まれません。
インデックス上のコレクション
セカンダリインデックスは 独自の キースキーマを持つので、独自の アイテムコレクションを形成します。
すべての測定値が depotCode を持っているので、depotCode(パーティション)と
recordedAt(ソート)でキー付けしたグローバルセカンダリインデックスは、デポ DEP-LON-3
のすべての測定値を1つのインデックスコレクションに集めます。ベーステーブルにはさばけない読み取りです。
depotCode = :d AND begins_with(recordedAt, :ts) と ScanIndexForward=false でクエリすれば新しい順になります。depotCode を持たないアイテムはインデックスに入らないので、それを各測定値にコピーしておくことが、この読み取りを成り立たせています(スパースインデックス)。
だからインデックスのタイプが重要なのです。それが、どんなコレクションを形成できるか、それらがどう振る舞うかを決めます。トレードオフは GSI と LSI を参照してください。
ローカルセカンダリインデックス(LSI) はベーステーブルのパーティションキーを共有するので、そのエントリはベースのアイテムと同じコレクションに存在し、それが以下のハードな制限を生みます。
噛んでくる制限
キーの形を決める制約が2つあります。
10 GB の LSI 制限。 ローカル セカンダリインデックスのあるテーブルでは、1つのアイテムコレクション(1つのパーティションキーに対するベースアイテムと LSI エントリ)は 10 GB を超えられません。それを超えて成長させる書き込みは
ItemCollectionSizeLimitExceededExceptionで失敗します。LSI が ない テーブルには、そのような上限はありません。
上限が近づくのを把握するには、書き込みで
ReturnItemCollectionMetrics: "SIZE"を指定し、 LSI のドキュメントが勧めるように、コレクションの推定サイズが約 8 GB を超えたらアラームを出します。上限に達したら、そのコレクションから不要になったアイテムを削除するか、履歴を新しいテーブルや S3 に移します。LSI はテーブルが存在する限り残るので、追記のみのテレメトリは最初から GSI か、時刻でバケット化したパーティションキーに載せるべきです。
ホットキー。 分割では1つのアイテムや、
TS#…のように増え続けるソートキーの先端を分散できないので、ホットな車両やデポには書き込みシャーディングが必要です。方法は ホットパーティション で扱っています。
DynoTable で見る
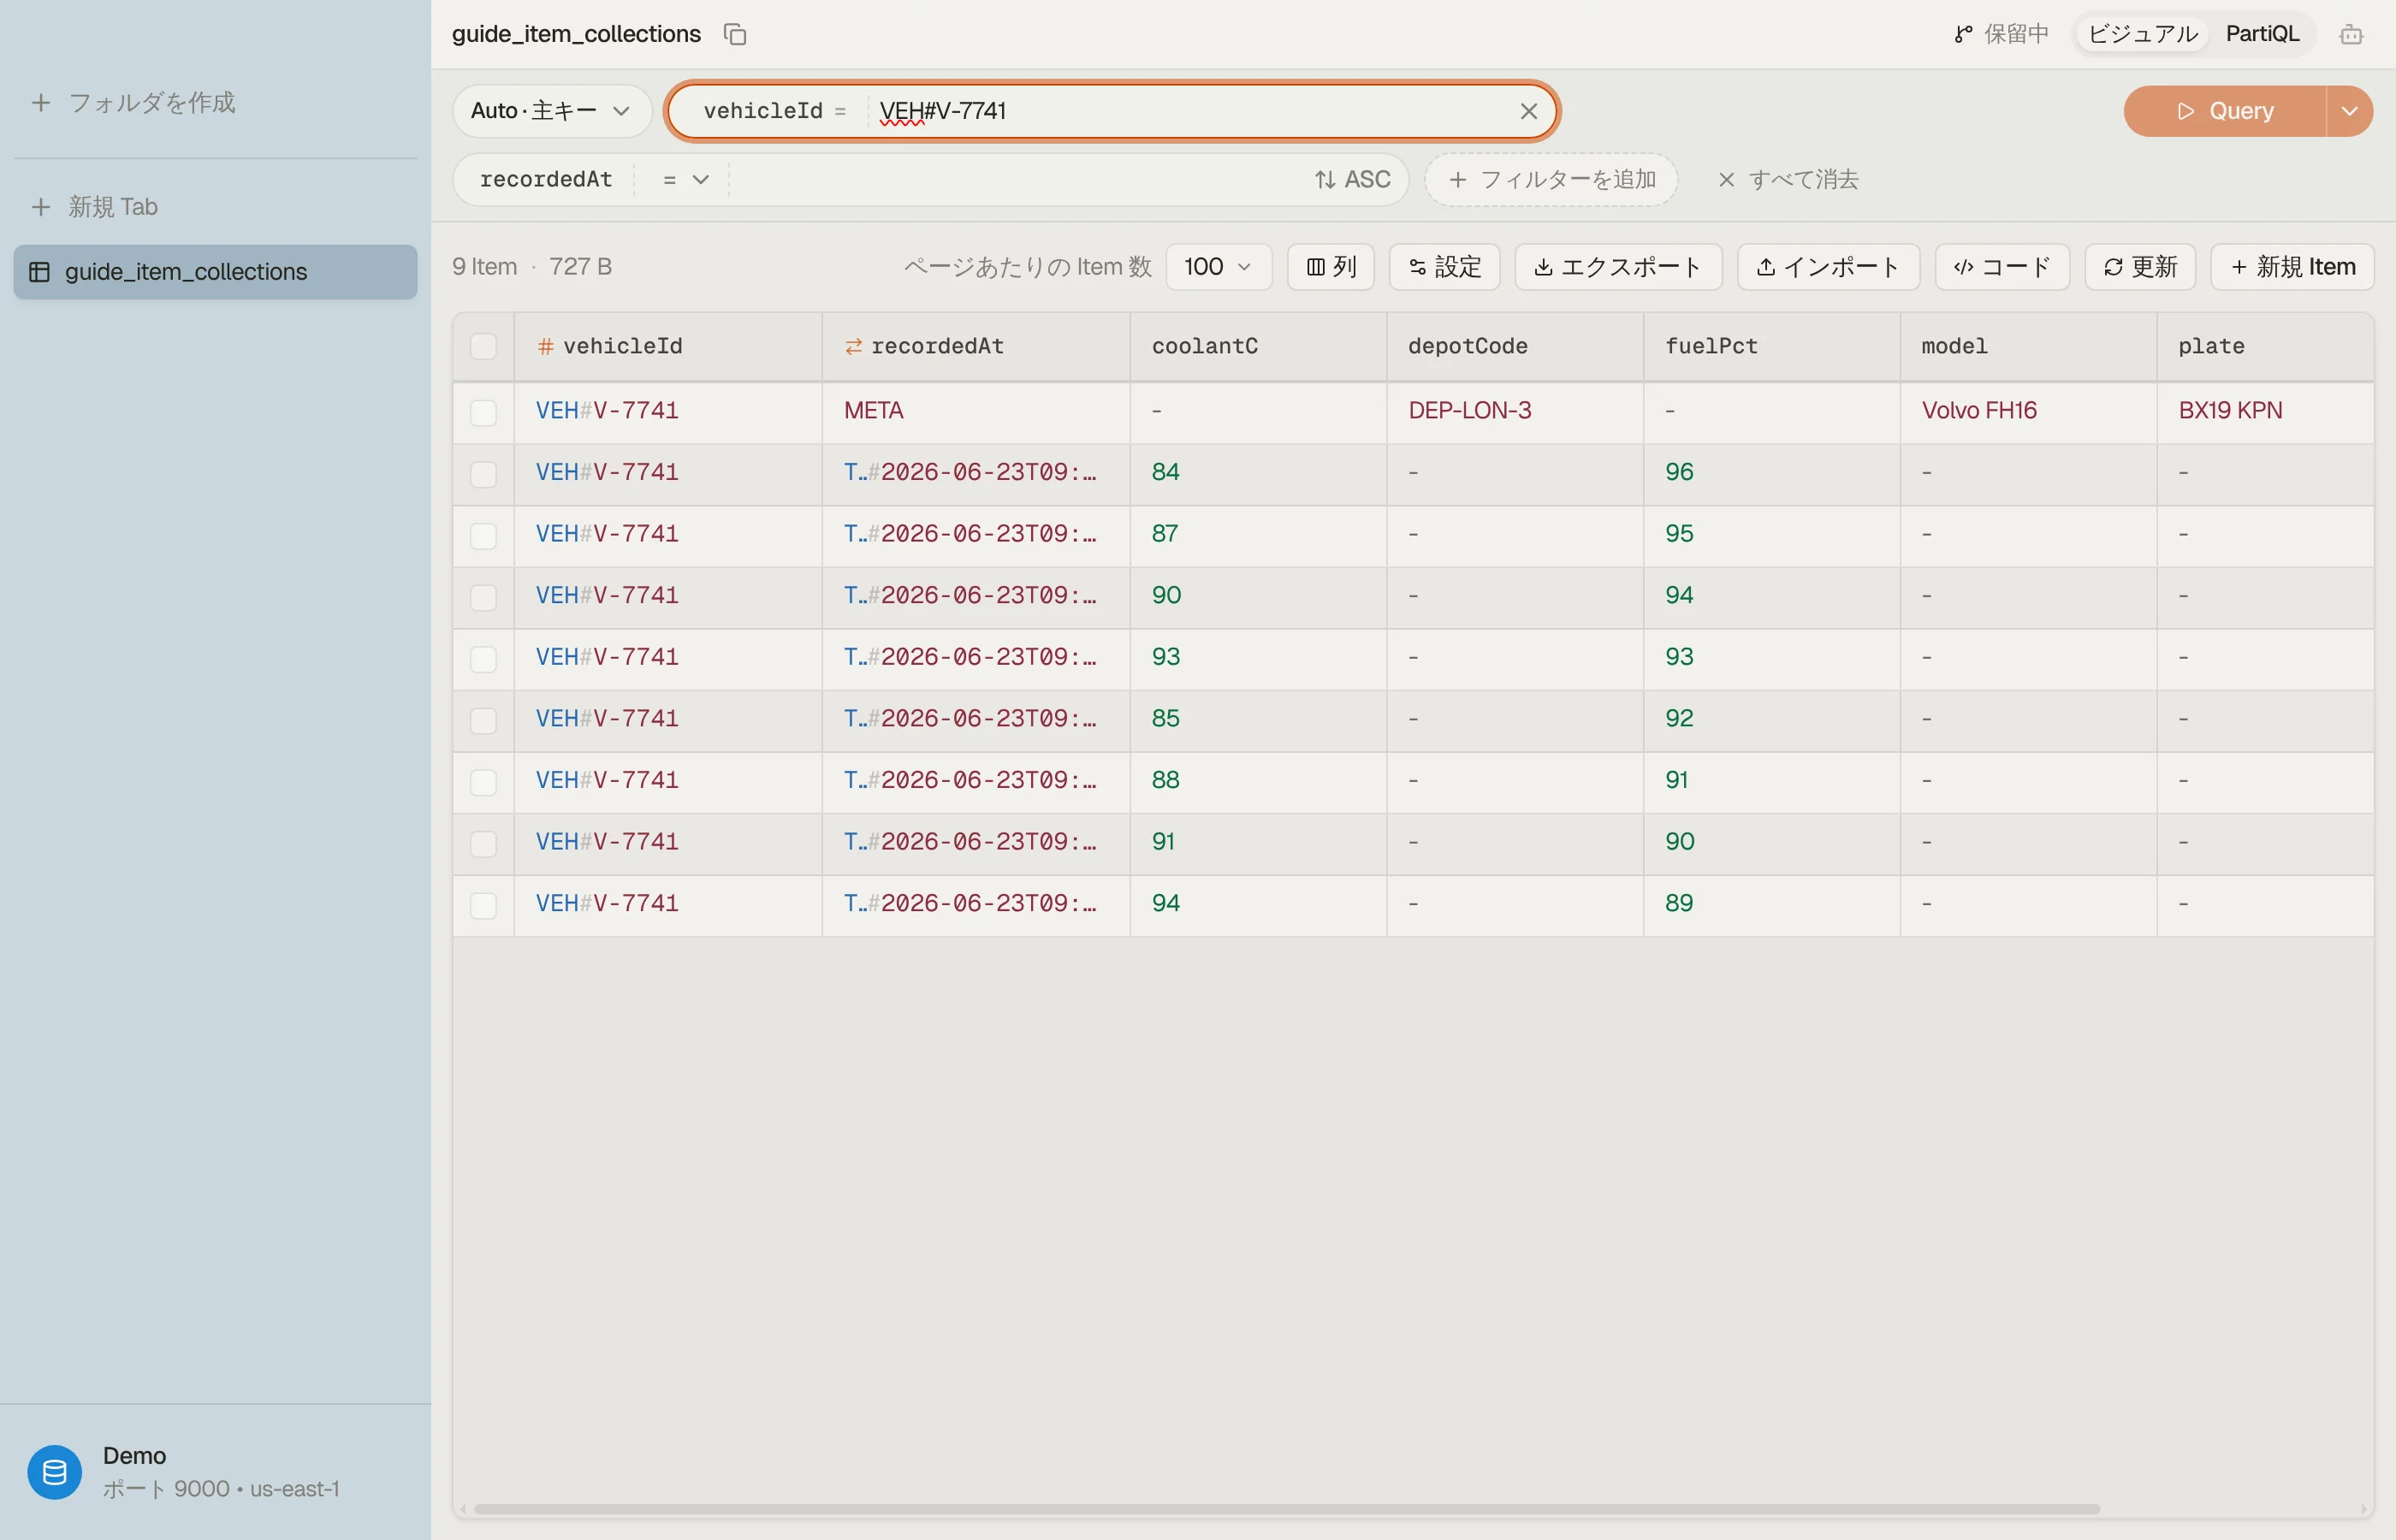
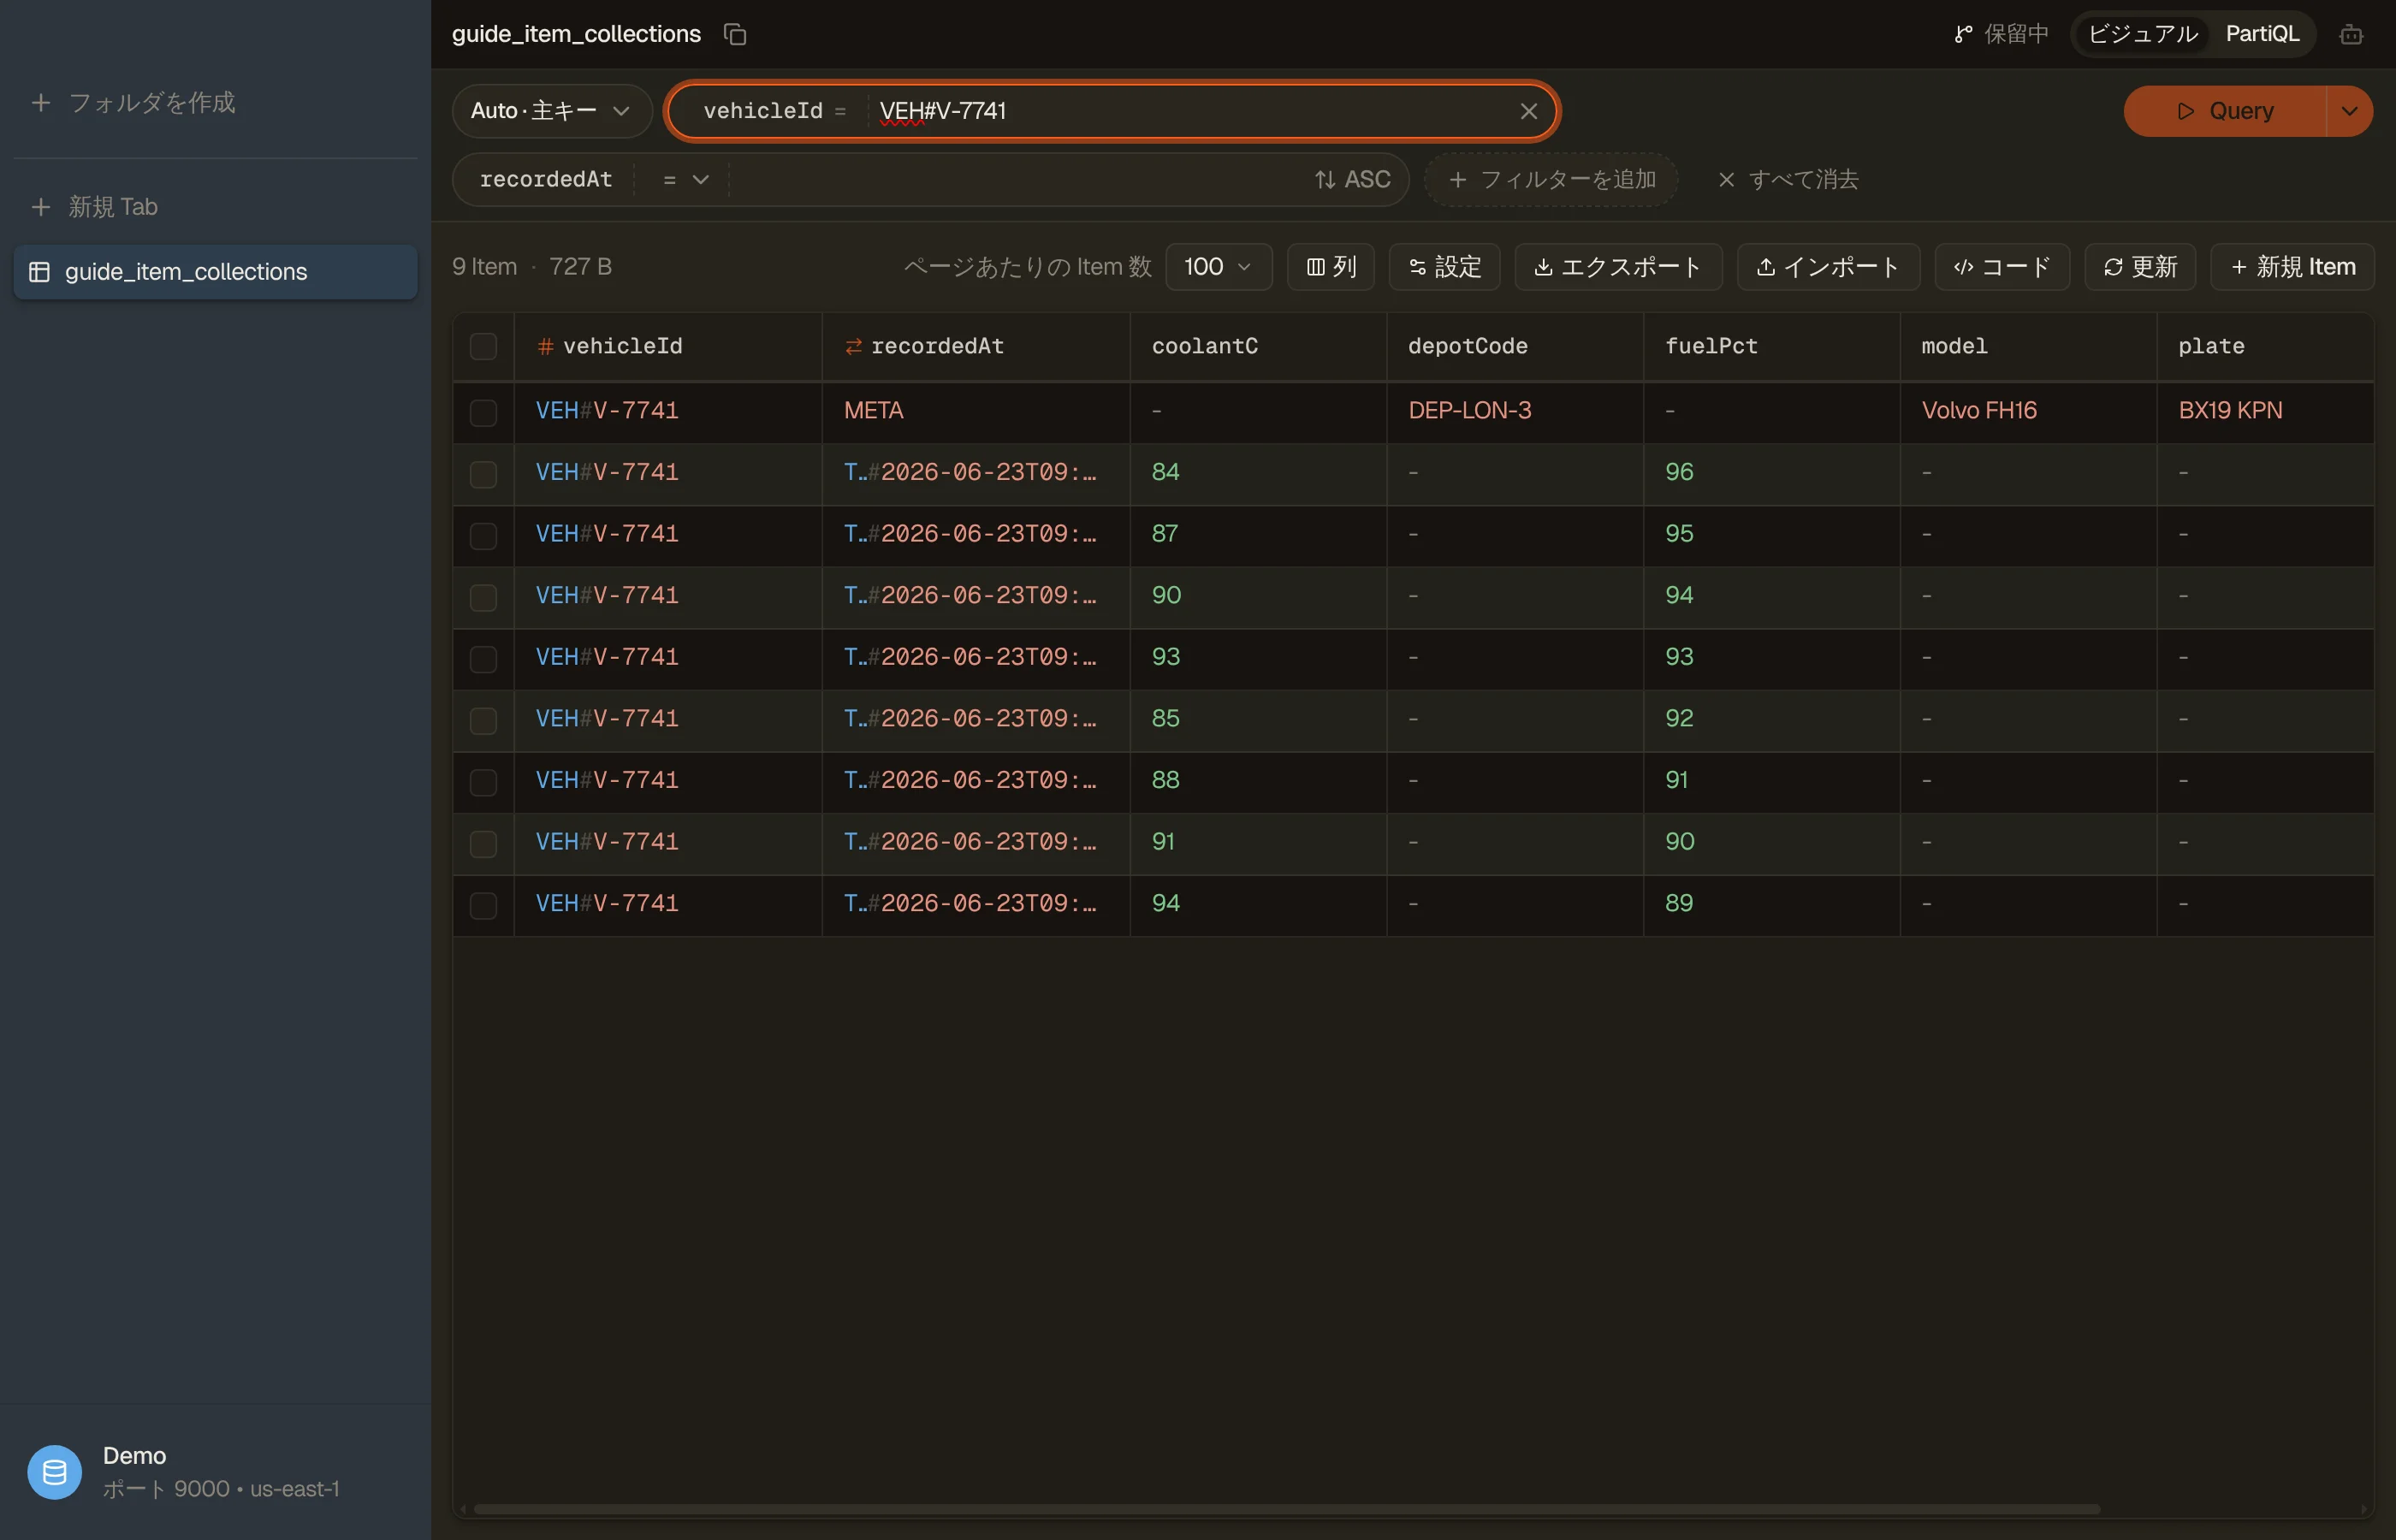
コレクションの直感を養う最速の方法は、実物を見ることです。DynoTable では、1つのパーティションキーに対する Query がコレクションをソートキー順に一覧表示します。META
アイテムがタイムスタンプ付きの測定値のすぐ前に、画面上に並びます。


落とし穴と次のステップ
- ソートキーがなければ、コレクションもありません。 パーティションキーのみのテーブルはアイテムをグループ化できず、そのキースキーマは変更できません。グループ化する属性とソート用の属性をキーにした GSI を追加するか、新しいテーブルに移行します(移行)。
- LSI コレクションを際限なく成長させないこと。 追記のみのストリームは、10 GB の上限があるため、LSI ではなく GSI(または時刻でバケット化したパーティションキー)に属します。
- パーティションキーを分散させること。 カーディナリティの低いキーは少数のコレクションにトラフィックを積み上げます。パーティションごとの制限は物理パーティション で説明しています。
ScanではなくQueryに手を伸ばすこと。 コレクションは、関連するアイテムを1回の的を絞ったQueryで読めるように存在します。Query と Scan を参照してください。
自分のキースキーマをスケッチし、実際のパーティションキーに対して Query を実行して、コレクションが順序どおりに返ってくるのを見てください。DynoTable をダウンロードして、テーブルのコレクションを直接探索しましょう。