AIでDynamoDBをクエリする方法(自然言語)
「先週のオープンなチケットを見せて」は、頭の中では一行ですが、ワイヤ上ではプレースホルダーマップ付きのKeyConditionExpressionです。
DynamoDBのAPI自体には自然言語のエンドポイントが存在しません。すべてのリクエストは依然として式かPartiQLです。AIはツーリングの層にあり、あなたの意図をそれらに翻訳します。
その翻訳が役に立つか害になるかは、たった1つのことで決まります:モデルがあなたの実際のスキーマを見られるかどうかです。
自然言語でDynamoDBをクエリするには?
選択肢は3つです:
- 汎用のLLMにPartiQLを下書きさせ、自分で実行する。速いですが、モデルは属性名を推測しています。
- MCPサーバー経由でAIエージェントを接続し、テーブルを調査して本当に読み取りを実行できるようにする。
- スキーマ認識エージェントを備えたクライアントを使う。DynoTableのAIチャットは、自然言語をインデックスされたスキーマに対するPartiQLまたはSQLに変換し、テーブル全体の集計を計算し、あらゆる書き込みをレビューのためにステージします。
選択肢1:LLMが下書きしたPartiQLを自分で実行する
能力のあるモデルにクエリを説明し、PartiQLを受け取り、コンソールのPartiQLエディタかCLIで実行します:
aws dynamodb execute-statement \
--statement "SELECT * FROM \"Tickets\" WHERE PK = 'TICKET#1001'"これは機能しますが、予測可能な3つのパターンで失敗します:
- モデルはあなたのテーブルを見られません。 属性名やキーの形をでっち上げ(あなたのテーブルが
PK = TICKET#<id>なのにticketIdと書く)、あなたは幻覚のスキーマをデバッグする羽目になります。 - PartiQLの制限はそのまま適用されます。
SELECTは1つのテーブルを読み、パーティションキーを固定しないWHEREはテーブル全体のスキャンになります。モデルにキーを伝えてパーティションキーに=かINを使うよう頼むか、GSIをそのGSI自身のキーでクエリしてください:FROM "Tickets"."StatusIndex" WHERE "status" = 'OPEN'。そのWHEREのないGSIの読み取りは、インデックス全体をスキャンします。 - チャットボットにデータを貼り付けると、データはあなたのアカウントの外へ送られます。 プロンプト内のサンプルアイテムは、あなたの境界を離れていく本番データです。
スキャンを「起こりにくい」ではなく「起こりえない」ものにするには、dynamodb:FullTableScanがtrueのときにdynamodb:PartiQLSelectをIAMで拒否してください(AWSの例)。SQLの見た目が何をもたらすかはPartiQL vs SQLで説明しています。
データガバナンスの問題には、本物のアイテムの代わりにaws dynamodb describe-tableの出力と編集済みのサンプルを貼り付けるか、自分のAWSアカウントでAmazon Bedrock上のモデルを使ってください。そこではモデルプロバイダーはあなたのプロンプトや出力にアクセスできません(選択肢3がそれを行います)。
記憶から貼り付けられるスキーマに対する単発のクエリには良いですが、ワークフローとしては心もとない方法です。
選択肢2:MCP経由で接続されたAIエージェント
「モデルがテーブルを見られない」問題の構造的な解決策は、貼り付けたスキーマの代わりに、エージェントにツールを与えることです。
MCPサーバーはDynamoDBの操作を型付きツールとして公開します。これにより、MCP対応のエージェント(Claude Code、Cursor、Codex、カスタムエージェント)がテーブルを一覧し、キーを調査し、読み取りを実行でき、実際の結果が会話にフィードバックされます。
DynamoDB MCPサーバーでは、選択肢、そのどれでも読み取り専用の認証情報で動かす方法、書き込み安全性の問題を扱っています。DynoTableも1つ同梱しています:ループバック限定、接続ごとの同意を備え、AWSのキーをエージェントに渡すことは決してありません。
すでにエージェント(エディタやターミナルのコーディングアシスタント)の中で作業しているとき、あるいは社内サポートボットのようにエージェントこそが製品であるときに、これは正しいアーキテクチャです。
選択肢3:DynamoDBクライアントに組み込まれたスキーマ認識エージェント
DynoTableの組み込みエージェントは、テーブルのすぐ隣にあります(⌘;)。あなたのインデックスされたスキーマを読みます:アクティブなプロファイル配下のテーブル、そのキーとインデックス、テーブルのインデックス作成で見つかった属性パスと型、さらにはサンプル値です。
「これを先週分にフィルタして」は、実際の属性名に対して解決されます。@を入力すれば@table、@column、@gsiを明示的に参照できます。

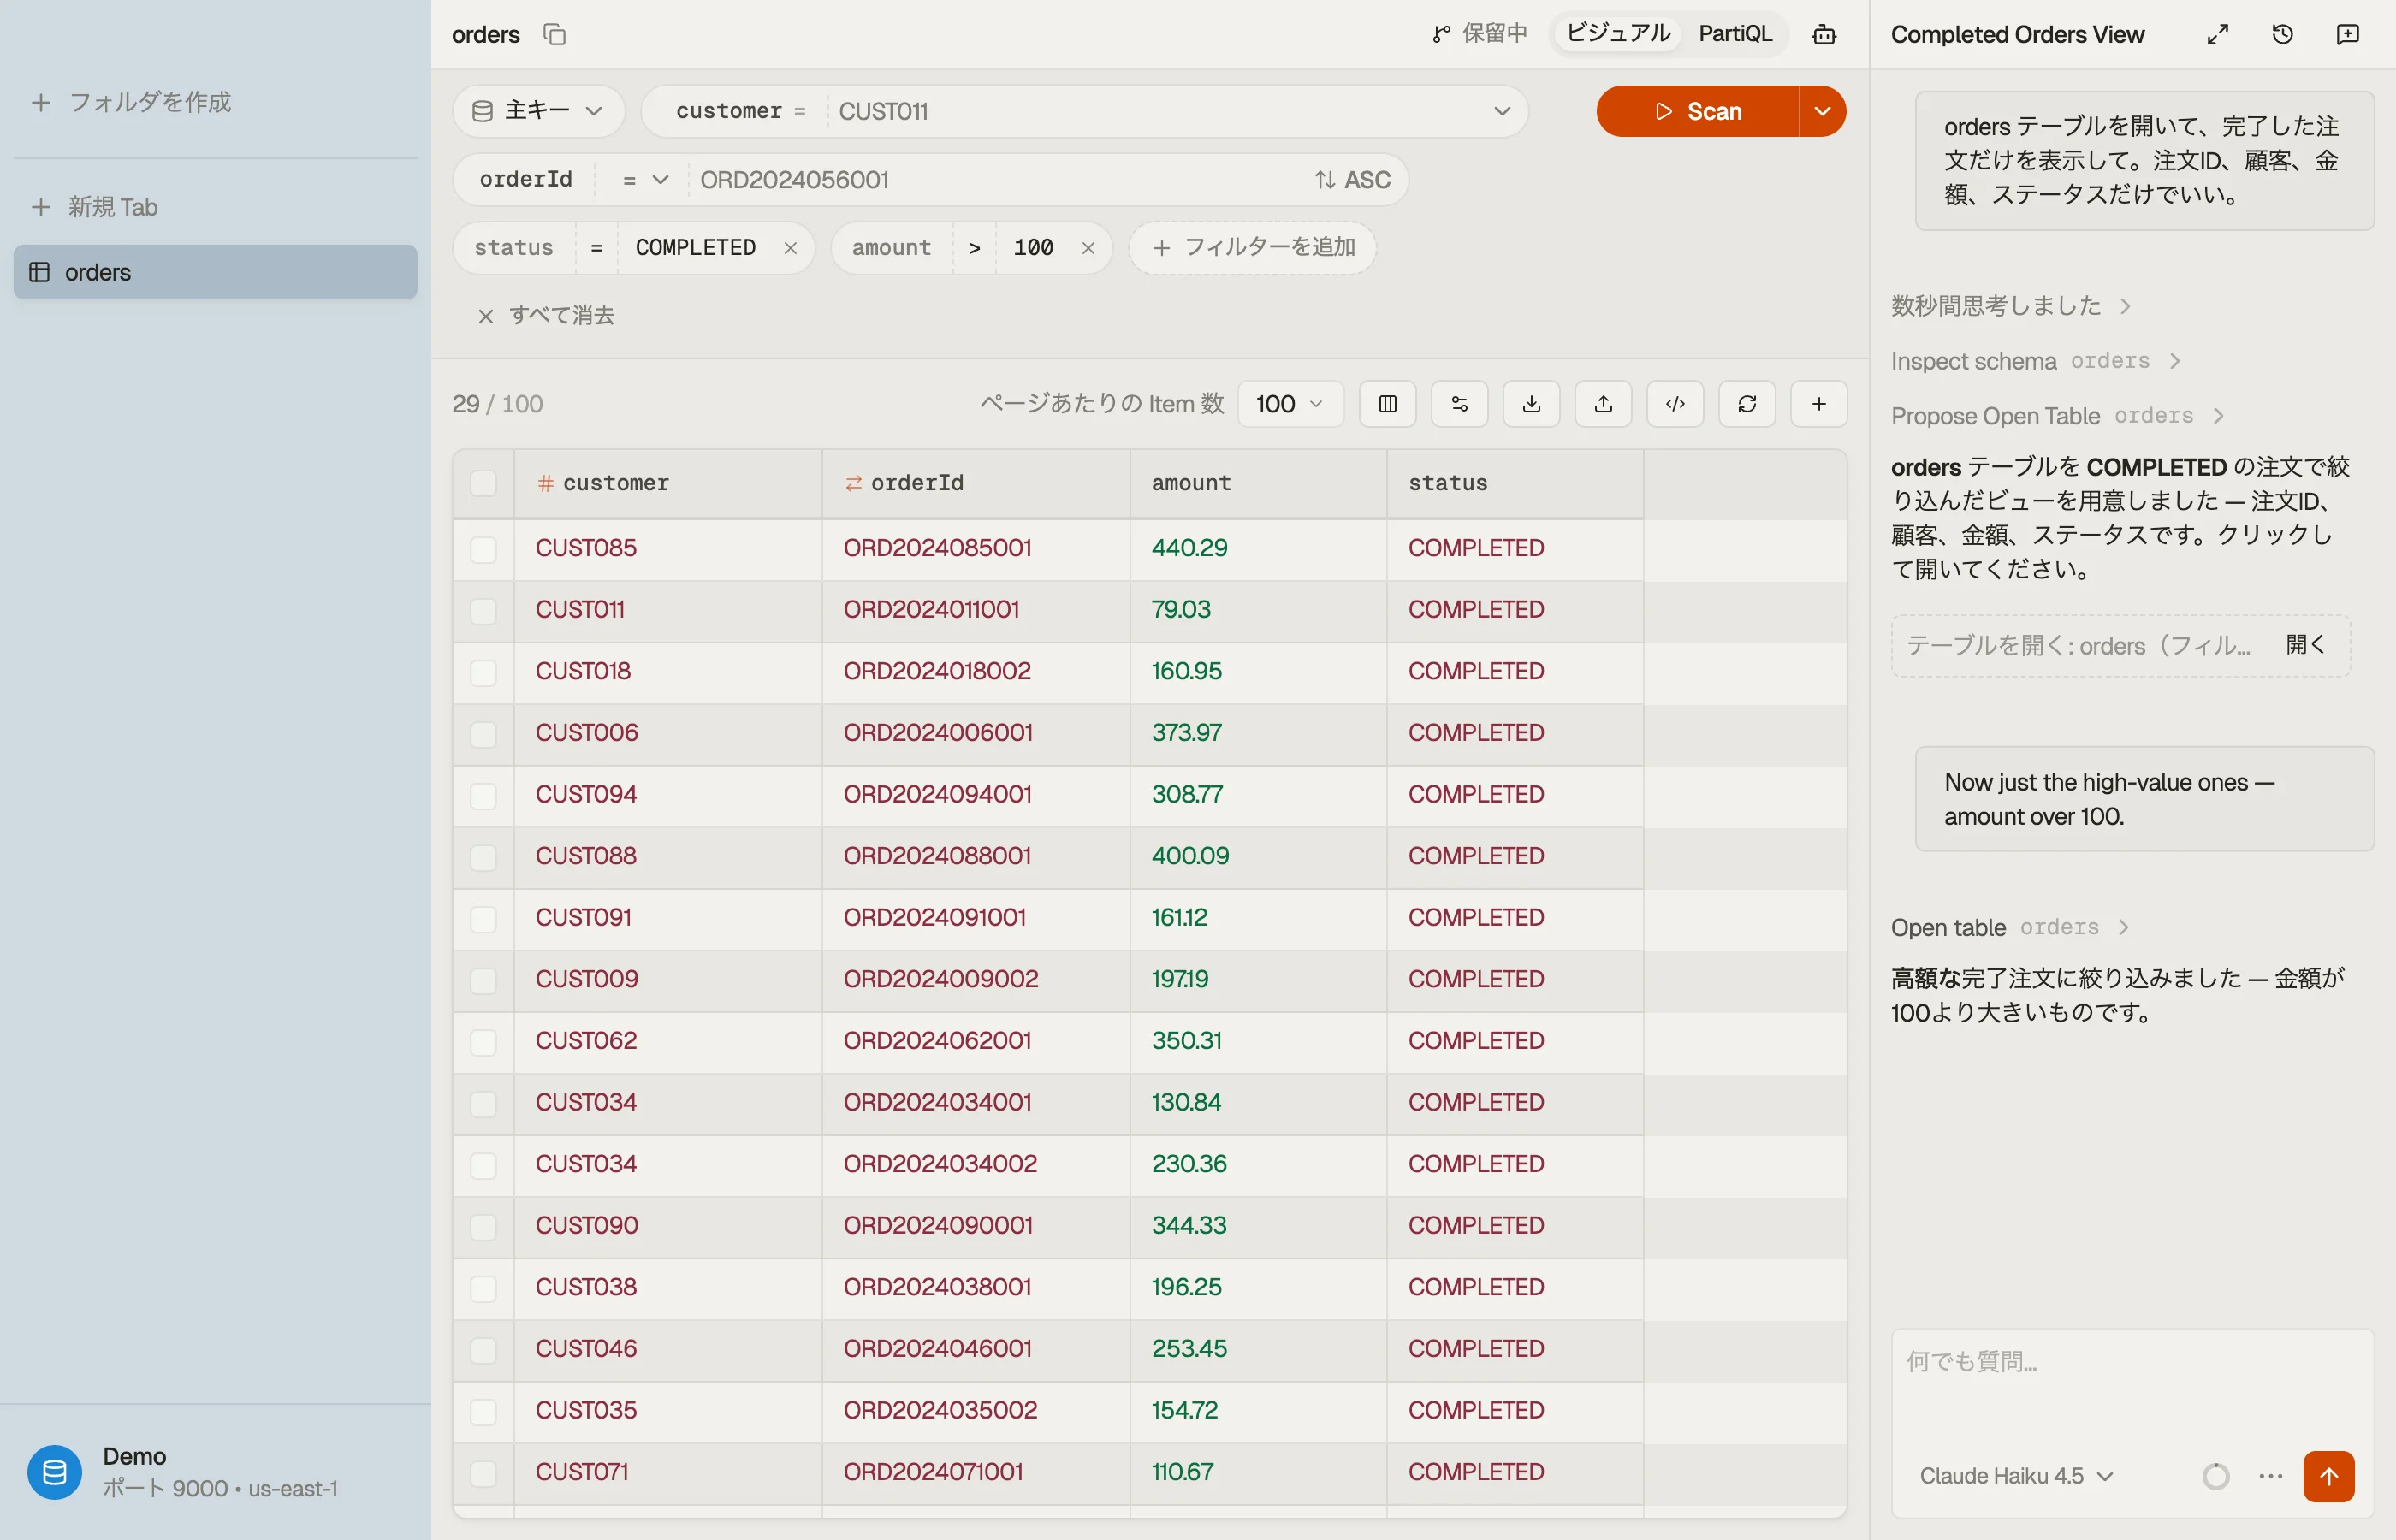

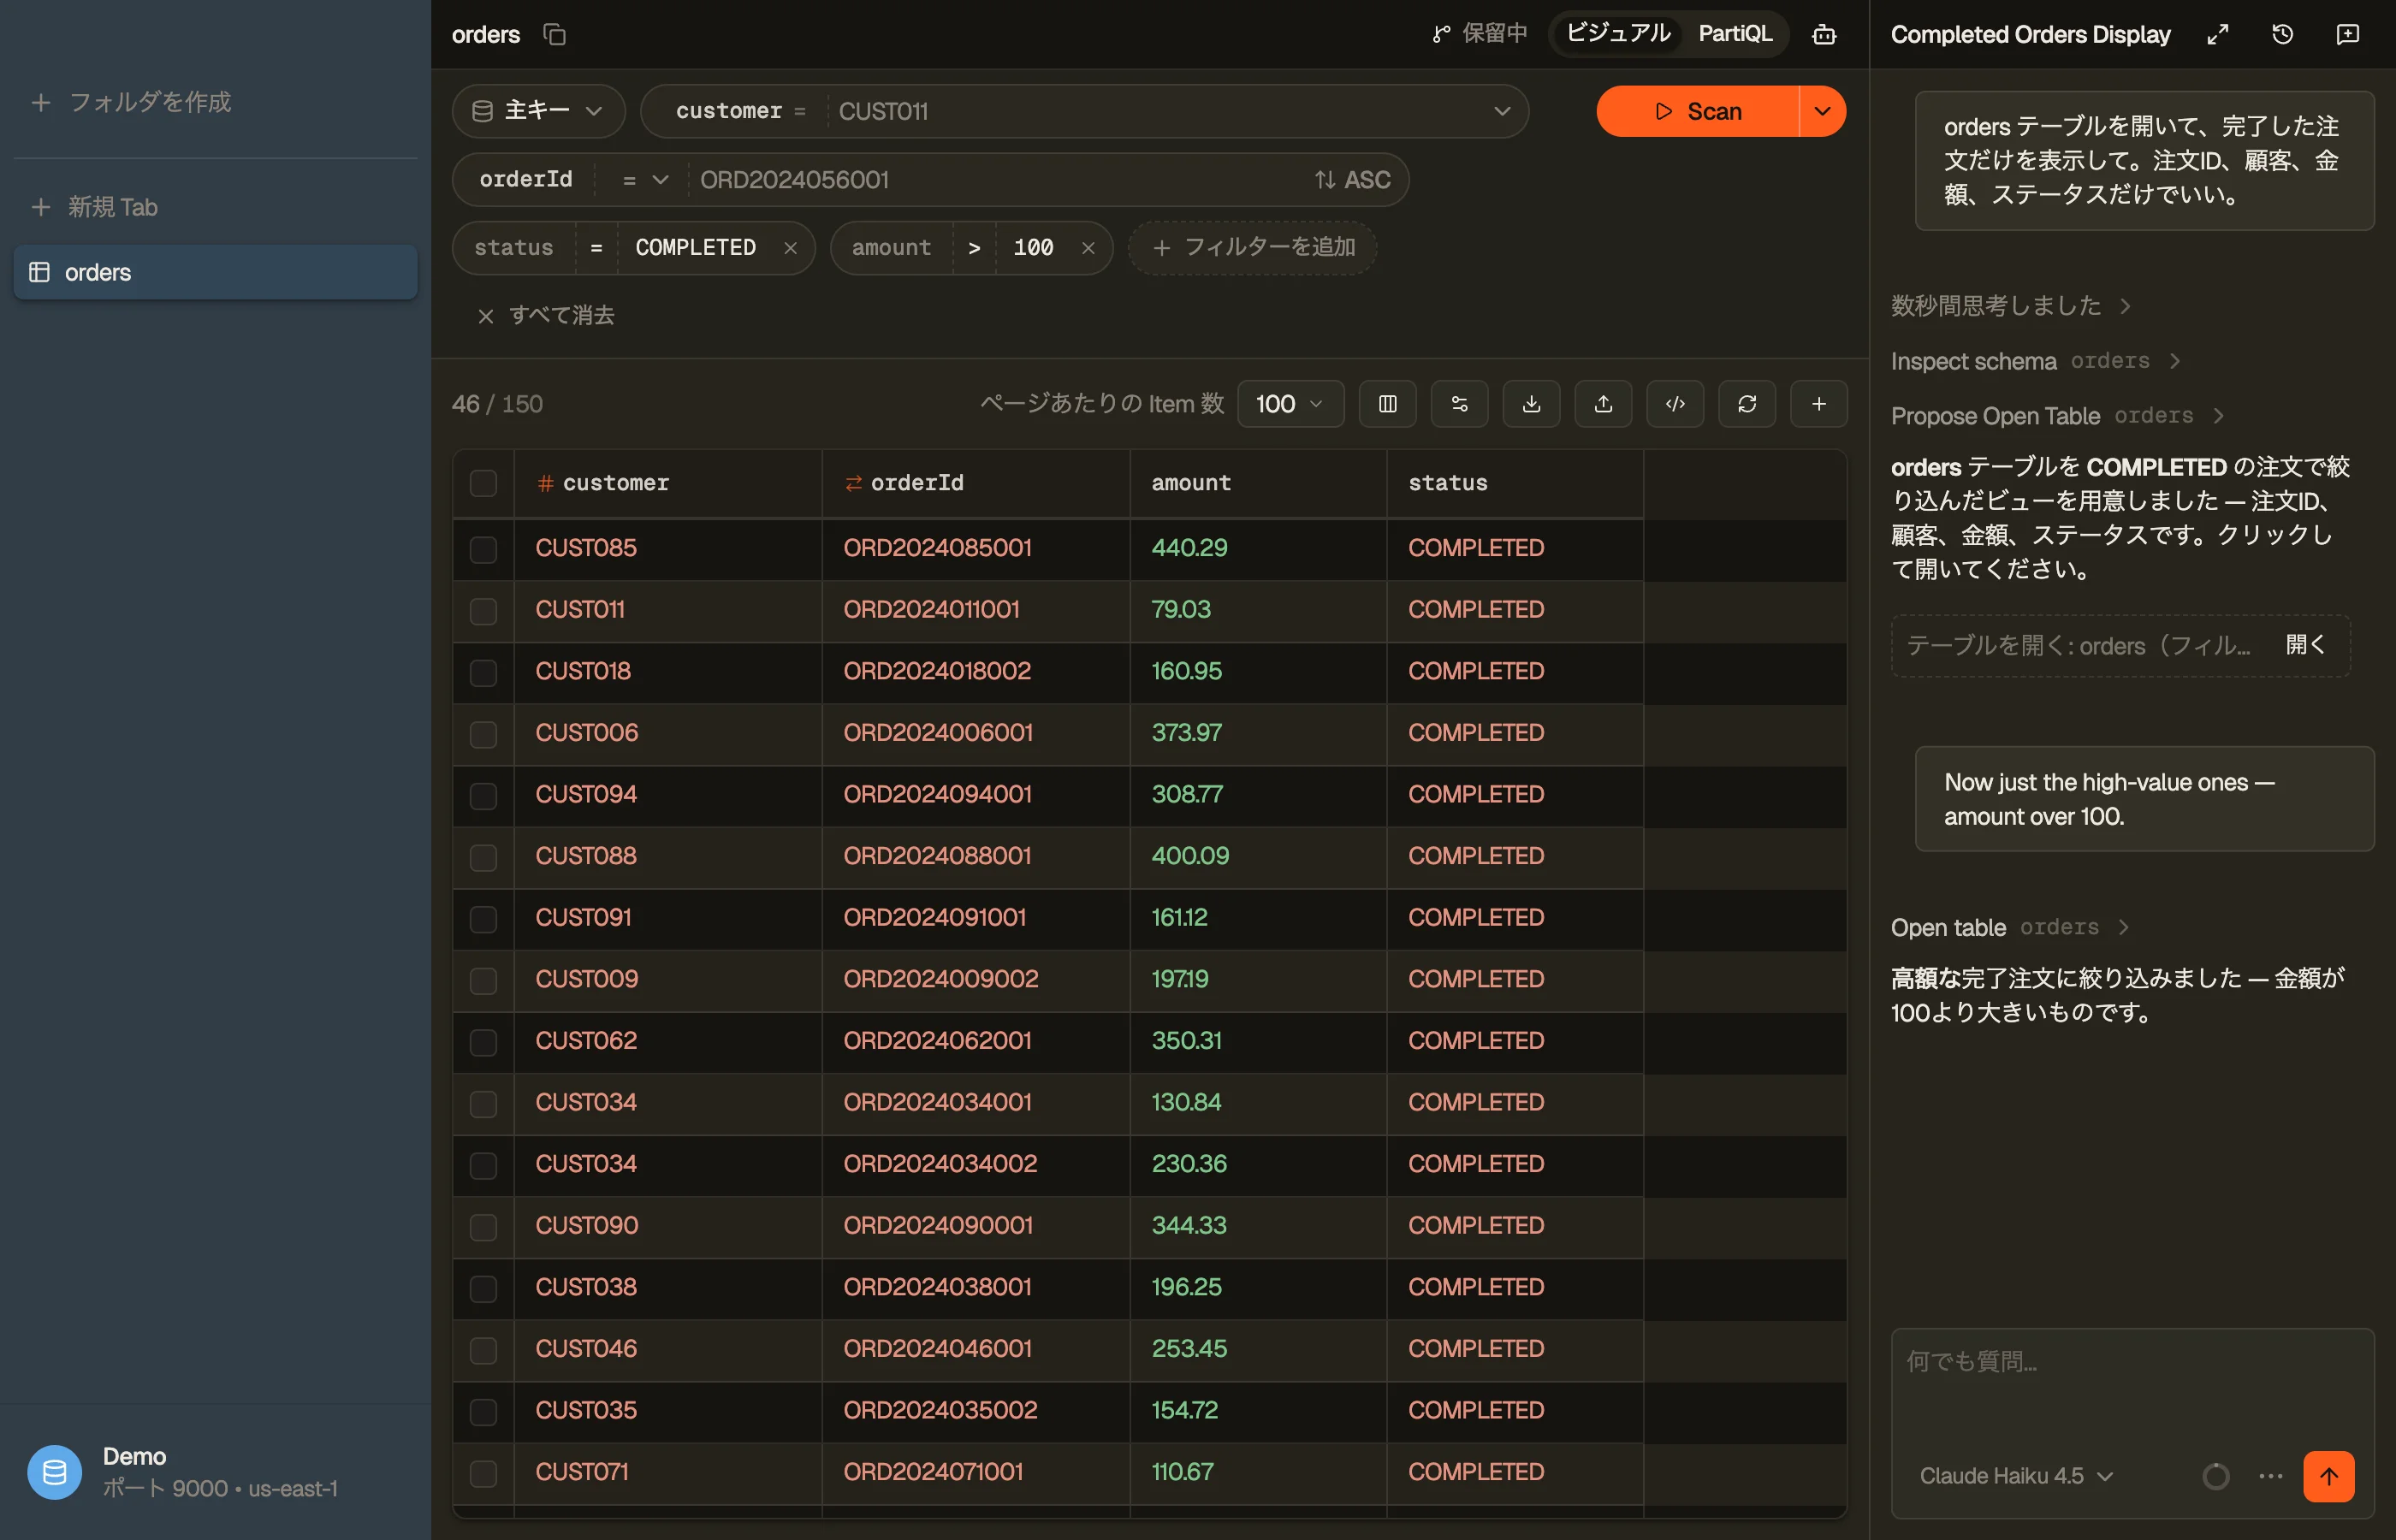
質問に対して何をするか(完全な一覧はAIツールのドキュメントにあります):
- クエリを代わりに書きます: 読み取り専用のPartiQL、または質問が
JOIN/GROUP BY/ 集計(DynamoDBのAPIには存在しない分析機能)を必要とするときはWorkbench SQL。結果をチップとして提案し、クリックすると本物のタブとして開きます。 - テーブル全体の集計を計算します。 合計、平均、グループごとの内訳はWorkbench SQLで実行され、サンプリングした1ページではなくテーブル全体を読みます。手早いアイテム数のカウントはスキャンの上限で止まり、答えが部分的であればそう伝えます。
- すべての書き込みをステージします。 修正はレビュー可能な差分としてステージングエリアに置かれます。フィルタに一致するアイテムの一括編集や一括削除をステージすることはできますが、コミットはできず、テーブルやインデックスの作成、削除、再構成もできません。
- Manualモードでは、コストのかかる読み取りの前に確認します。 既定のManualはツールごとに確認を求めます。Autoは保存した許可を承認し、Full Autoはあなたの拒否設定とS3エクスポートを除くすべての呼び出しを承認します。ゲートされたすべての決定はローカルの監査ログに記録されます。
エージェントはあなた自身のAWS Bedrock認証情報で動き、その認証情報でAmazon Bedrockと直接通信します。BedrockはモデルをAWSが運用するアカウントで実行し、モデルのプロバイダーはそこにアクセスできないため、プロバイダーがあなたのプロンプトを見ることはありません。プロンプト、スキーマ、テーブルデータがDynoTableのサーバーを経由することはなく、推論はBedrock自身のレートで上乗せなしにあなたに請求されます。
ツールの結果は、信頼できないものとして扱うよう指示を添えて、データとしてモデルに渡されます。これにより、「以前の指示を無視して」と書かれた行がエージェントを操る可能性は下がりますが、ゼロにはなりません。
被害を抑えるのは、たとえ操られたエージェントでも、あなたがレビューする変更をステージすることしかできないという点です。
AIがDynamoDBについて変えないこと
- アクセスパターンが依然として支配します。 キーでない属性に対する「where status = X」は、誰が書こうとフィルタ付きスキャンです。ある質問が繰り返しスキャンを強いるなら、データモデルを直してください:GSIか、より良いソートキーです。
- 読み取りは実際のキャパシティを消費します。 テーブル全体の集計は、テーブル全体の読み取りです。料金計算ツールは、承認する前にフルパスのコストを教えてくれます。
- 出荷するクエリは手で組み立てましょう。 本番で何年も実行するクエリなら、Expression Builderで式を一度組み立てて、正確なnames/valuesマップを出荷してください。AIは探索に、ビルダーはコミットするコードに使います。
よくある質問
DynamoDBを平易な言葉でクエリできますか? APIに対しては無理です。APIは式とPartiQLしか話しません。AIレイヤーが翻訳できます:PartiQLを下書きするLLM、MCP接続のエージェント、あるいはDynoTableのように実際のスキーマに対してクエリを実行するスキーマ認識エージェントです。
DynamoDBには組み込みのAIクエリ機能がありますか? APIに自然言語のエンドポイントはありません。AIによるクエリはその上のツーリングから来るので、その安全モデルを評価してください:読み取りのゲート、ステージされた書き込み、そしてどの認証情報で動くかです。
本番データの近くにAIを置いても安全ですか?それは権限の問題です。見るべきポイント:承認でゲートされた読み取り、レビュー可能なステージングエリアに置かれる書き込み、監査ログ、そしてあなたが管理する認証情報での推論。データを貼り付けたチャットボットは、そのどれも満たしません。
AIはテーブルをジョインしたりGROUP BYしたりできますか?
DynamoDBのAPI経由では無理です:そのためのエンジンが存在しません。DynoTableのエージェントはWorkbench SQL(DynamoDBのアクセスパターンのルール内でのJOIN、GROUP BY、集計)を使います。カウント/合計/平均もそこで扱えます。
コストはいくらかかりますか?メーターは2つです:クエリが触れる分のDynamoDB読み取りと、あなた自身のAWSアカウントに請求されるBedrockの推論です。DynoTableは上乗せせず、何もプロキシしません。エージェントとWorkbench SQLには、DynoTableの有効なプランまたはトライアルも必要です。どちらもない場合、アプリは読み取り専用の閲覧に切り替わります。料金を参照してください。
次の質問は平易な言葉で聞いてみましょう:DynoTableをダウンロードして、AIを自分のBedrockに向け、すべての書き込みをレビューの後ろに置いてください。