DynamoDB のインデックス射影
セカンダリインデックスを作成しても、DynamoDB はデフォルトではアイテム全体をそこへコピーしません。インデックスの 射影、つまりインデックスがどの属性を格納するかをあなたが選びます。
少なく選びすぎるとクエリは残りを取得するために2回目の読み取りが必要になります。すべてを選ぶと余分なストレージを支払い、本来ならインデックスを素通りするはずの更新でもインデックスへの書き込みが発生します。
(これを 射影式(projection expression) と混同しないでください。射影式は、単一の読み取りが 返す 属性を絞るものです。このページは インデックスが物理的に格納する ものに関するものです。もう一方については 射影式を参照してください。)
DynamoDB のインデックス射影とは?
射影とは、DynamoDB がベーステーブルからセカンダリインデックスへコピーする属性の集合です。インデックスの作成時に3つのタイプのいずれかを選び、後からその場で変更することはできません。
- 射影が多いほど、余分な読み取りは少なくなります。 クエリはインデックスが格納しているものしか返せないので、薄い射影は読み取りをベーステーブルへ押し戻します。
- 射影が少ないほど、書き込みは安くなります。 インデックスが格納している属性に触れない更新は、そのインデックスに何のコストもかけません。
- GSI があなたの代わりにベーステーブルを読むことは決してありません。 射影されていない属性を要求すると失敗します。それを取得するのは LSI だけで、追加の読み取りコストがかかります。
各射影タイプが何をコピーするか
KEYS_ONLYはベーステーブルのキーとインデックスキーを格納します。クエリがどの アイテムがマッチするかだけを知る必要があり、詳細は別の場所で取得するか、まったく取得しない場合に使います。INCLUDEはキーに加えて、あなたが名前で指定した固定リストの属性を格納します。クエリが描画するフィールドをちょうどそのまま射影しましょう。ALLはアイテム全体をコピーします。クエリはインデックスだけで完結しますが、すべての属性の2つ目のコピーという代償を払います。
INCLUDE のリストは1つのクォータを共有します。テーブルのすべての GSI と LSI を合計して名前付き属性は最大100個で、2つのインデックスに射影された属性は2回カウントされます。
KEYS_ONLY と ALL はこのクォータにカウントされません。
問題: あなたに2回読ませるインデックス
未対応 チケットを優先度順に一覧できる GSI を持つサポートデスクを運用しているとします。リーンに保つため KEYS_ONLY を射影します。クエリは高速に返ってきますが、返るのはチケットのキーだけで、キュー画面には各チケットの subject、assignee、openedAt が必要です。
GSI ではそれらを要求できません。subject を指定した ProjectionExpression は
ValidationException: One or more parameter values were invalid: Global secondary index open-by-priority does not project [subject] で失敗します。そこでコードは、各結果を肉付けするためにベーステーブルに対して2回目の読み取りを行います。
約 2 KB のチケットで結果整合性のある読み取りの場合、未対応チケット50件のキューを1回更新するコストは次のとおりです。
| 射影 | インデックスクエリ | フォローアップ読み取り | 更新1回あたりの読み取りユニット |
|---|---|---|---|
KEYS_ONLY | キーが約 3 KB、4 KB に切り上げ | 50 × 2 KB の BatchGetItem | 約0.5 + 25 = 約25.5 |
INCLUDE subject, assignee, openedAt | 約 5–7 KB、8 KB に切り上げ | なし | 約1 |
ALL | 50 × 2 KB = 100 KB | なし | 約12.5 |
Query は返されたすべてのエントリのサイズを合計し、1回だけ 4 KB に切り上げます。
GetItem や BatchGetItem が読む各アイテムはそれぞれ個別に 4 KB に切り上げられるので、
50回の肉付けの読み取りは 50 × 0.5 = 25 かかります。
薄いインデックスのせいで、キューは最も高価な選択肢になりました。サンプルチケットをアイテムサイズ計算機 に貼り付けて、自分のサイズで計算し直してみてください。
LSI の射影フェッチ動作
あなたの代わりにベーステーブルを読んでくれるインデックスは LSI だけです。LSI へのクエリの
ProjectionExpression に射影されていない属性を指定するか、Select: ALL_ATTRIBUTES を渡すと、DynamoDB は同じ Query の中でその属性をベーステーブルからフェッチします。
フェッチには課金されます。インデックスの読み取りに加えて、フェッチしたベーステーブルのアイテムごとに、アイテム全体を読んだ分を1件ずつ 4 KB に切り上げて支払います。同じ50件のチケットのキューを KEYS_ONLY の LSI 経由で実行すると(LSI はテーブルのパーティションキーを共有するので、これは1つのアカウントのキューです)、結果整合性で約0.5 + 25読み取りユニットかかります。
これは上の表の BatchGetItem と同じ請求額を、1回のリクエストで払うということです。フェッチした各アイテムは切り上げ後のサイズで 1 MB のページにもカウントされるので、フェッチするクエリは1ページあたりに返すアイテムが少なくなります。LSI は、フェッチした属性も含めて強い整合性で読み取れます。
クエリが毎回フェッチするなら、テーブルの作成時にそれらの属性を LSI に射影してください。後から変更はできません。GSI は決してフェッチしません。同じリクエストは上の
ValidationException で失敗し、Select: ALL_ATTRIBUTES は射影が ALL でない限り拒否されます。そのため GSI の設計は、最初から少し広めの INCLUDE に寄っていきます。
あなたがトレードしているコスト
射影する属性はすべて 2度目に格納され、インデックスへの書き込みは、ベーステーブルへの書き込みがインデックスの格納しているものに触れたときにだけ発生します。
- 射影された属性が変わる: インデックスへの書き込み1回。
- インデックスキーの値が変わる: インデックスへの書き込み2回(古いエントリを削除し、新しいエントリを put)。
- どちらでもない: インデックスへの書き込みなし。ベーステーブルの分は引き続き課金されます。
ALL ではすべての属性が射影されるので、すべての更新がコストを払います。チケットの大きな
body を編集すると、ALL のインデックスには更新ごとに約2書き込みユニットかかり、
INCLUDE のインデックスには何もかかりません。クエリが読むものを射影しましょう。
射影のストレージと書き込みの倍率は DynamoDB 料金計算ツール で比較検討しましょう。
スパースインデックスと組み合わせる
スパースインデックス には、そのキー属性を持つアイテムだけが入るので、ALL を含むあらゆる射影が小さくなります。キューの GSI を未対応チケットだけが持つ属性(たとえば openBucket)でキーイングすれば、何百万件ものクローズ済みチケットは決してそこに入りません。INCLUDE のリストは未対応チケットの分だけ格納されます。
チケットのクローズは openBucket を REMOVE する UpdateItem で、インデックスにはエントリを削除する書き込み1回がかかります。その後クローズ済みチケットを編集しても、インデックスには何もかかりません。この組み合わせは、インデックスに入る部分集合がテーブルに比べて小さいときに効果を発揮します。
まずアクセスパターンを組み立てる
射影は、画面が描画するものから決めましょう。このクエリから UI が表示する属性を一覧にし、それらをちょうどそのまま射影します。それ以外はすべてベーステーブルに残します。
CloudFormation、CDK、Terraform でテーブル定義を変更する前に、クエリビルダー でインデックスへのクエリ(インデックス、キー条件、フィルタ、射影)を試作してください。最終的にできあがった射影式が、そのまま
INCLUDE のリストになります。ただし、どのインデックスも必ず格納するキー属性は除きます。キー条件だけなら DynamoDB Expression Builder を使いましょう。
あとから射影を変える
その場で編集する方法はありません。UpdateTable で変更できるのは GSI のスループット設定であって、射影ではありません。現在の KEYS_ONLY の GSI が、テーブル Tickets 上の
open-by-priority だとします。これを INCLUDE に広げるには:
必要な
INCLUDEリストを持つ代わりの GSI を新しい名前で作成します。UpdateTableには、テーブルがすでに宣言している場合でも、新しいインデックスのキー属性を--attribute-definitionsで渡す必要があります。プロビジョニングされたテーブルでは、Createの中にProvisionedThroughputを追加します。aws dynamodb update-table \ --table-name Tickets \ --attribute-definitions AttributeName=openBucket,AttributeType=S \ AttributeName=priority,AttributeType=N \ --global-secondary-index-updates '[{"Create": { "IndexName": "open-by-priority-v2", "KeySchema": [ {"AttributeName": "openBucket", "KeyType": "HASH"}, {"AttributeName": "priority", "KeyType": "RANGE"} ], "Projection": {"ProjectionType": "INCLUDE", "NonKeyAttributes": ["subject", "assignee", "openedAt"]} }}]'DynamoDB はテーブルからそれをバックフィルし、バックフィルの読み取りは課金されません。
新しいインデックスの
IndexStatusがACTIVEになるまでdescribe-tableをポーリングします。CREATINGの間はクエリできません。コードの
IndexNameを新しいインデックスに向けます。古いインデックスを
{"Delete": {"IndexName": "open-by-priority"}}で削除します。
UpdateTable 1回で作成または削除できる GSI は1つだけで、バックフィルの実行中は他のインデックスを追加も削除もできません。また、代わりのインデックスには、デフォルトの GSI
20個というクォータの下で空き枠が1つ必要です。
LSI の射影はまったく変更できません。LSI は CreateTable でしか作れず、後から追加も削除もできないからです。
同じパーティションキーとより広い射影を持つ GSI を追加する(読み取りは結果整合性のみ)か、修正した LSI を持つ新しいテーブルを作成してデータをコピーするかのどちらかです。
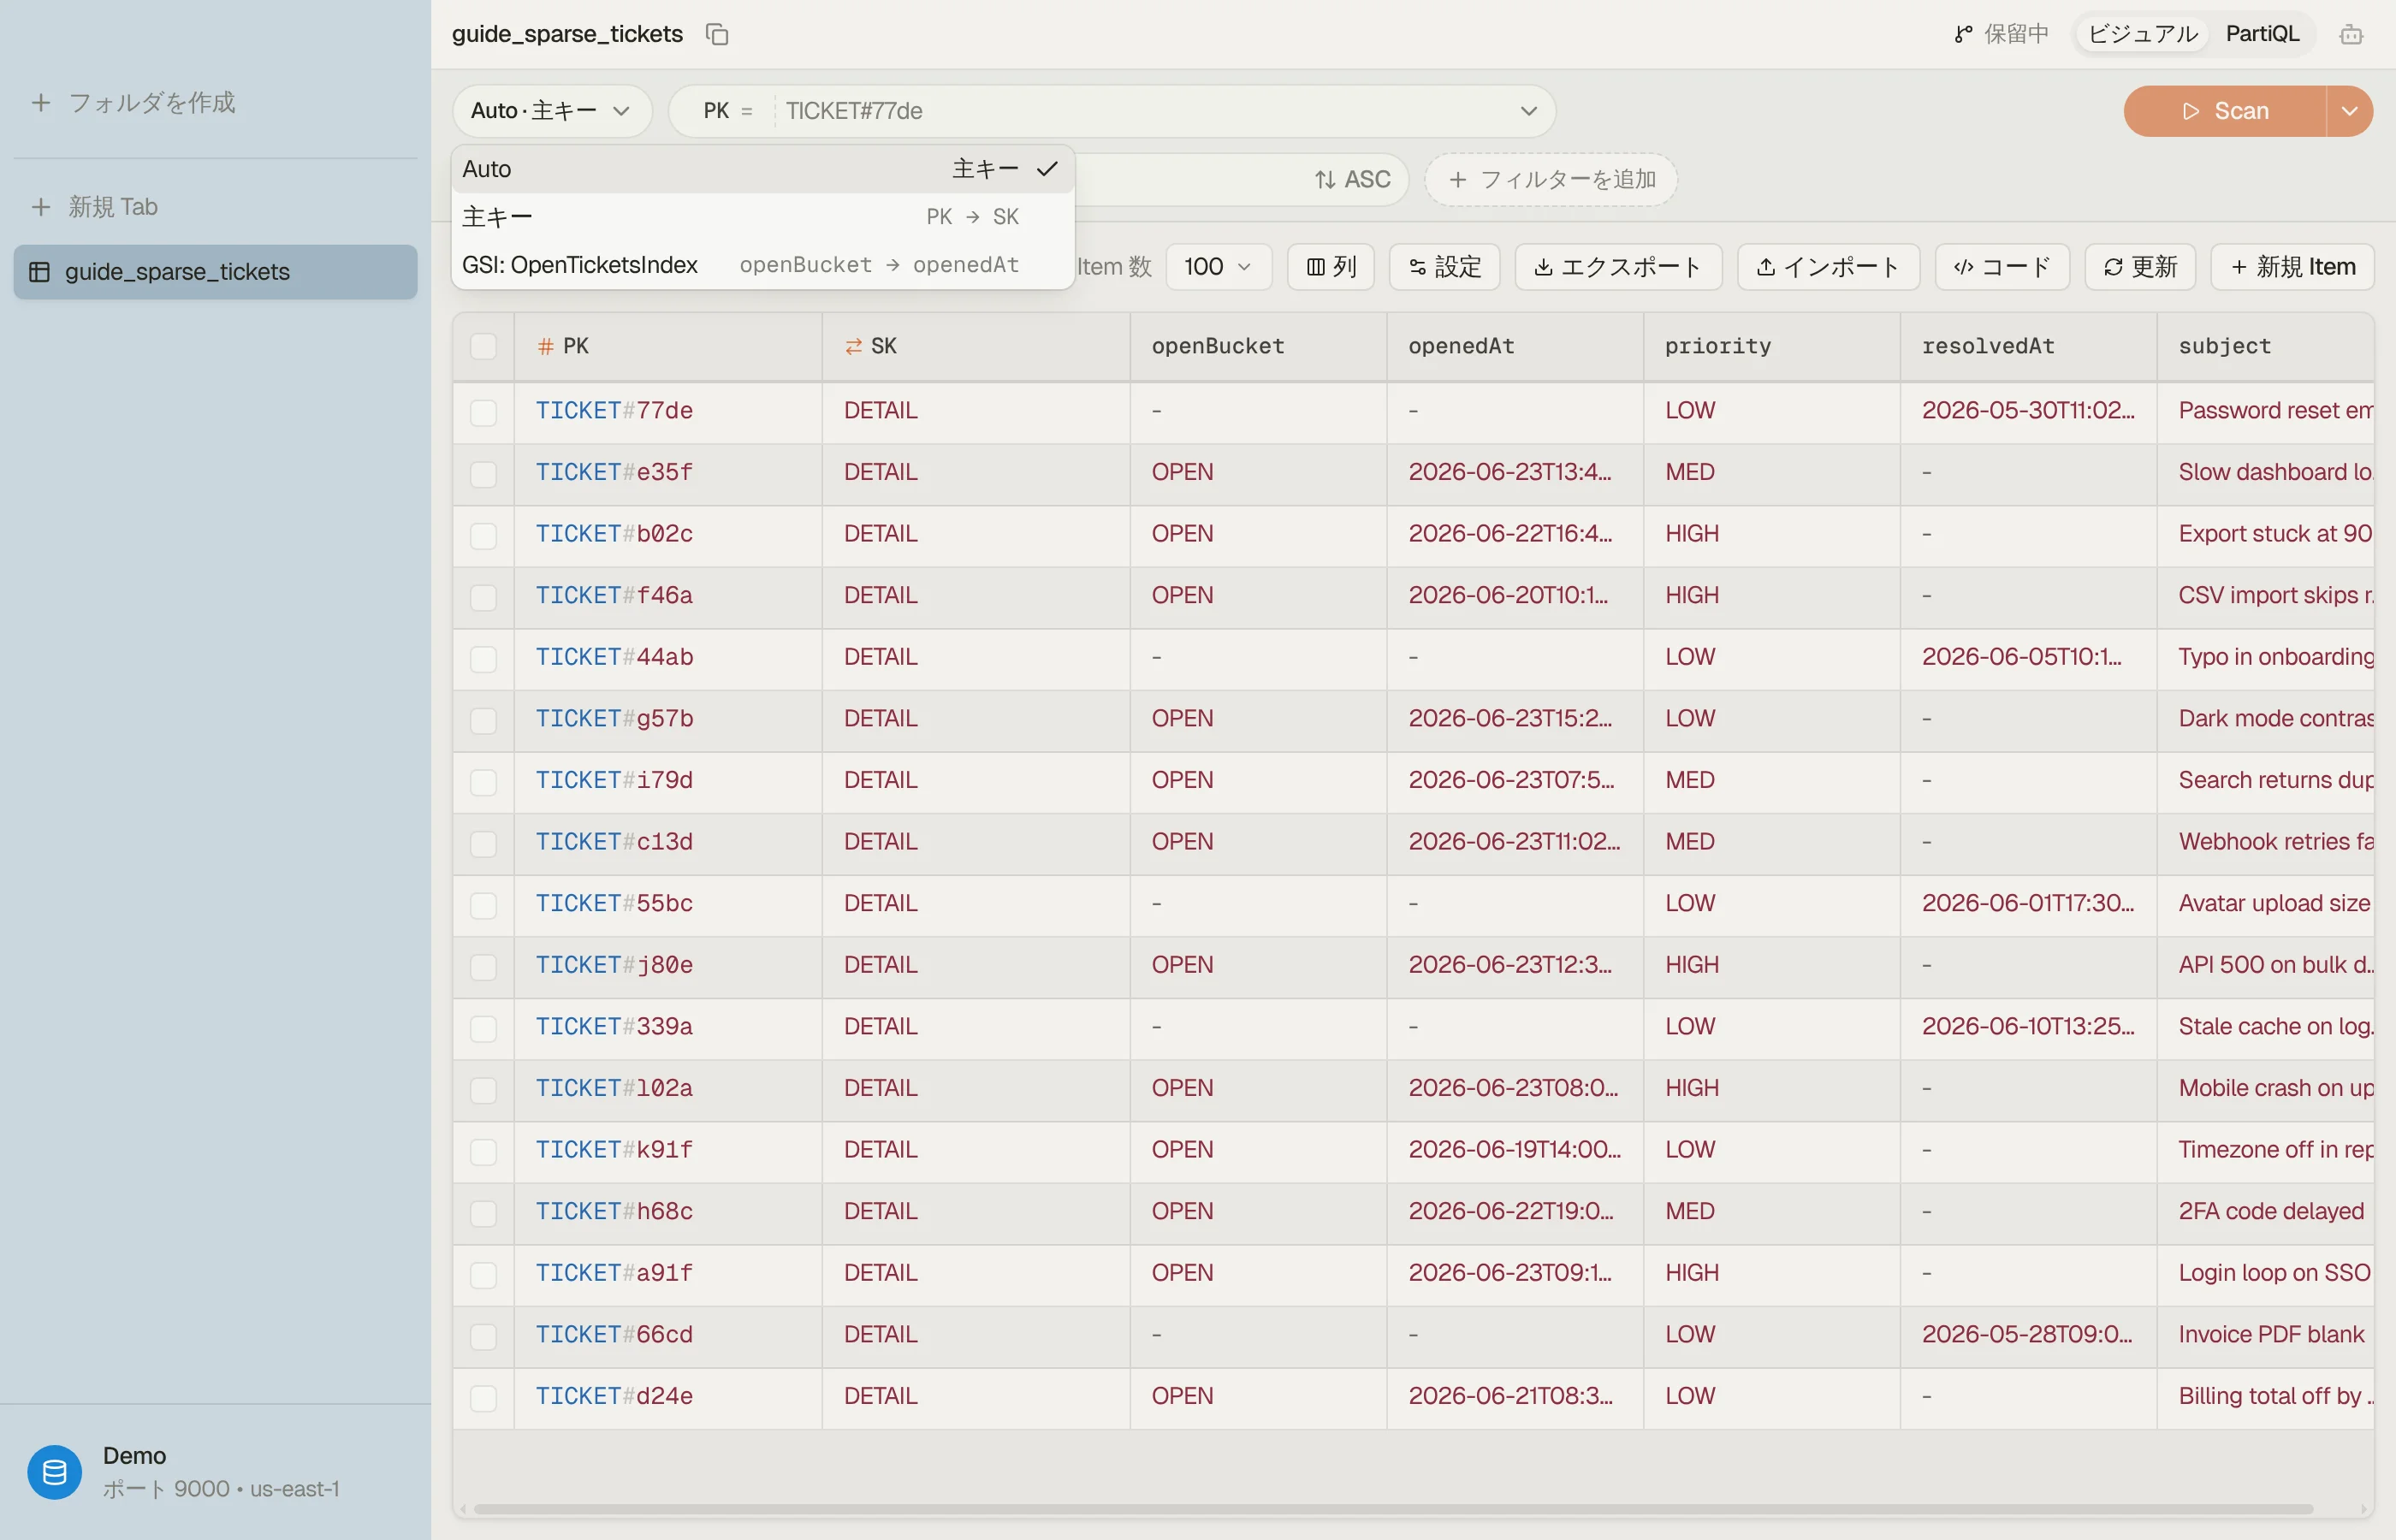
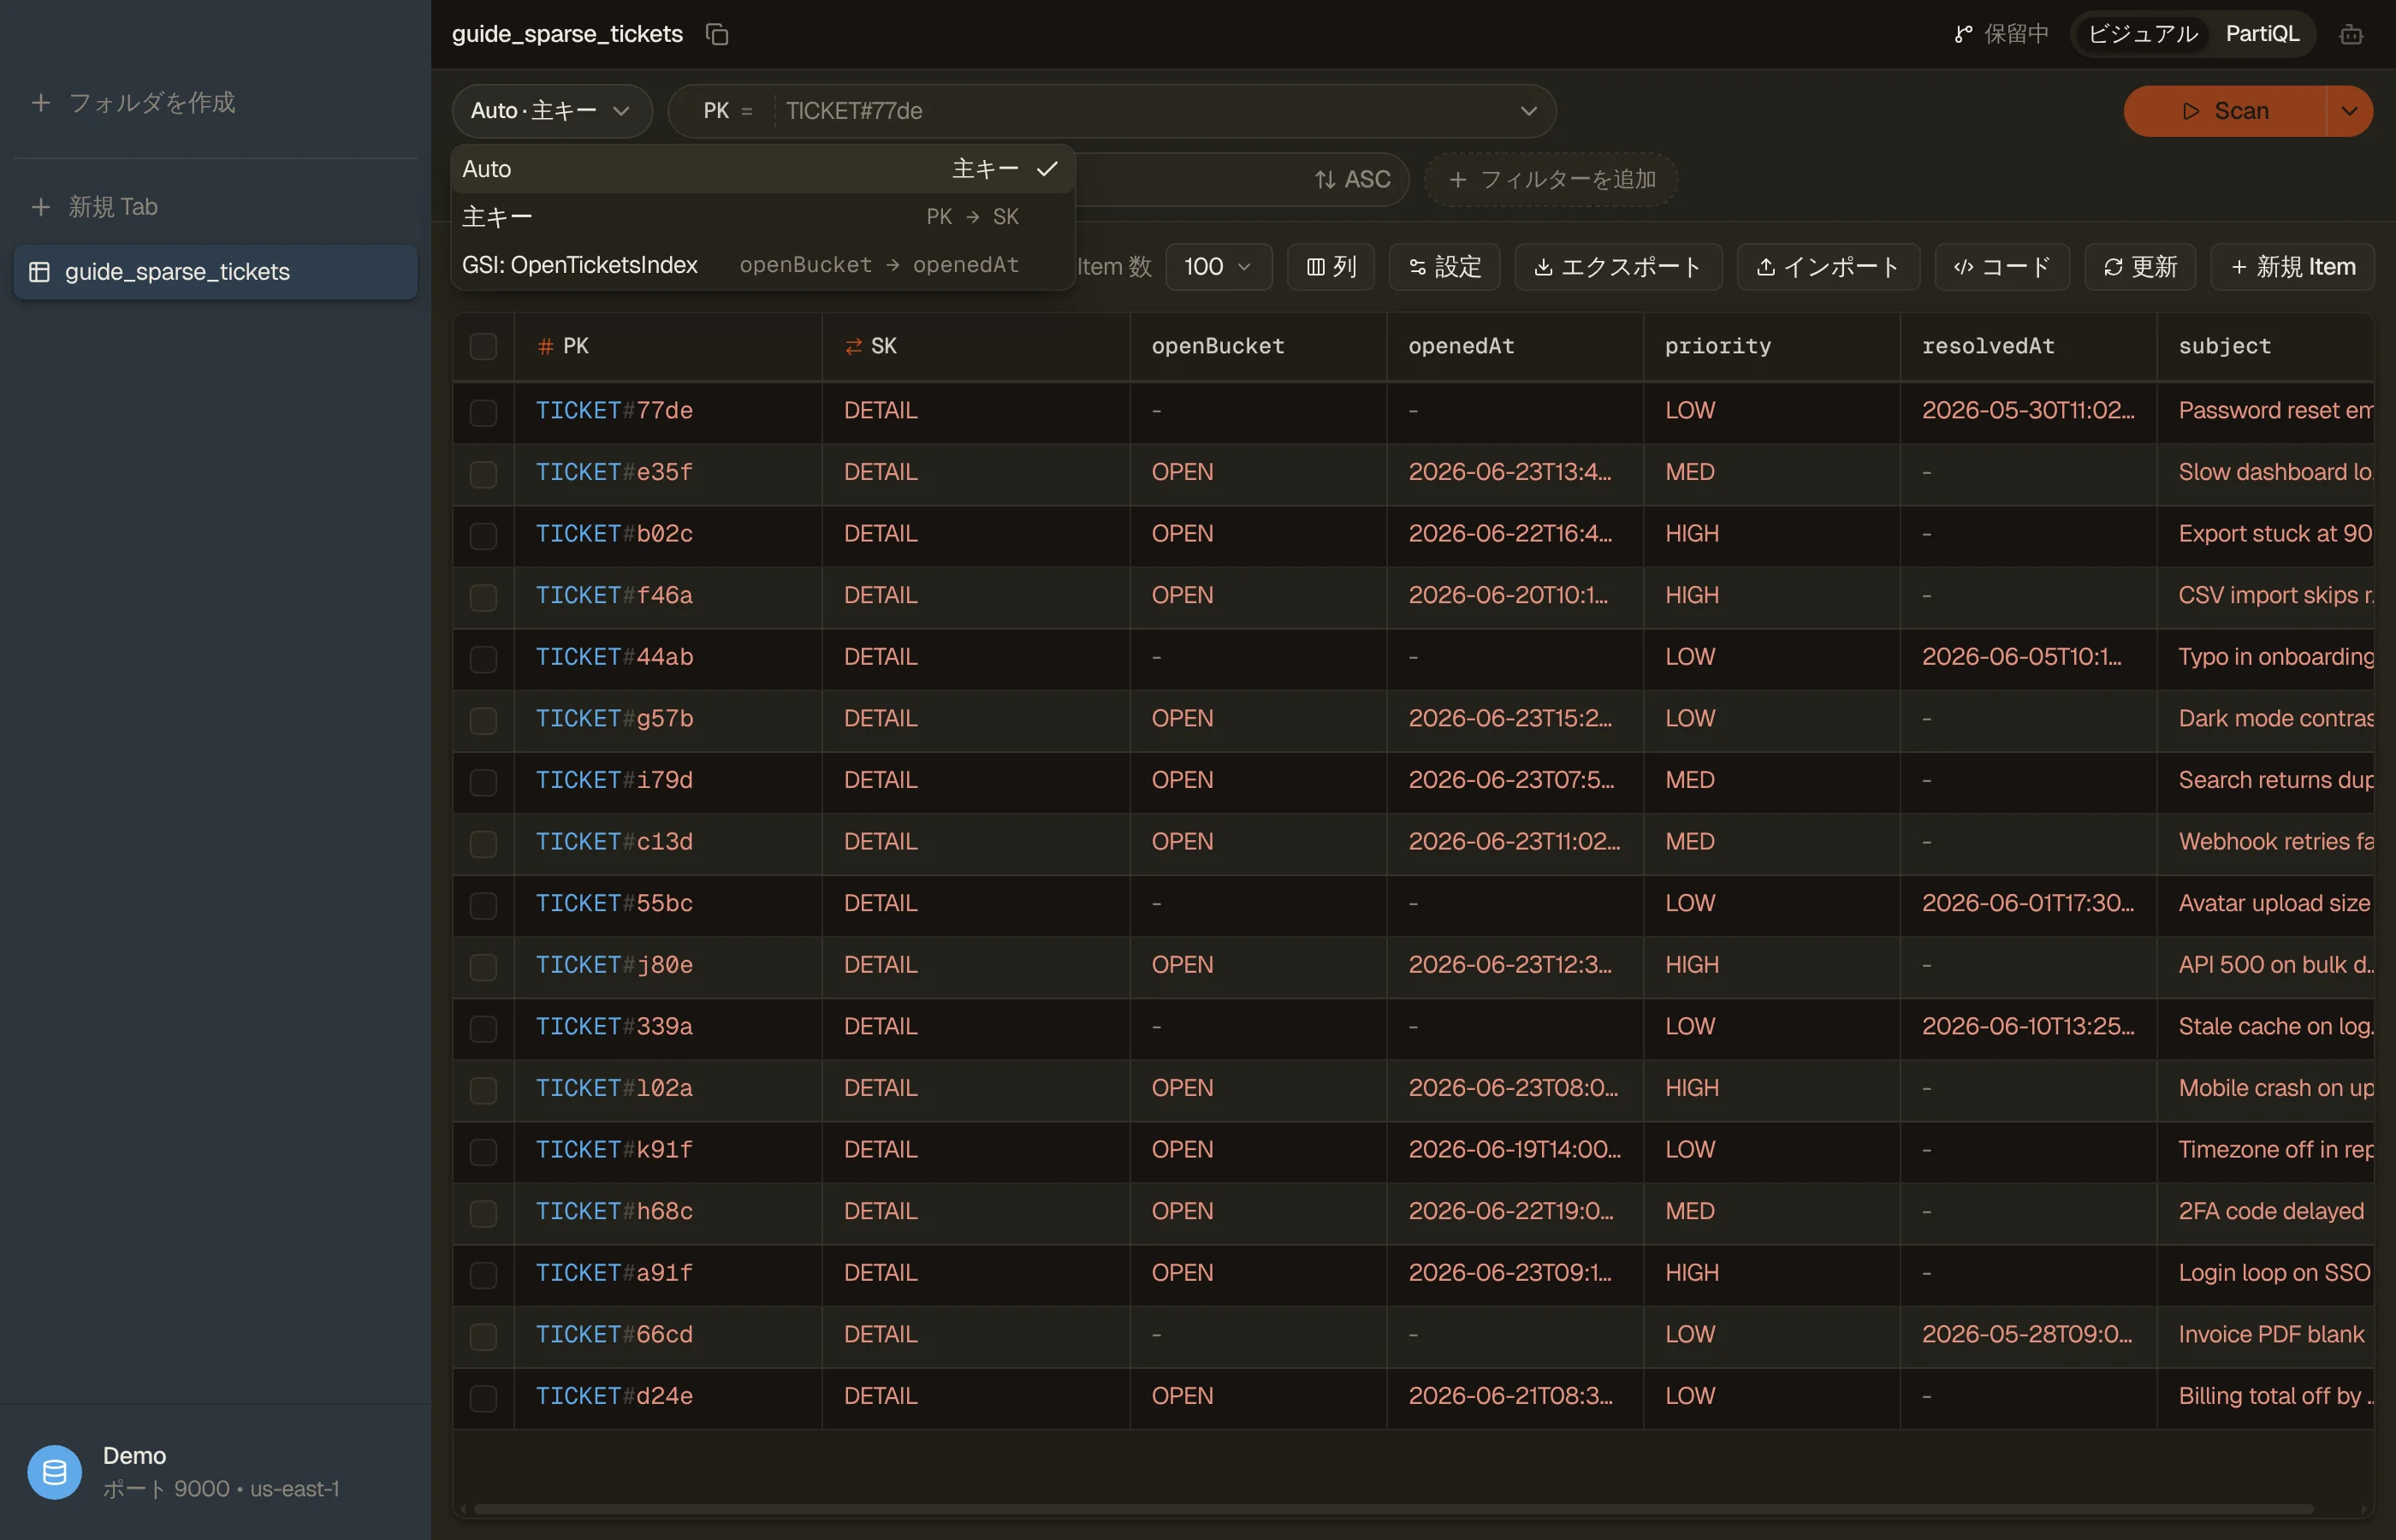
DynoTable で射影を見る
DynoTable は、テーブルの各セカンダリインデックスを一覧し、そのうちの1つを通して直接クエリできます。同じアクセスパターンをベーステーブルに対して、次に GSI に対して実行し、結果を比較してみてください。インデックスの結果に欠けている属性が、それが射影していない属性です。


落とし穴と次のステップ
- GSI 上の射影されていない属性は、自前のベーステーブル読み取りを意味します。 クエリが描画するものを中心に射影を設計しましょう。
ALLはめったに無料ではありません。 ストレージを倍にし、すべての更新をインデックスへの書き込みにします。クエリがすべてのフィールドを読むのでない限り、INCLUDEを既定にしましょう。- 射影は固定です。 変更するには、新しいインデックス、バックフィル、切り替えが必要です。 LSI なら新しいテーブルが必要です。
- 関連: GSI と LSI とスパースインデックス が、射影がどれだけ格納するかを左右します。
再設計の前に、各インデックスが何を返すか見てみたいですか? DynoTable をダウンロード して、テーブルに直接クエリしましょう。