DynamoDB のスパースインデックス
スパースインデックスとは、そのキー属性を持つアイテムだけを保持するセカンダリインデックスです。そのため、巨大なテーブルの小さくホットなサブセットが、それ自体で事前フィルタリングされた、すぐにクエリできるコレクションになります。
数百万行あるのに、一日中実行するクエリが触れるのはごくわずかなスライスです。オープンなサポートチケット、未払いの請求書、レビュー対象にフラグが立ったアカウントなど。
そのスライスをフィルタリングしても、読み取ったすべてのアイテムの分を請求されます。スパースインデックスは、代わりにインデックスそのものを小さくします。
DynamoDB のスパースインデックスとは何か?
スパースインデックスとは、そのキー属性を持つアイテムだけを保持するセカンダリインデックスです。DynamoDB はそのキーを持たないアイテムをスキップするので、欲しいアイテムだけが書き込むキー(オープンなチケット、未払いの請求書)を考案すると、インデックスはまさにそのサブセットになります。クエリはそれだけを読み取ります。
- 欲しいアイテムにだけキーを書き込む。 アイテムがサブセットに加わるときに設定し、離れるときに取り除きます。
- キーを空白化するのではなく、取り除く。 空文字列は有効なインデックスキーではないので、アイテムをインデックスから外すには
REMOVEを使います。 - インデックスは結果整合性。 「このアイテムは今サブセットに入っているか」は、ベーステーブルで確認します。
問題: フィルタリングは読み取りを節約しない
SQL から来ると、WHERE 句が作業を絞り込むと思い込みます。DynamoDB の FilterExpression はそうしません。それはアイテムが読み取られた後に動くのであって、前ではありません。
AWS デベロッパーガイドには "a Query consumes the same amount of read capacity, regardless of whether a filter expression is present." とあります。調べたすべてのアイテムに対して支払い、それから一致しないものを捨てるのです。
ですから、500 万件のチケットのうち 50 件がオープンなら、フィルター付きの Scan はその 50 件を渡すために
500 万件すべてを読み通します。フィルター付きの Query も、読み取るキー範囲内のすべてのアイテムの分を支払います。それが数百万件になるのは、それらがすべて 1 つのパーティションキーを共有している場合だけです。
Query と Scan に完全なコストの全体像があります。スパースインデックスは、インデックスそのものを小さくすることでそれを回避します。
スパースさはどのように機能するか
セカンダリインデックスは、インデックスのキー属性を持つアイテムだけをインデックスします。
スパースインデックスに関する AWS のドキュメントがこれを明言しています。DynamoDB はアイテムがインデックスのキー属性を持つ場合にのみ、そのアイテムをセカンダリインデックスに書き込むので、めったに設定されない属性に対するインデックスは自然と小さいままです。
アイテムで GSI のパーティションキー(またはソートキー)を欠くと、DynamoDB はそれをインデックスに書き込みません。プレースホルダーも、null の行もありません。アイテムは不在です。
ですから、すべてのアイテムが持つ status 属性をインデックスしてはいけません。クエリしたいアイテムだけがそもそも持つ属性を考案しましょう。そのインデックスに対する Query は、それらだけを読み取ります。
インデックスに供給するベーステーブルを思い描きましょう。キーを持つアイテムだけが向こう側へ渡ります。
キーを持つ(オープンな)アイテムだけがインデックスに複製されます。クローズされたアイテムは決して入りません。これはシングルテーブル設計と同じキー整形の習慣です。キーはアクセスパターンのために整形します。
実例: 「オープンなチケットだけ」
サポートチケットのテーブルを取り上げます。ベーステーブルは、ID でチケットを取得し、あるアカウントのチケットを一覧するためにキー付けされています。
| PK | SK | attributes |
|---|---|---|
| TICKET#a91f | DETAIL | subject, body, priority, openState |
| ACCOUNT#88 | TICKET#a91f | subject, priority, openState |
テーブルの生涯にわたって、ほとんどのチケットは最終的にクローズされます。しかし、エージェントが一日中叩くダッシュボードのクエリは「すべてのオープンなチケットを古い順に見せて」です。数百万件の中に隠れた数百行です。
パーティションキー openBucket とソートキー openedAt を持つ GSI を定義し、オープンなチケットにだけ openBucket を書き込みます。チケットが作成されたときに設定し、チケットが解決されたときに REMOVE します。
| PK | SK | openBucket | openedAt | |
|---|---|---|---|---|
| TICKET#a91f | DETAIL | OPEN | 2026-06-23T09:14:00Z | ← open: in the index |
| TICKET#b02c | DETAIL | OPEN | 2026-06-22T16:40:00Z | ← open: in the index |
| TICKET#77de | DETAIL | (absent) | 2026-05-30T11:02:00Z | ← closed: NOT in the index |
チケット a91f と b02c は openBucket を持つので、GSI に入っています。チケット 77de は解決され
openBucket が取り除かれたので、脱落しました。ダッシュボードは今や 1 つの安価なクエリです。
Query  IndexName = "open-tickets-index"
       KeyConditionExpression: openBucket = "OPEN"
ScanIndexForward: true # oldest firstこれはオープンなチケットだけを読み取ります。チケットがクローズされるにつれ、インデックスはひとりでに縮みます。そのサイズは総数ではなく、オープンなチケットの数を追随します。
1 つの静的なパーティション値("OPEN")で十分なのは、チケットのオープン、解決、ダッシュボードの読み取りが
1 パーティションの上限(毎秒およそ 1,000 書き込みユニットと 3,000 読み取りユニット)を十分に下回っている間です(数百行にわたるダッシュボードのクエリは数読み取りユニットを使います)。セットのサイズは制約ではありません。GSI には 10 GB のコレクション上限がないからです。
その頻度を超えたら、openBucket = "OPEN#" + (hash(ticketId) % N) を書き込み、ダッシュボードを openedAt でマージする N 本の並列クエリとして実行します。書き込みのシャーディングはホットパーティションで扱っています。
それを機能させる遷移は、1 つの更新式です。チケットが解決されたときに属性を取り除きます。
その REMOVE 句と、読み取り側の型付きキー条件は、ExpressionAttributeNames と :val プレースホルダーを自分で手組みする代わりに、DynamoDB 式ビルダーで試作しましょう。
DynoTable でやってみる
スパースインデックスの難しいところは、どのアイテムがインデックスに入り、どれが脱落したかを見ることです。
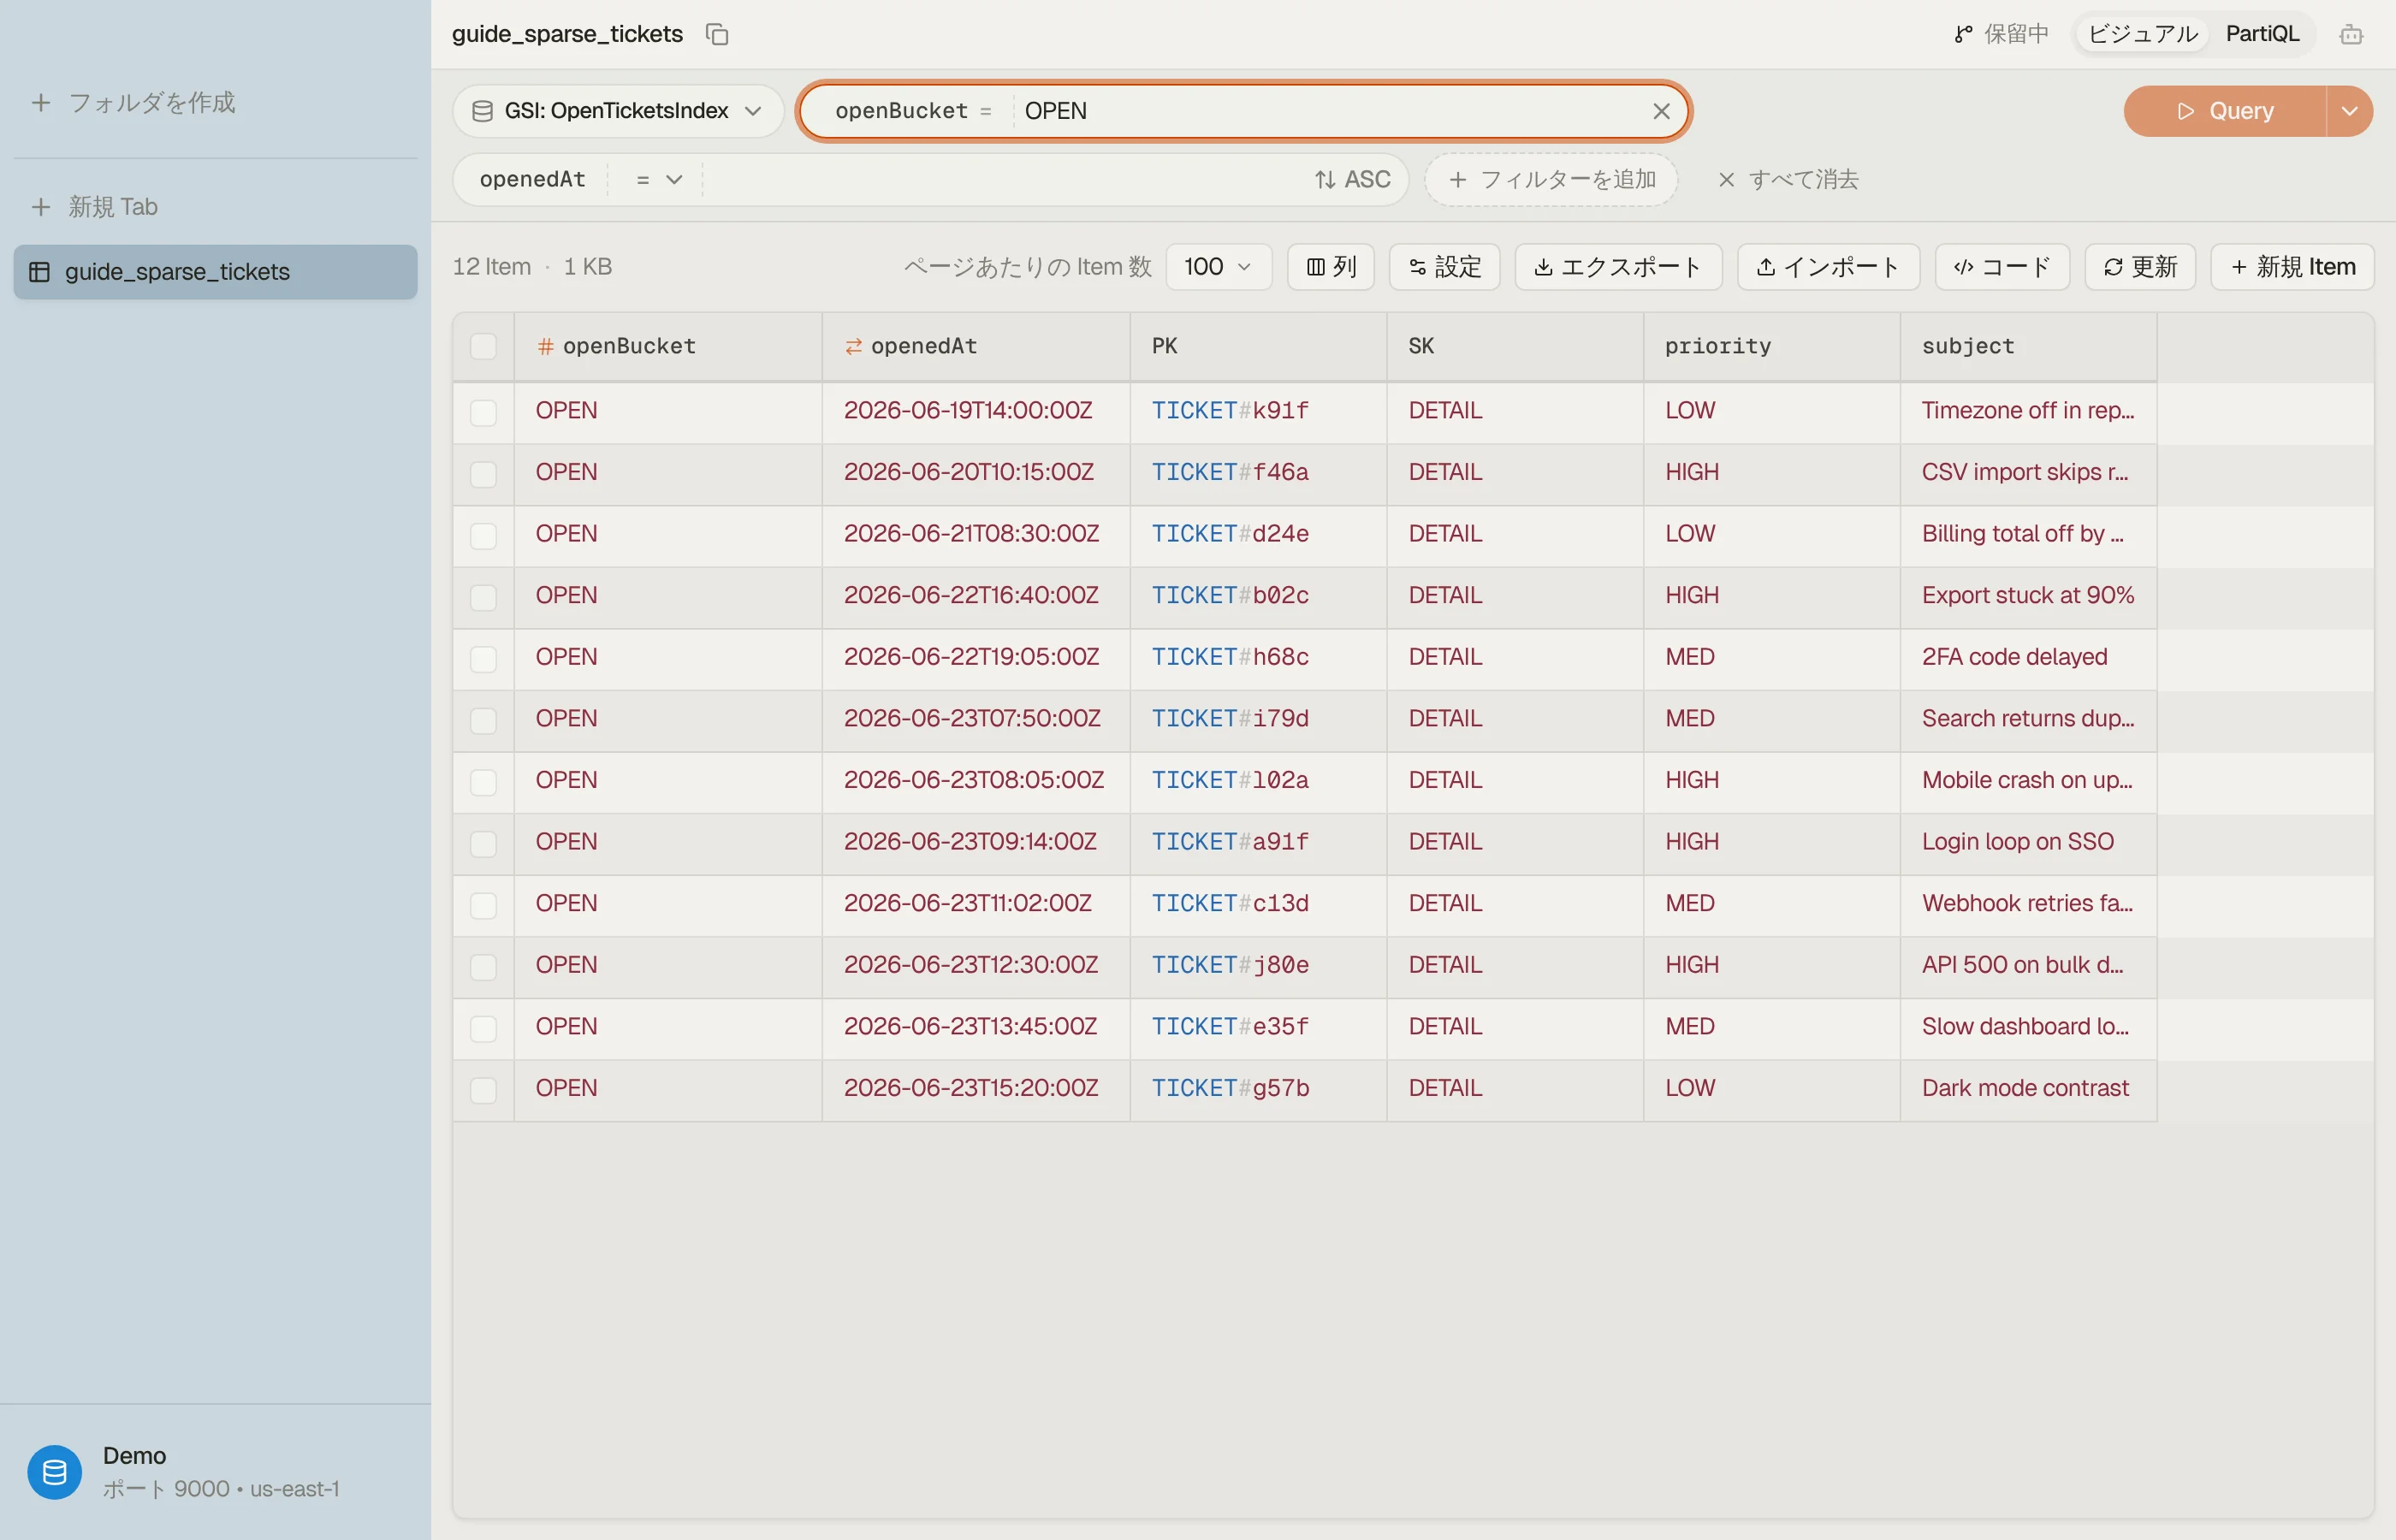
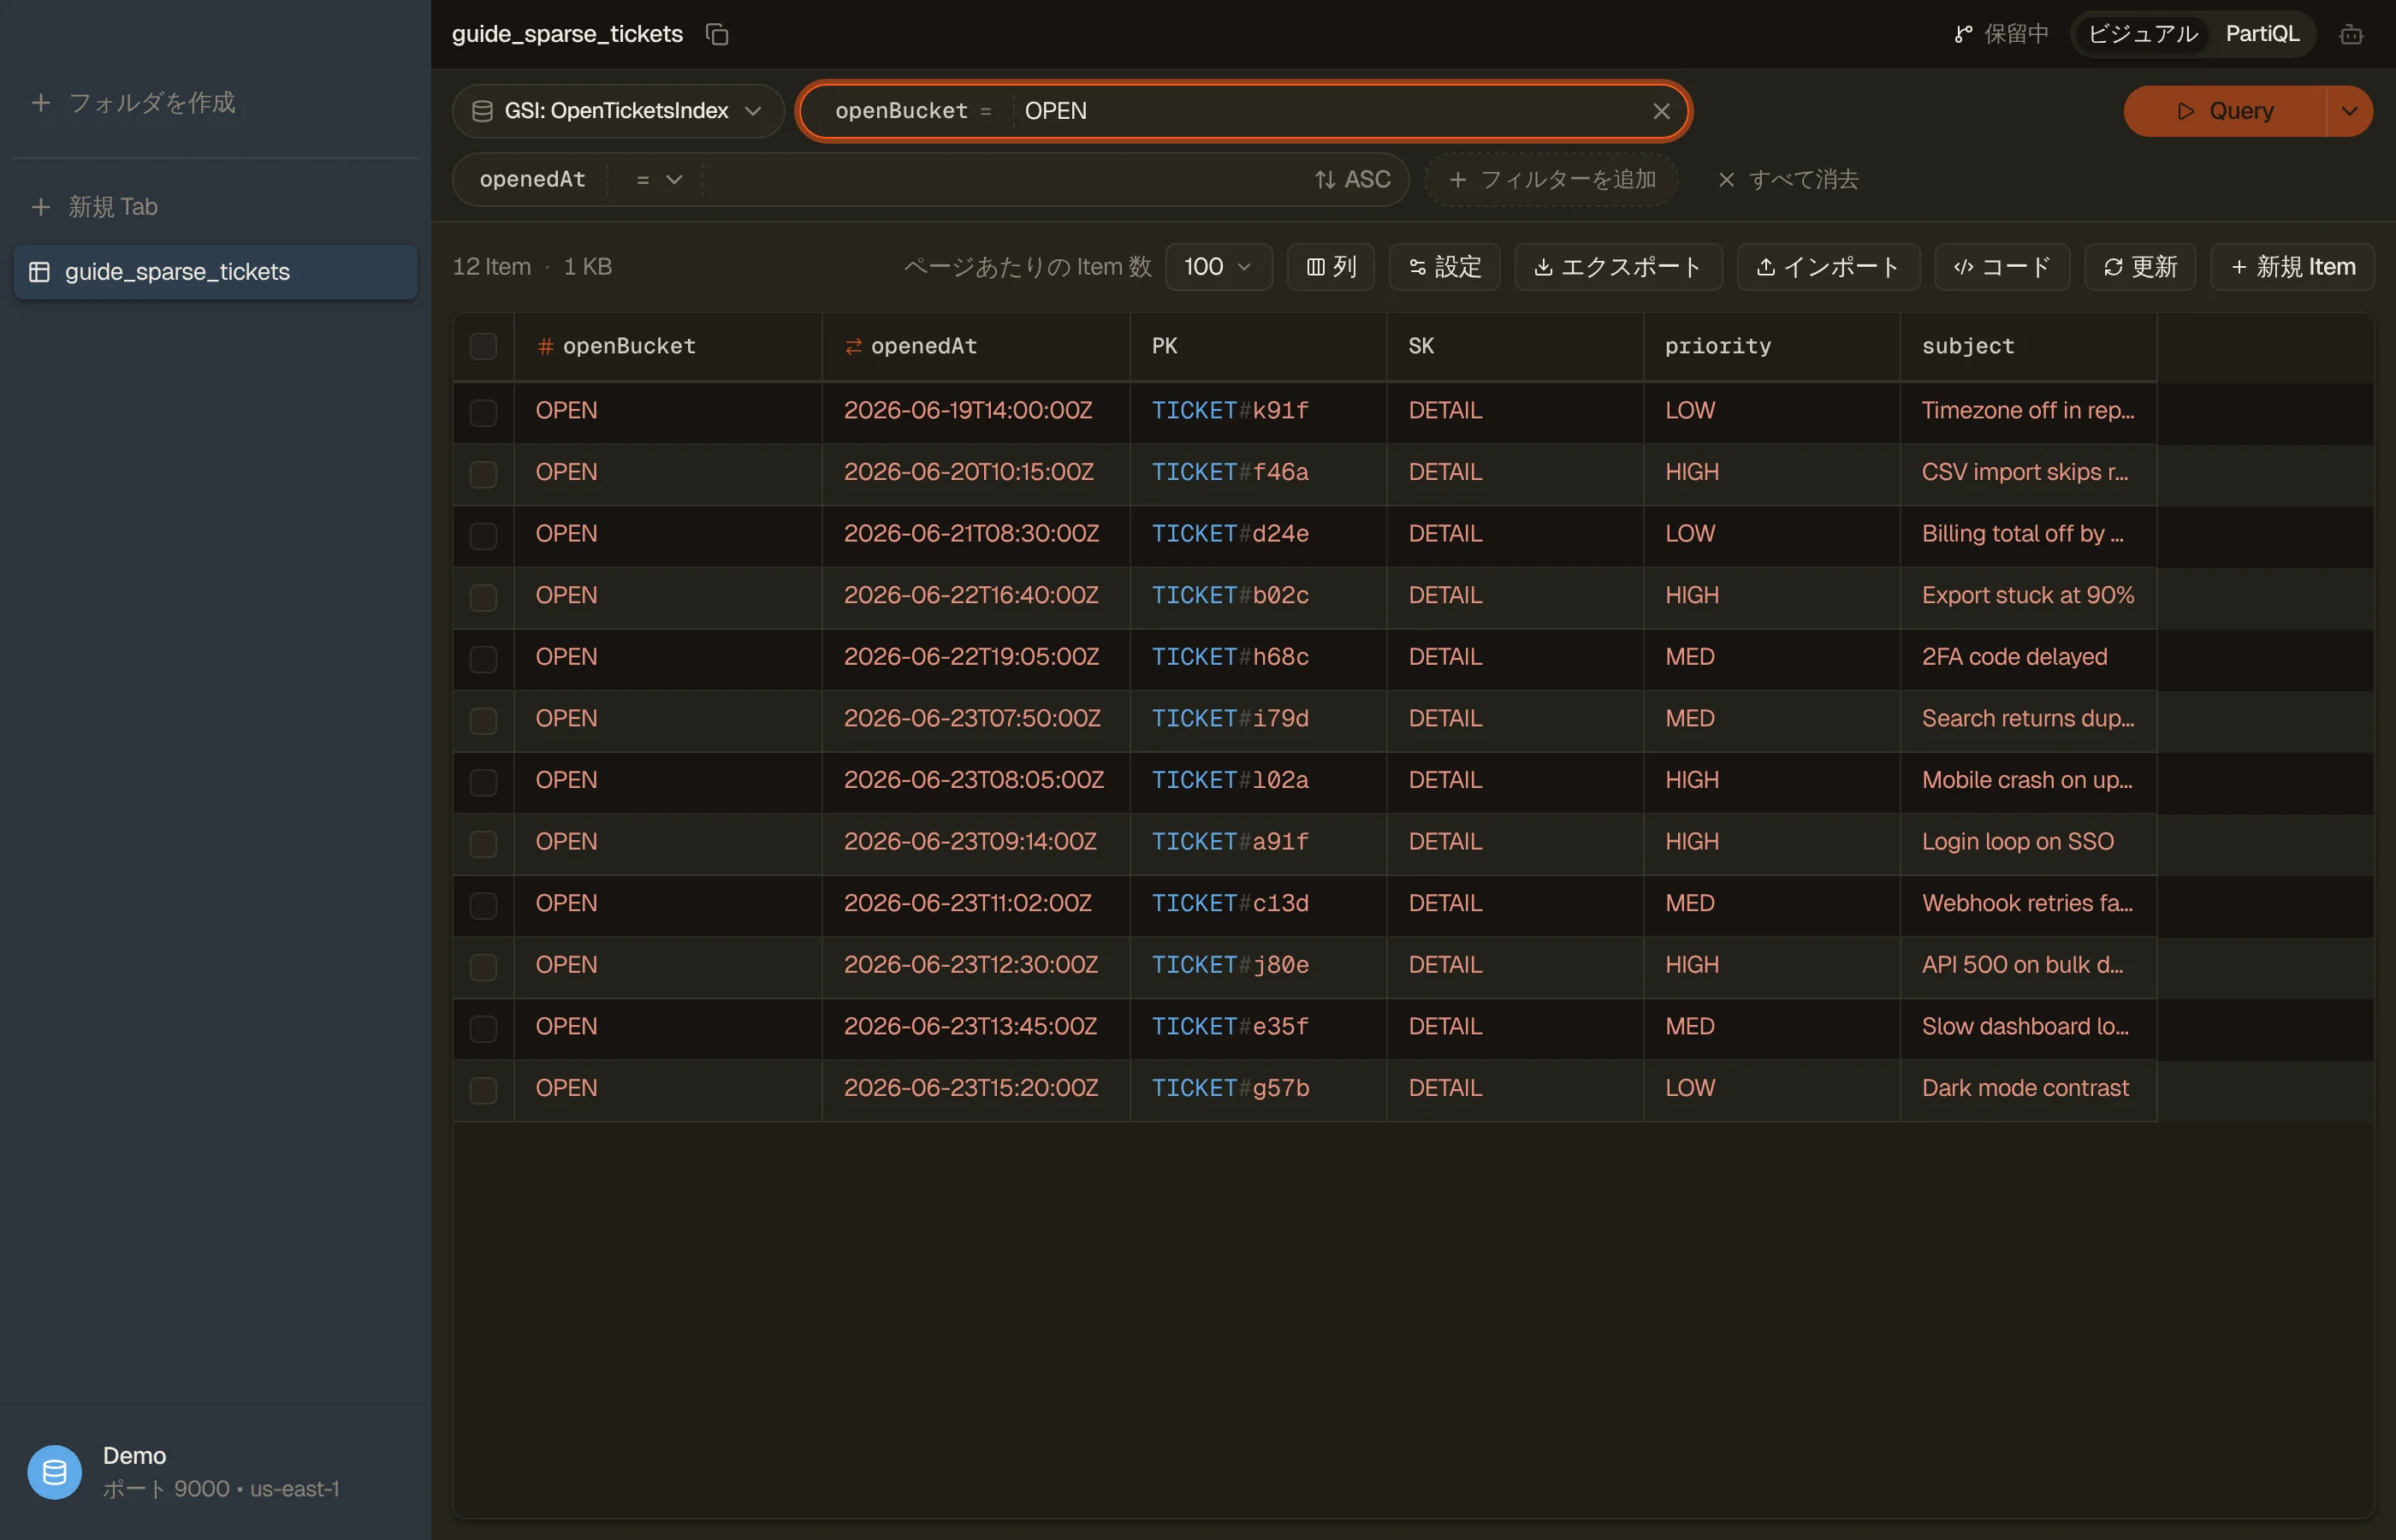
DynoTable では、テーブルビューをセカンダリインデックスに切り替えて、まさに埋まったサブセットを見ることができます。ですから、解決されたチケットが古いキーを引きずったまま残るのではなく、
open-tickets-index を離れたことを確認できます。


落とし穴と次のステップ
- キーを空白化するのではなく、取り除く。
openBucket = ""を書き込むとValidationExceptionで失敗し(空文字列は有効なインデックスキーではありません)、書き込み全体が拒否されます。インデックスからアイテムを外すには、属性をREMOVEします。 - インデックスは結果整合性。 GSI は非同期に更新されるので、たった今解決されたチケットが短時間まだ現れることがあります。GSI 読み取りは結果整合性のみをサポートします。「このチケットは今オープンか」には、ベースアイテム(
PK = TICKET#<id>、SK = DETAIL)をConsistentRead: trueでGetItemします。 - チェックを書き込みに入れる。 オープンなチケットにだけ行うべき操作(担当の割り当て、返信)には、
ConditionExpression: "attribute_exists(openBucket)"を追加します。解決済みのチケットはConditionalCheckFailedExceptionで失敗します。 - 射影された属性に気を配る。 インデックスに対する
Queryは、そこに射影された属性だけを返します。ダッシュボードにsubjectとpriorityが必要なら、それらを射影するか、ベーステーブルへの 1 回のBatchGetItem(最大 100 キー)で補完します。稼働中のインデックスで射影を増やすには代わりの GSI が必要です。インデックスの射影を参照してください。 - GSI も LSI もスパースにできる。 インデックスしたくないアイテムでは、インデックスのキー属性のいずれかを省きます。LSI の場合、それはソートキーに限られます。通常は GSI のほうが適します。テーブル作成後に追加でき、独自のキースキーマとキャパシティを与えられるからです。GSI と LSI がトレードオフを分解します。
構築して調べるには、DynoTable をダウンロードしてテーブルに向け、データビューをスパース GSI に切り替えましょう。アイテムがインデックスキーを得たり失ったりするたびにクエリを再実行すると、サブセットもそれに合わせて変わります。