DynamoDB でデータをモデル化する方法
SQL では、まずエンティティとリレーションシップをモデル化し、後で問い合わせたものを何でも組み立ててくれるクエリプランナーを信頼します。DynamoDB はそれを逆転させます。モデル化するのは すでに行うとわかっている読み取り で、キーはそれらに応えるために存在します。
結合エンジンも、実行時に戦略を選ぶプランナーもありません。Query は 1 つのキーに沿って 1 つのパーティションを読み、それがパフォーマンス契約のすべてです。
AWS はベストプラクティスガイドではっきりこう述べています: "you shouldn't start designing your schema for DynamoDB until you know the questions it will need to answer."
DynamoDB でデータをどうモデル化しますか?
アプリが行うすべてのクエリをリストアップし、各問いが単一の Query か GetItem に解決するようパーティションキーとソートキーを設計します。一緒に読まれる項目を同居させ、ソートキーで値の範囲を辿り、ベーステーブルが応えられないアクセスパターンには GSI を追加します。
- 問いが仕様です。 名詞は気を散らすものです。
- 各問いは 1 つの
QueryかGetItemでなければならない。 頻繁な問いにScanが要るなら、モデルが間違っています。 - 同居する項目はパーティションキーを共有し、範囲を辿るものはすべてソートキーに入れる。
- ベーステーブルが答えられない頻繁な問いには GSI を使う。 フィルタ付きの
Scanではありません。
モデル化に使うプリミティブ
テーブルには、項目がどの物理パーティションに存在するかを選ぶ パーティションキー(PK)と、そのパーティション 内 で項目を順序づけるオプションの ソートキー(SK)があります。
AWS のコアコンポーネントのドキュメントは、この対を項目のプライマリキーと呼びます。Query は常にちょうど 1 つの PK 値を狙い、SK を範囲指定またはフィルタできます。それがツールキットのすべてです。
以下のすべての決定を駆動する 2 つの帰結があります。
- 一緒に読まれる項目はパーティションキーを共有すべき です。そうすれば 1 つの
Queryが単一の課金対象リクエストでそれらを返します。 - 範囲を辿りたいものすべて(最近のマッチ、上位レーティング)は ソートキー に置かなければなりません。それが
Queryが順序づけ、境界を切れる唯一の属性だからです。
ある問いがベーステーブルの提供する形状と 異なる アクセス形状を必要とするとき、グローバルセカンダリインデックス を追加します。異なる PK/SK の下でのテーブルの再射影です。
(GSI とローカルセカンダリインデックスの違いについては GSI vs LSI を参照してください。)
ステップ 1: 問題をテーブルではなく問いとして捉える
題材は マルチプレイヤーゲームのリーダーボード です。プレイヤー、彼らがプレイするマッチ、そしてシーズンごとのランキングを扱います。players、matches、scores テーブルを描きたくなる衝動に抵抗してください。代わりに、アプリが行うすべての読み取りを書き出します。
- 1 人のプレイヤーのプロフィールを id で取得する。
- あるプレイヤーの最近のマッチを新しい順にリストする。
- あるシーズンの上位 N 人のプレイヤーをレーティング順に表示する。
- 公開ハンドルでプレイヤーを引く(例: プロフィール URL 用)。
それぞれは単一の Query(または GetItem)に解決しなければなりません。それが DynamoDB がスケール時に安価に提供する唯一のアクセス形状だからです。
ある問いがテーブルをスキャンしてしか答えられないなら、それをレイテンシとコストで痛感します。Scan が避けるべき落とし穴である理由は Query vs Scan を参照してください。
この手法全体は、ドメインごとに一度実行する短く順序づけられたパイプラインです。
ステップ 2: キーを、1 つの問いずつ設計する
プレイヤーとそのマッチは一緒に読まれるので、PK と SK という名前の、汎用でオーバーロードされたキー属性を持つ単一のテーブル(シングルテーブルアプローチ)を使います。
プレフィックスは自分で考案します。ここでは PLAYER#、MATCH#、SEASON# が、それ以外は汎用のキーの中でエンティティ型をタグ付けします。
問い 1 と 2(プロフィール + 最近のマッチ)はパーティションを共有するので、両方とも同じ PK にぶら下がります。
| PK | SK | attributes |
|---|---|---|
| PLAYER#u8231 | MATCH#2026-06-23T11:42:07Z#m_51c0 | result=loss, ratingDelta=-15, mapId |
| PLAYER#u8231 | MATCH#2026-06-23T14:05:31Z#m_8f2a | result=win, ratingDelta=+18, mapId |
| PLAYER#u8231 | PROFILE | handle, region, createdAt |
Query PK = "PLAYER#u8231" は、プロフィール、すべてのマッチ、そして(後述の)プレイヤーのシーズン行を 1 回の読み取りで返します。プロフィールだけなら GetItem です。
最近のマッチには、ScanIndexForward = false を付けた SK begins_with "MATCH#" が新しい順にそれらを辿ります。完全な ISO-8601 タイムスタンプが順序を決め、末尾のマッチ id によって、同じ秒の 2 つのマッチが互いを上書きすることを防ぎます。
問い 3 と 4 はそのパーティションからは答えられません。シーズンのランクとハンドルを軸にしており、どちらもベースの PK ではないからです。それぞれに GSI を用意します。
汎用のインデックス属性を 2 対追加します。ランクインデックス用の seasonPartition / seasonSort と、ハンドルインデックス用の handlePartition / handleSort です。
ハンドルのキーはプロフィール項目に置きます。シーズンのキーはプレイヤーごと・シーズンごとに 1 つの項目に置くので、新しいシーズンが始まっても過去のリーダーボードの行は残ります。
| PK | SK | seasonPartition | seasonSort | handlePartition | handleSort |
|---|---|---|---|---|---|
| PLAYER#u8231 | PROFILE | — | — | HANDLE#nighthawk | PLAYER#u8231 |
| PLAYER#u8231 | SEASON#2026-Q2 | SEASON#2026-Q2 | RATING#01842 | — | — |
いまや ScanIndexForward = false を付けてシーズンインデックスを WHERE seasonPartition = "SEASON#2026-Q2" で Query すると、レーティング順にランクづけされたプレイヤーが返ります。それがリーダーボードです。上位 N 人には Limit を追加します。
handlePartition = "HANDLE#…" をキーとする 2 つ目のインデックスは、公開ハンドルをプレイヤー id に 1 回の読み取りで解決します。1 つの物理テーブル、4 つの単一 Query のアクセスパターンです。
GSI は一意性を強制せず、非同期に更新されます。そのため 2 人のプレイヤーが同じハンドルを取得できてしまい、取得したばかりのハンドルがまだ解決できないこともあります。
ハンドルを一意にする必要があるなら、プロフィールと同じ TransactWriteItems の中で、attribute_not_exists でガードした HANDLE#nighthawk マーカー項目を書き込みます。そうすればマーカーへの GetItem がハンドルインデックスの代わりになります。トランザクションは複数属性での一意性で示しています。
ステップ 3: DynoTable でモデルを検証する
各クエリを実行し、期待どおりの項目をちょうど返し、それ以外は何も返さないことを確認します。
DynoTable でテーブルを開き、シーズンインデックスに対してリーダーボードのクエリを実行し、パーティションがランクづけされ境界の切られた状態で返ることを確認します。Scan も、クライアント側のソートもなしにです。

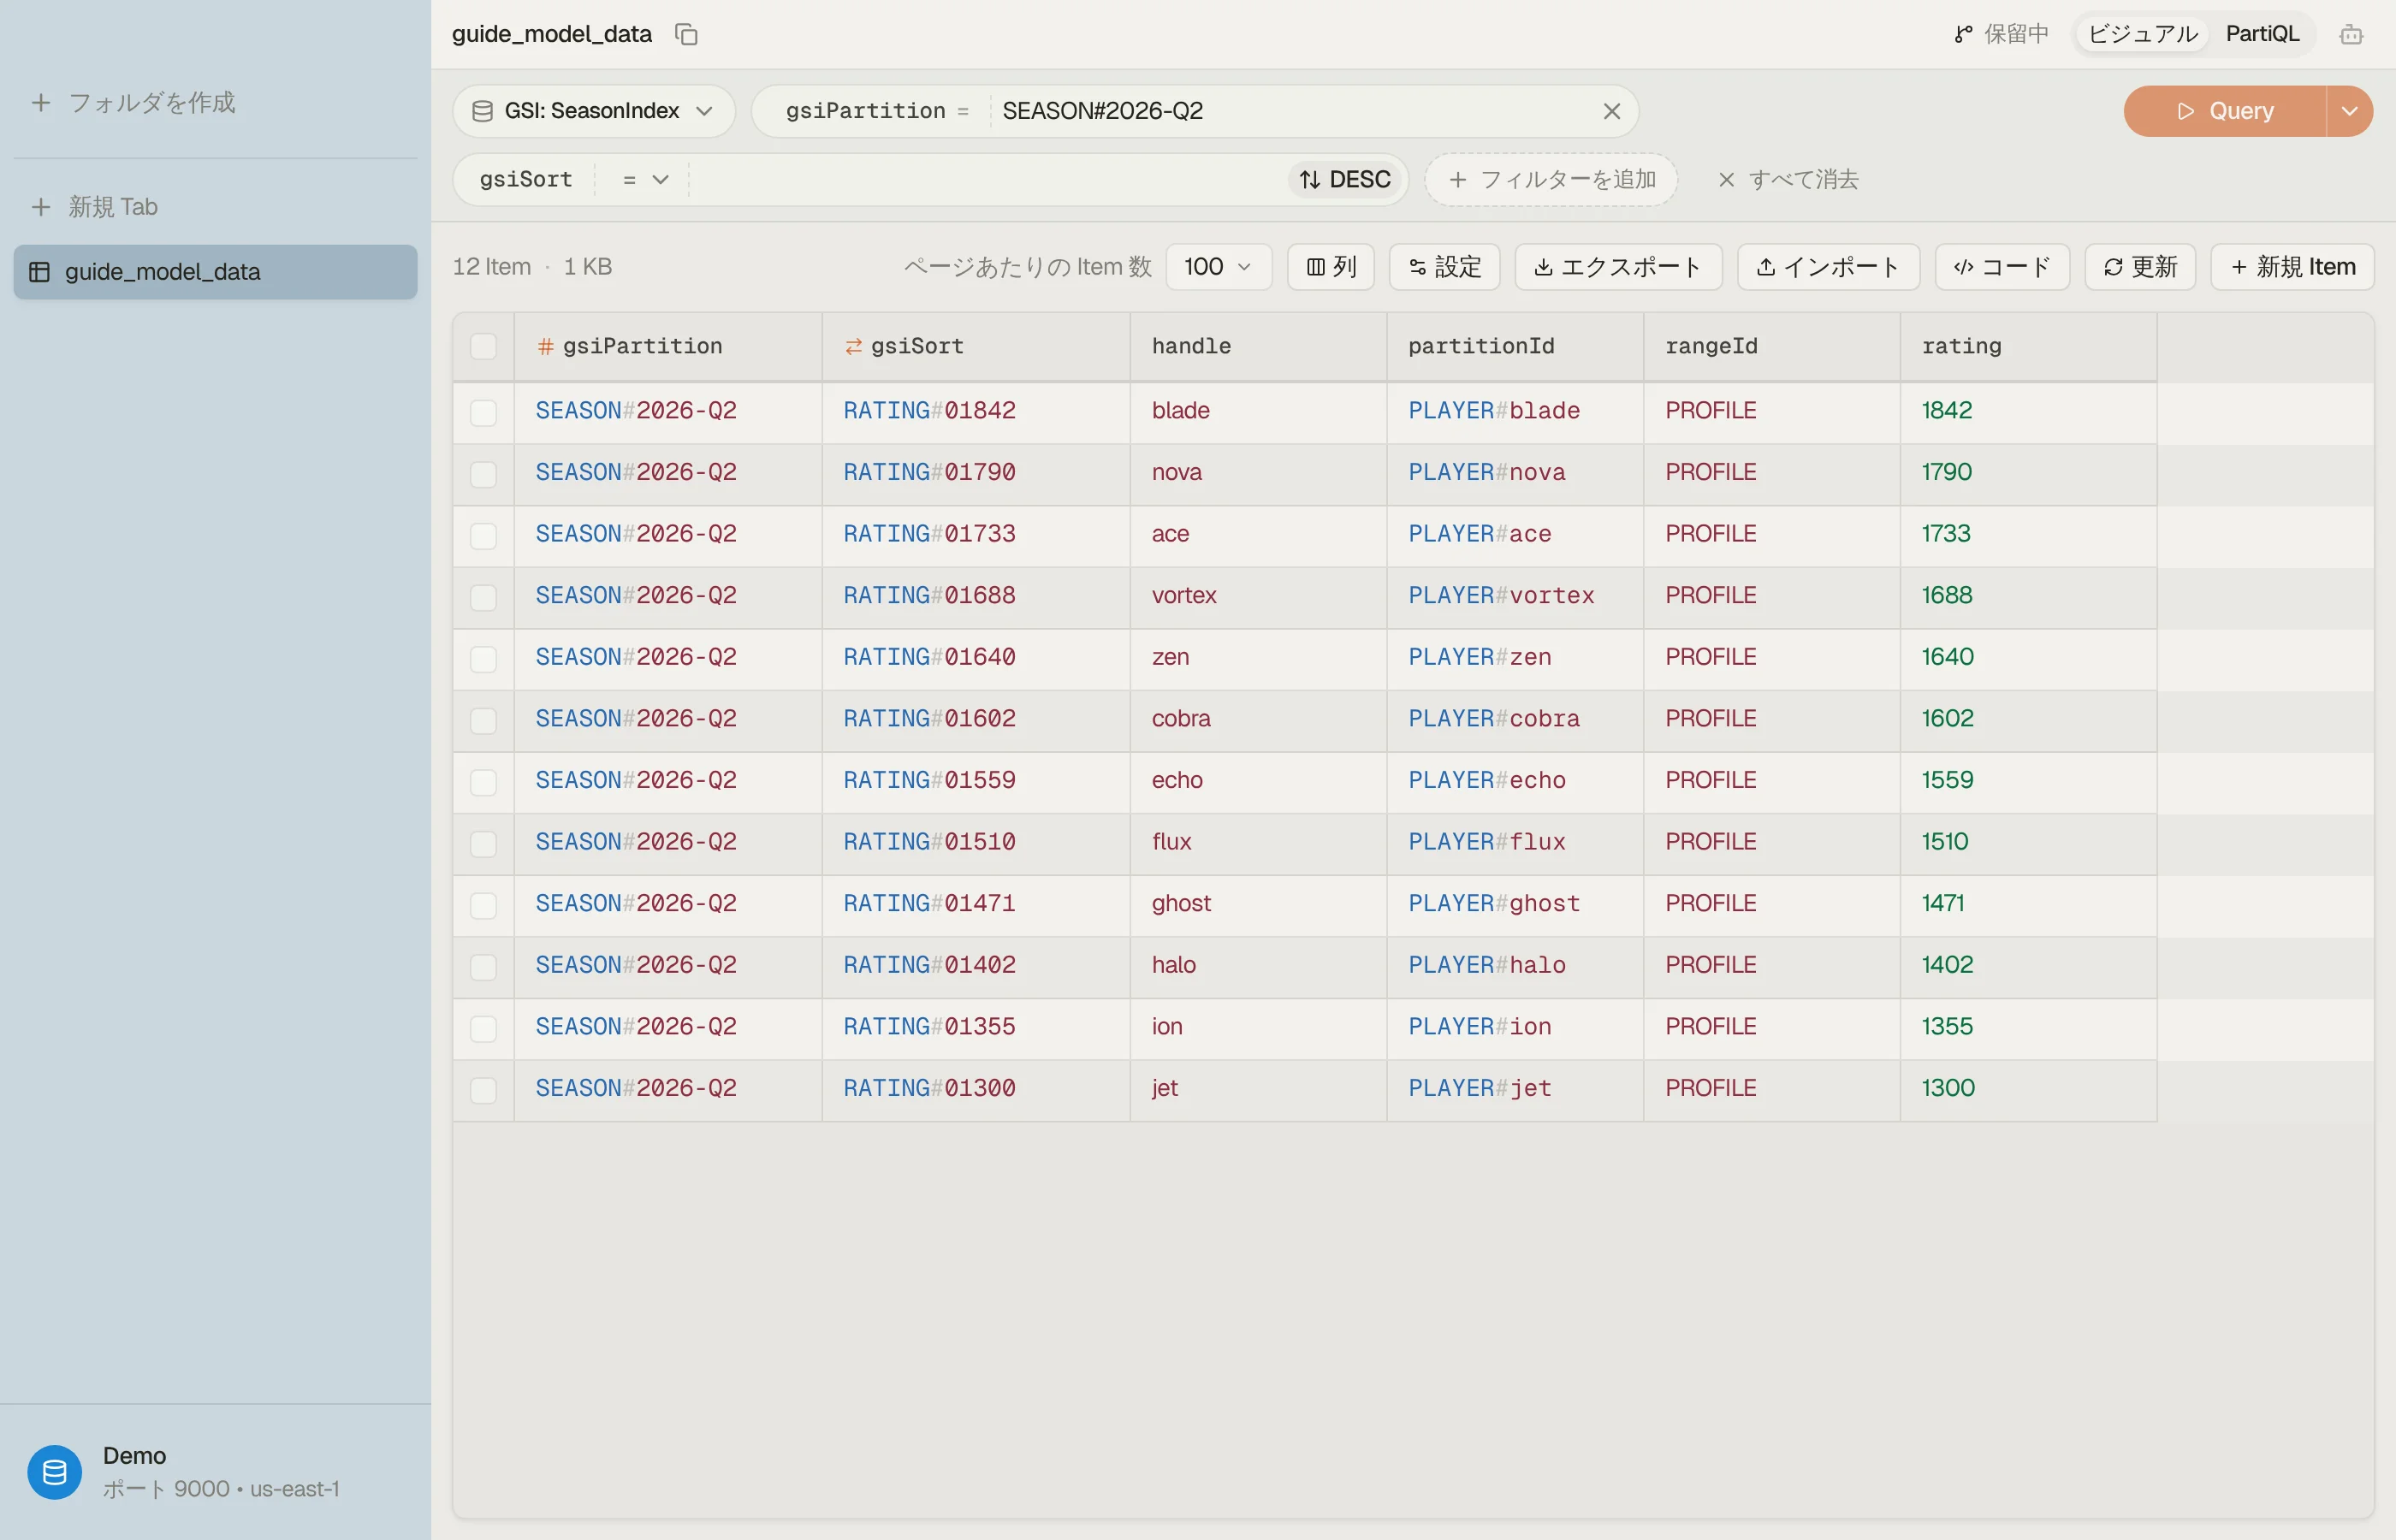

これらのクエリの条件式(begins_with、seasonPartition = :p、プレースホルダー :p のバインディング)を構築するときは、DynamoDB 式ビルダーにやらせましょう。
それが KeyConditionExpression、ExpressionAttributeNames、ExpressionAttributeValues を生成するので、result のような予約語やタイプミスしたプレースホルダーのせいで、実行時に読み取りが ValidationException で失敗することはありません。
ステップ 4: 落とし穴と次のステップ
モデルを出荷する前に確認すべきいくつかの罠です。
- インデックスは問いのリストから追加し、投機的に追加しない。 GSI は、インデックス化する項目ごとに書き込みを 1 回増やし、独自のストレージも持つので、使われない GSI は繰り返しかかるコストです。
- パーティションの熱を監視する。 レーティングが変わるたびにそのシーズンのインデックスキーが書き換わるので、1 つの忙しいシーズンは書き込みを 1 つの GSI キーに集中させ、その上限は毎秒約 1,000 書き込みユニットです。
SEASON#2026-Q2#0..N-1としてシャーディングし、各シャードから上位 N を取得してクライアント側でマージします。サイジングはホットパーティションで扱っています。 - 文字列のソートキー内の数値や時間的なものはすべてゼロ埋めと ISO-8601 に。 バイト順が意図する順序と一致するようにします。
- 新しい頻繁な問い = 新しいキーかインデックスであり、
Scanではない。 後から新しいアクセスパターンが現れたら、キーを拡張します。フィルタでごまかさないでください。
ステップ 2 を先取りするには、無料のシングルテーブル設計ツールが、このようなアクセスパターンのリストを、例のアイテムとコストのヒント付きの PK/SK/GSI プランに変換してくれます。
モデル化して いなかった 問いには、DynoTable の SQL Workbench(有料プラン)が GROUP BY と集計をクライアント側で実行します。
その JOIN は、テーブルのパーティションキー(ソートキーのないテーブル)か GSI のパーティションキーを経由します。このテーブルはソートキーを持つので、この 1 つのテーブルでの自己結合は GSI 経由でのみ動きます。ここでモデル化していない問いは、やはり Scan になります。
DynoTable を試してテーブルを閲覧し、これらのクエリをベーステーブルと各 GSI に対して別々のタブで実行し、設計したアクセスパターンが計画どおりのものを返すのを確かめてください。