DynamoDBテーブルからTypeScriptの型を生成する方法
Postgresならinformation_schemaをイントロスペクトして、そこから型を生成するでしょう。
DynamoDBに相当するものはありません:DynamoDBはアイテムのスキーマを一切保存しません。 サービスが記録するのはキー属性の型だけです。DescribeTableのAttributeDefinitionsは、自身のスコープについて明示的です:各エントリは "describes one attribute in the table
and index key schema"
(AWS APIリファレンス)。
キー以外では、テーブルの説明はいくつかの属性を型なしで名前だけ挙げます:インデックスに射影される属性
(NonKeyAttributes)とベクトルインデックスの属性です。またDescribeTimeToLiveはTTL属性の名前を返します。テーブルの残り50個の属性は、どこにも記録されていません。
したがって「DynamoDBからTypeScriptの型を生成する」は、常に次の3つのいずれかを意味します:形を自分で宣言する、コードで書いたスキーマから導出する、あるいは実際に存在するアイテムから推論する。
DynamoDBテーブルのTypeScript型を得るには?
テーブルのアイテムの形を返すAPIはありません。DescribeTableはキー属性しか知りません。選択肢は:
interfaceを手書きして境界でバリデーションする(Zodスキーマなら型とランタイムチェックが1つの成果物になります)、書いたスキーマから型が得られるスキーマファーストのライブラリを使う、あるいは実際のアイテムから形を推論する(スクリプトで、またはDynoTableのようにテーブルをスキャンしてTypeScriptの
interface、Zodスキーマ、JSON Schemaをエクスポートするツールで)、のいずれかです。
方法1:interfaceを手書きし、境界でバリデーションする
AWS SDKはアイテムに型を付けてくれません。v3のDocumentクライアントはアイテムをRecord<string, any>として返すため、GetCommand / QueryCommandの結果から読むプロパティはすべて未チェックのanyです。素の
as Ticketキャストは問題なくコンパイルされ、ランタイムで嘘をつきます。だからこそ厳密なバージョンは、
interfaceとランタイムチェックを組み合わせます:
import {z} from 'zod';

const Ticket = z.object({
  PK: z.string(), // TICKET#<id>
  SK: z.string(), // META
  status: z.enum(['open', 'pending', 'closed']),
  minutesSpent: z.number(),
  escalatedTo: z.string().optional() // sparse attribute
});
type Ticket = z.infer<typeof Ticket>;

const {Item} = await doc.send(new GetCommand({TableName: 'Tickets', Key: key}));
const ticket = Ticket.parse(Item); // typed AND verified1つのスキーマで2つの仕事です:z.inferが静的な型を与え、parseがそれに一致しないアイテムを捕まえます。スキーマレスなストアでは、それは必ず起こります。スキーマが記録するのは、あなたが保存するつもりだったものです。古いライタがminutesSpentを文字列として保存していたことを妨げるものは何もなく、手書きの型はデータの進化とともに静かにずれていきます。
生の(Documentクライアントを介さない)API出力を扱うなら、ワイヤ上の形が型タグ付きのDynamoDB-JSON
({"S": "..."}、{"N": "123"})であることを忘れないでください。マーシャリングを参照し、スキーマを書く間は
DynamoDB JSONコンバータでサンプルをワイヤ形式とプレーン形式の間で行き来させてください。
方法2:スキーマファーストのライブラリ
ElectroDBやDynamoDB-Toolboxのようなツールキットは、ドリフトの問題を書き込み側から攻めます: コードでエンティティスキーマを書くと、ライブラリがTypeScriptの型を導出し、かつ自身が実行するすべての読み書きでその形を強制します。これは手に入る中で最も強い保証です。スキーマを書くのはあなたであって、ライブラリが発見してくれるわけではありません。既存のテーブルに向けるなら、やはりまずアイテムの形を自分でリバースエンジニアリングする必要があり、ライブラリの外で書かれたアイテムはその保証の外にあります。これらが合うのは、初日からすべてのエンティティがツールキットを通る、グリーンフィールドのシングルテーブル設計です。
方法3:実際のアイテムから型を推論する
既存のテーブルにとって、真実はデータそのものです。サンプルをスキャンし、形の和集合を取り、各属性が現れる頻度を数えます:
const typeOf = (value: unknown): string =>
  value === null
    ? 'null'
    : value instanceof Set
      ? 'Set<string | number>'
      : value instanceof Uint8Array
        ? 'Uint8Array'
        : Array.isArray(value)
          ? 'unknown[]'
          : typeof value === 'object'
            ? 'Record<string, unknown>'
            : typeof value; // string | number | boolean

const seen = new Map<string, {types: Set<string>; n: number}>(); // attr -> types + count
let count = 0;
let key: Record<string, unknown> | undefined;
do {
  const page = await doc.send(new ScanCommand({TableName: 'Tickets', ExclusiveStartKey: key}));
  for (const item of page.Items ?? []) {
    count++;
    for (const [attr, value] of Object.entries(item)) {
      const entry = seen.get(attr) ?? {types: new Set<string>(), n: 0};
      entry.types.add(typeOf(value));
      entry.n++;
      seen.set(attr, entry);
    }
  }
  key = page.LastEvaluatedKey;
} while (key && count < 5000);

// optional (?) when the attribute was missing from some sampled items
const fields = [...seen].map(
  ([attr, {types, n}]) =>
    `  ${JSON.stringify(attr)}${n < count ? '?' : ''}: ${[...types].join(' | ')};`
);
console.log(`// inferred from ${count} items\nexport interface Item {\n${fields.join('\n')}\n}`);素朴なバージョンがすぐにぶつかる、現実世界の落とし穴:
- スパース属性。 1つのテーブル内のDynamoDBアイテムは異なる属性を持てます。アイテムの80%に存在する属性は
optionalであって、欠落ではありません。存在の有無だけでなく、属性ごとの頻度を追跡してください (上のnカウンター)。 - エンティティの混在。 シングルテーブル設計では、
ACCOUNT#とTICKET#のアイテムがテーブルを共有し、両方をマージした1つのinterfaceは役に立ちません。型属性でサンプルを分割し(エンティティごとに1つのseenマップ)、エンティティごとに1つの型を出力してください。 - 型の衝突。 同じ属性がこちらでは
N、あちらではSとして保存されているのは、実在する(そしてよくある) データのバグです。黙って片方を選ぶのではなく、ユニオンとして表面化させてください。タグの全セットはデータ型にあります。 - サンプルはサンプルです。 まれなアイテムにしか現れない属性は、最初の5,000件には含まれないかもしれず、どちらにせよスキャンには読み取りキャパシティのコストがかかります (query vs scan)。まれなものをカバーするには各エンティティのアイテムを個別にQueryし、境界でのバリデーション(方法1)も続けてください:parseの失敗が、サンプルが見逃した属性を教えてくれます。
DynoTableでの推論
DynoTableのテーブルダイアログは、ネストされたパスを含め、上記のサンプリングと頻度の追跡を実行します:
テーブルを開き、タブのツールバーの 設定 ボタンを押し、インデックス を選んでテーブルをインデックス化 をクリックします。DynoTableはライブの進捗表示付きでテーブルをサンプリングし、見つかった属性(
commonData.statusのようにドット区切りパスで表されるネストされたものを含む)を、その型と、スキャンした行全体で必須か任意かとともに記録します。テーブルをインデックス化 がスキャンするのは最大10,000アイテムなので、まれなアイテムにしか現れない属性は欠けることがあります。まれなエンティティをカバーするには、そのエンティティのクエリを開いてページを取得してください:取得したアイテムはインデックスに追加されます (テーブルの概要とインデックス作成)。
エクスポート をクリックしてフォーマットを選びます:
- TypeScript:
interface。 - Zod:
z.object(...)スキーマ(Standard-Schema互換)。 - JSON Schema:draft 2020-12。
- TypeScript:
クリップボードにコピーするか、ファイルに保存します。

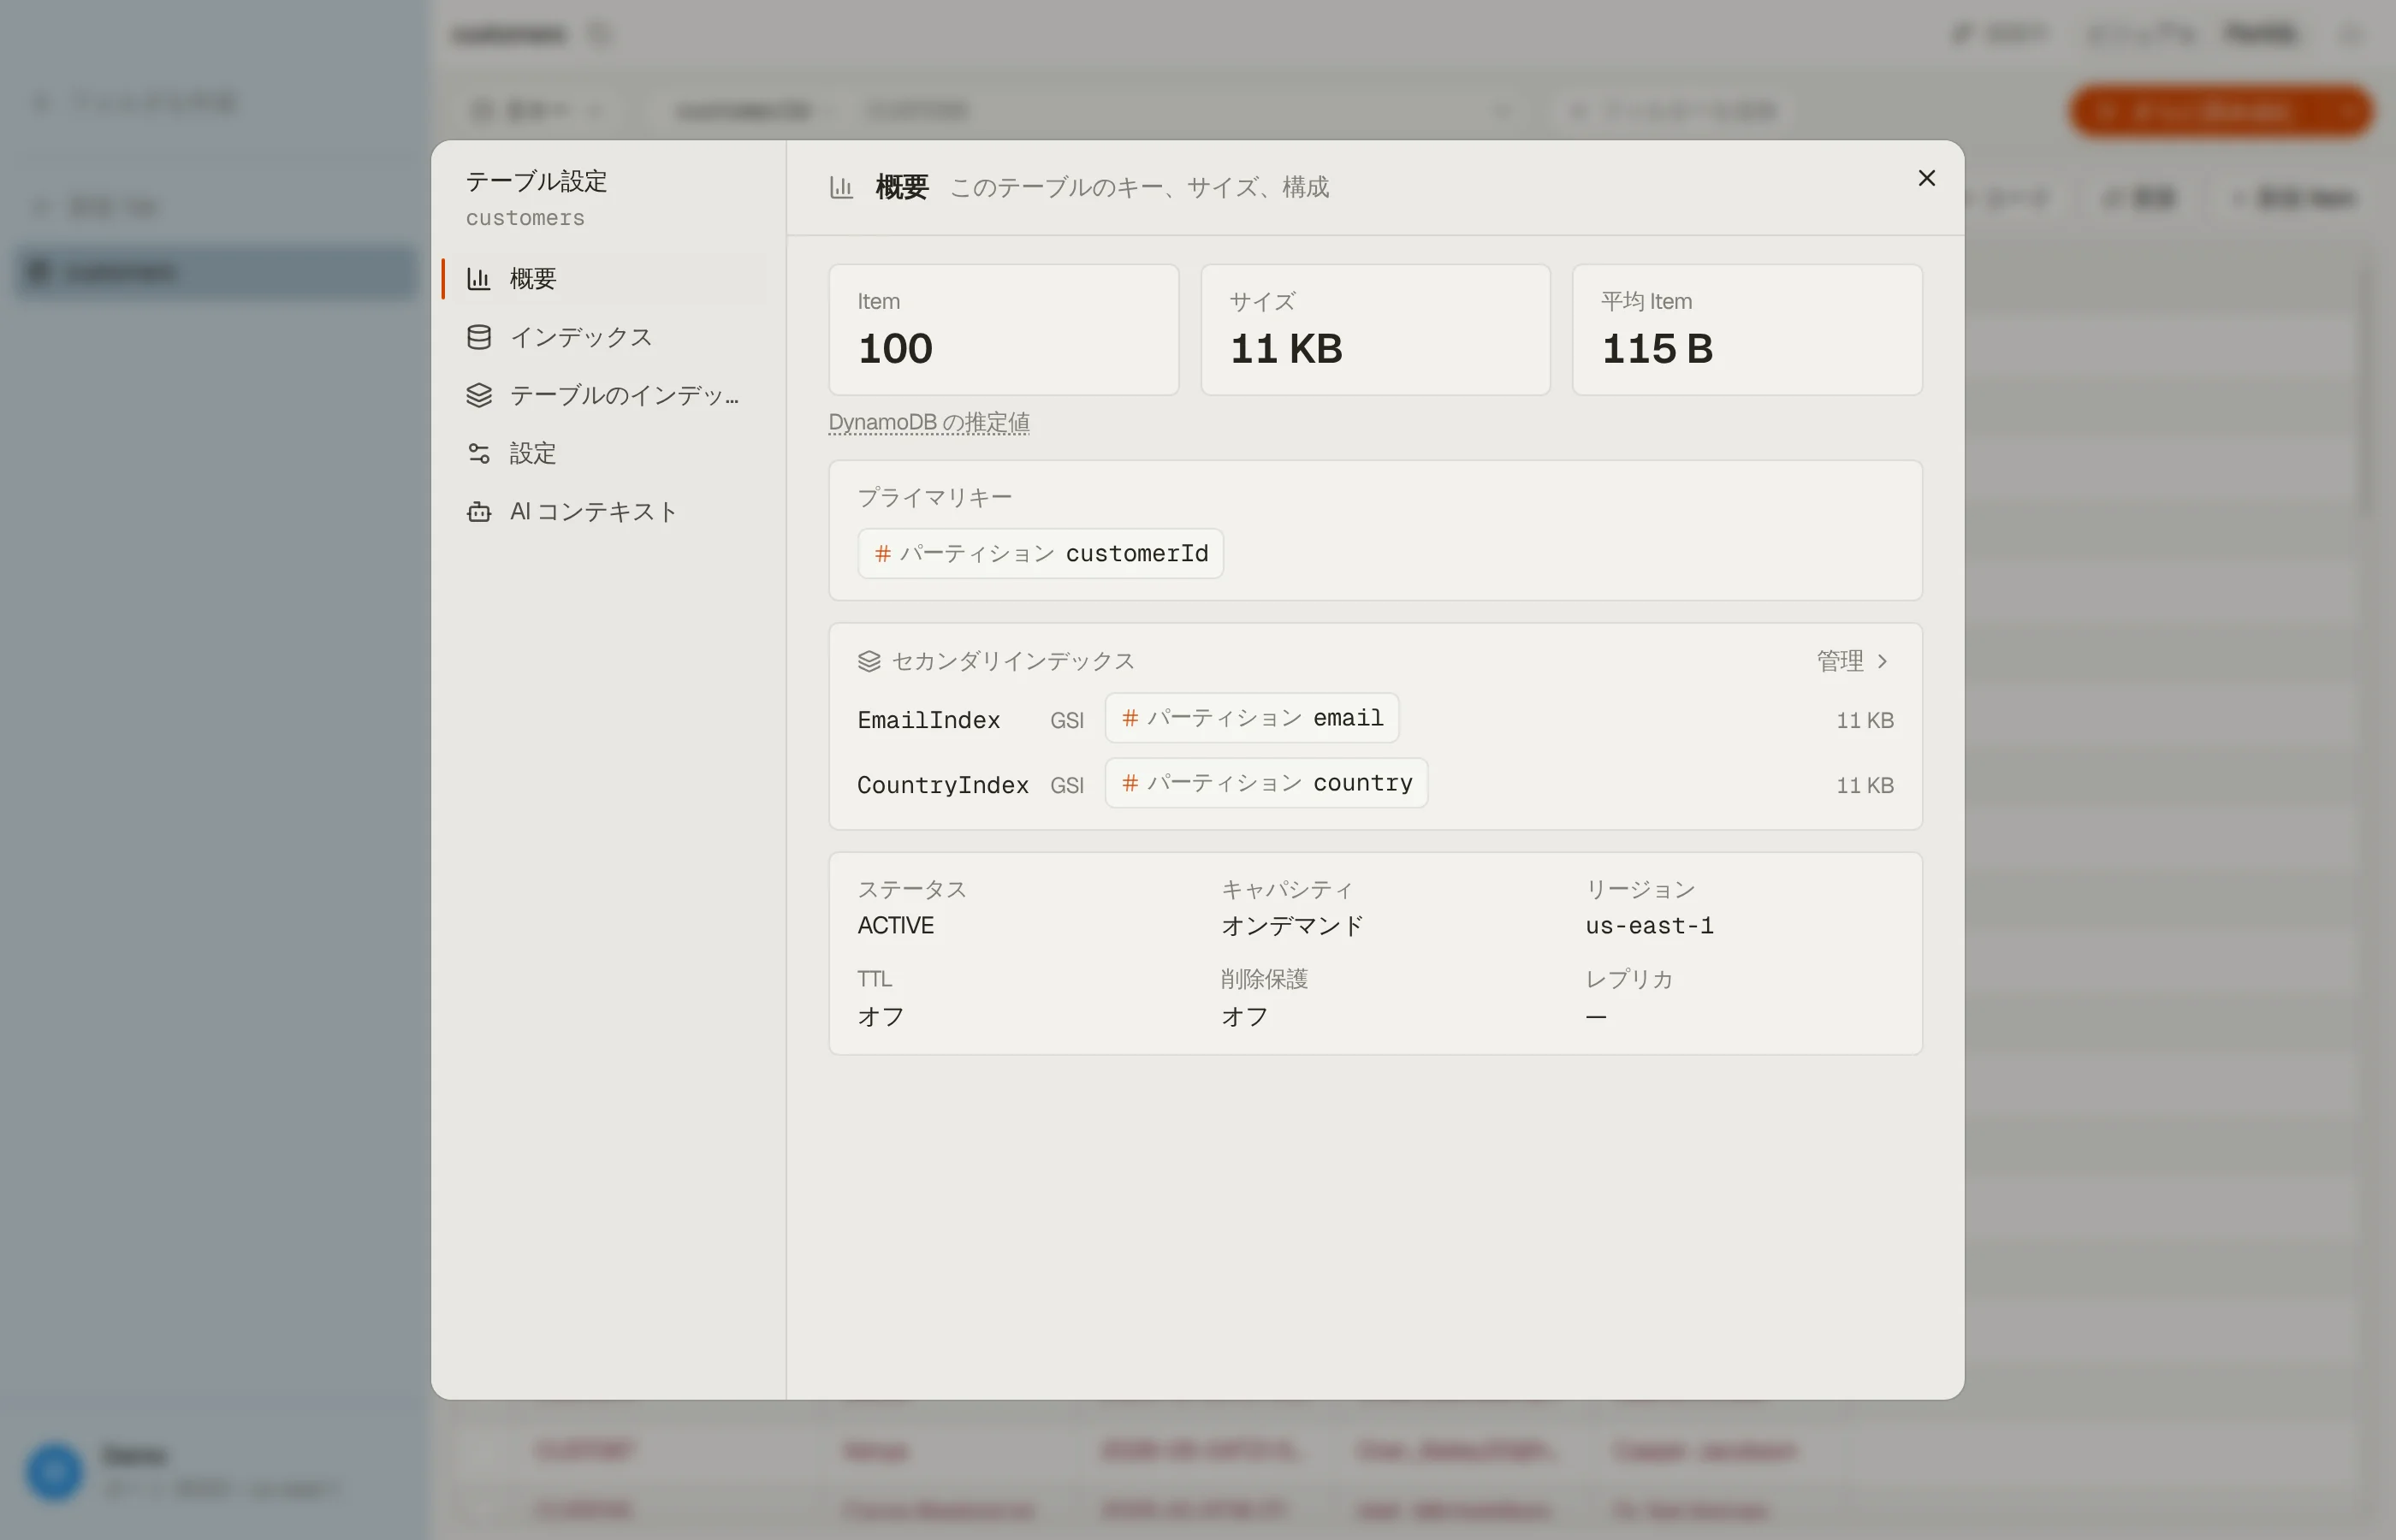

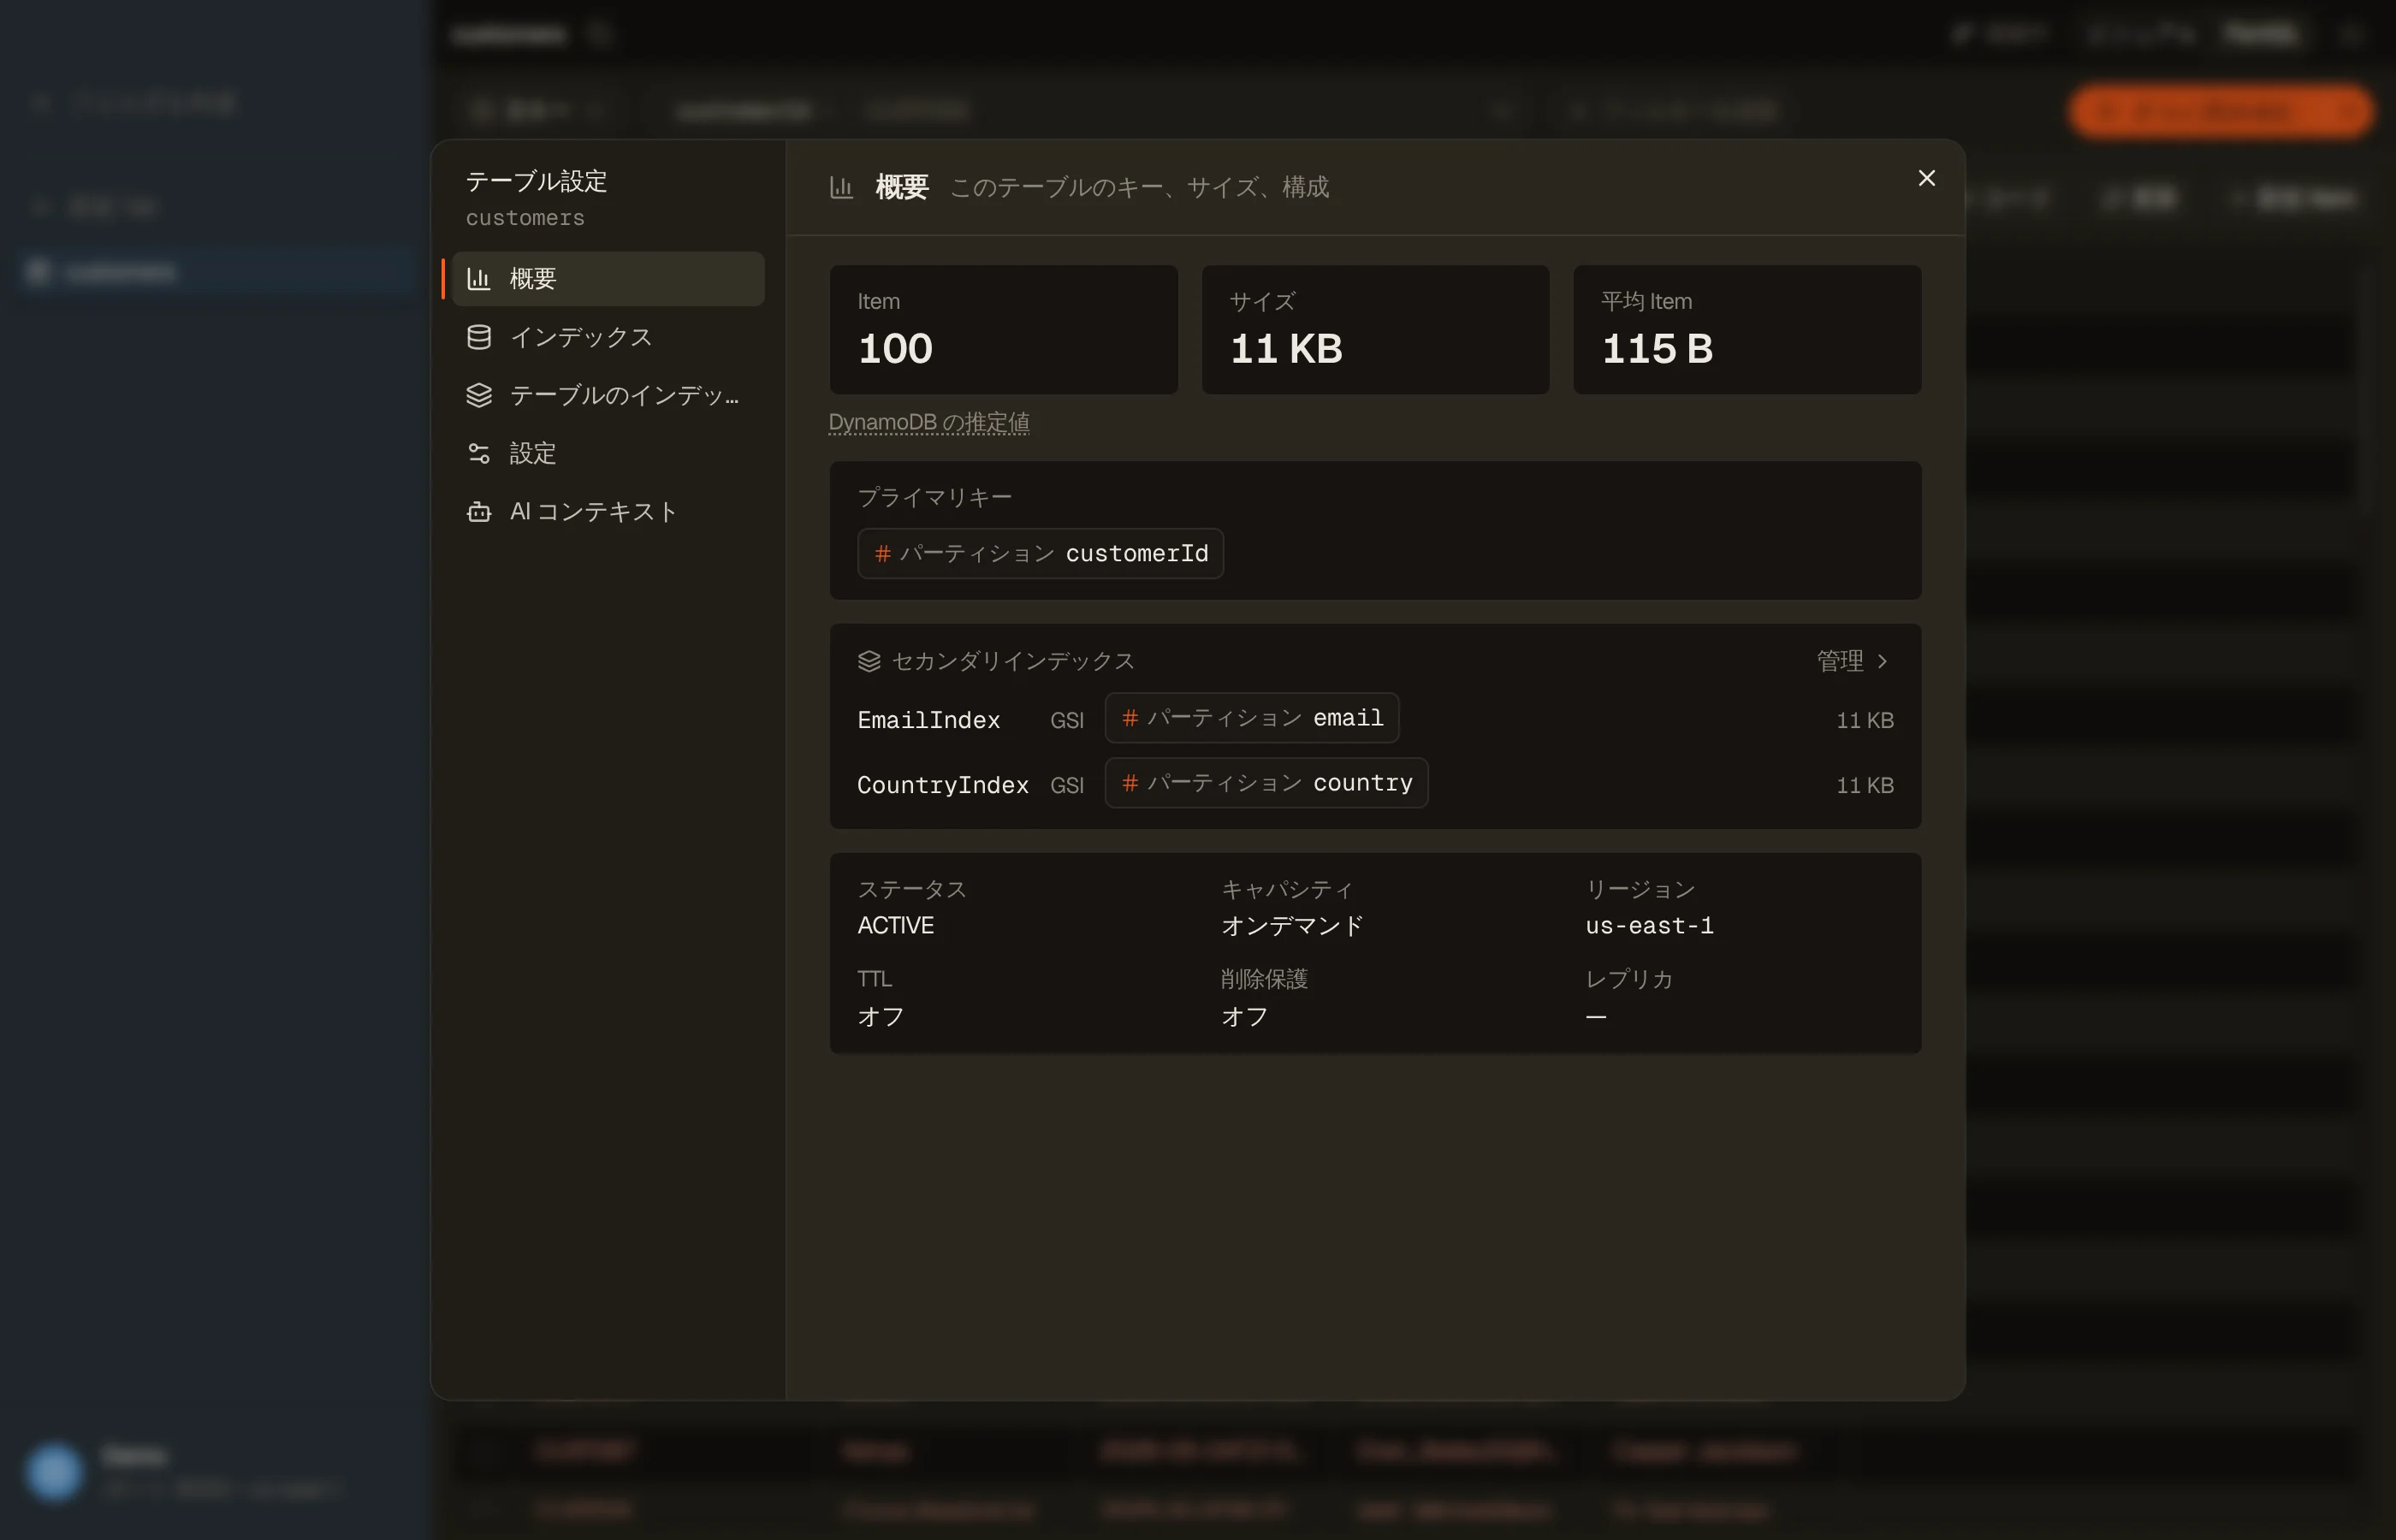
このエクスポートは、サンプリングしたすべてのアイテムにわたる1つの型です。シングルテーブル設計では、エンティティの混在の落とし穴で説明した手順どおり、型属性で手作業で分割してください。
生成されたすべてのスキーマは、サンプリングされたアイテムから推論されたものであるという注記で始まります: レビューすべき出発点であって、権威ある契約ではありません。任意かどうかはインデックス作成中に各属性が現れた頻度を反映し、プライマリキーの属性は常に必須としてマークされます。インデックス作成には通常の DynamoDB読み取りコストがかかり、データが変わった後は 再インデックス で状況を更新できます。
よくある質問
DescribeTableから型を生成できますか?キー属性についてだけです。AttributeDefinitionsがカバーするのはテーブルとインデックスのキースキーマで、それ以外にサービスが名前を挙げるのは射影される属性、TTL属性、ベクトル属性だけで、型はありません。イントロスペクトできるサーバー側のアイテムスキーマは存在しないのです。
既存の本番テーブルに型を付ける最善の方法は?まず推論し、それから固めます:実際のアイテムをサンプリングして(スクリプトかDynoTableのインデックス済みエクスポートで)実際の形を取得し、レビューし、自分で管理するZodスキーマかスキーマファーストのライブラリのエンティティに昇格させます。そうすれば将来のドリフトは境界で捕まります。
1つのテーブルに複数のエンティティ型がある場合は?エンティティごとに1つの型で、マージした1つの型には決してしません。型属性(またはキーのプレフィックス)でサンプルを分割し、それぞれに個別の interfaceを生成してください。それらの判別可能なユニオンがテーブルの型です。
生成された型で必須のはずのフィールドがオプションになっているのはなぜですか?サンプリングされたどれかのアイテムがそれを持っていなかったからです。スキーマレスなストアでは、オプションかどうかはサンプルが示したものです。そのアイテムがバックフィルすべきレガシー行なのか (マイグレーションを参照)、設計上オプションな属性なのかを確認してください。
型はDynamoDBのセットやバイナリもカバーしますか?フォーマットによります。DynoTableのTypeScriptエクスポートは、セットを(文字列または数値の)Set、バイナリをUint8Arrayとして型付けし、Zodエクスポートはz.set(...)とz.instanceof(Uint8Array)を使います。
JSON Schemaにはセット型もバイナリ型もないため、セットは配列に、バイナリはbase64文字列になります。マーシャリングで扱っているのと同じマッピングの癖です。サンプルを
DynamoDB JSONコンバータでラウンドトリップさせて、属性がそれぞれの側でどう見えるかを確認してください。
テーブルの形を推測するのはやめましょう:DynoTableをダウンロードして、テーブルをインデックスし、 TypeScript、Zod、またはJSON Schemaをエクスポートしてください。