ダウンタイムなしの DynamoDB 移行
SQL の出身者にとって、移行は ALTER TABLE であり、その一部(型の変更、揮発性のデフォルト値)はすべての行を書き換える間テーブルをロックします。DynamoDB には変更すべきスキーマがありません。属性や新しいエンティティ型の追加は、ただの書き込みです。
難しいのは、新しいデータが応えなければならないアクセスパターンと、世界を止める書き換えなしにそれに応えるようライブデータを再形成することです。
ダウンタイムなしで DynamoDB テーブルを移行するには?
DynamoDB には ALTER TABLE がないため、移行でテーブルがロックされることはありません。属性や新しいソートキーの形は通常の書き込みで追加し、GSI は UpdateTable でオンラインに追加します。テーブル自体のキースキーマは変更できません。そのうえでライブデータを段階的に再形成します。古いアイテムは読み取り時に遅延バックフィルするか、スロットルされたスイープで処理し、移行期間中はデュアルライトします。
- 新しい GSI は古いアイテムを取りこぼします。 そのキー属性を古いアイテムに書き込むまではそうです。オンライン構築は既存のアイテムをコピーしますが、属性を作り出すことはできません。
- すべてのバックフィル書き込みを
attribute_exists(PK)でガードします。 そうしないと、スイープの途中で削除されたアイテムを更新が復活させることがあります。 - キーは不変です。 アイテムを新しい
PK/SKに移すのはコピーと削除で、アイテムごとに 1 つのトランザクションで行うのが最善です。 - 最後はカウントで締めます。 読み取り側を切り替える前に、新しい属性がまだ欠けているアイテムを探す
Scanが 0 を返す必要があります。
列ではなくアクセスパターンとして捉える
1つのテーブルで SaaS のワークスペース製品を運用しているとします。アイテムは PK = "WS#<id>" を使い、SK はエンティティごとにオーバーロードされています:
| PK | SK | attributes |
|---|---|---|
| WS#a91 | META | name, tier |
| WS#a91 | DOC#2026-04-01#x7 | title, author, body |
| WS#a91 | DOC#2026-04-02#k2 | title, author, body |
ここでプロダクトがドキュメントへのコメントと、新しい読み取りを望みます: 「あるメンバーがワークスペース全体で書いたすべてのコメントを、新しい順にリストする」。その最後の節が移行です。新しいエンティティ型だけなら些細なことですが、現在のキーが答えられないクエリに応えることが仕事です。
まず新しいエンティティ型を追加する
コメントは同じパーティション内の新しいアイテムにすぎず、新しいテーブルは要りません:
| PK | SK | attributes |
|---|---|---|
| WS#a91 | CMT#2026-04-01#x7#01HZ... | author, text, createdAt |
PK = "WS#a91" に SK begins_with "CMT#2026-04-01#x7#" を付けた Query が、1つのドキュメントのコメントをリストします。同じパーティションが両方を保持する理由はアイテムコレクションとオーバーロードされたキーを参照してください。
既存のどのクエリにもマッチしないソートキーのプレフィックスを選びましょう。
もしコメントが DOC#2026-04-01#x7#CMT#… を使っていたら、既存の begins_with(SK, "DOC#") の読み取り側はすべて、初日からドキュメントに混ざったコメントを返し始めます。プレフィックスを共有せざるを得ないなら、既存のすべての読み取り側がまずエンティティ型の属性でフィルタするようにしてください。
新しいクエリには GSI が必要
「あるメンバーによるすべてのコメント、新しい順」はベーステーブルでは提供できません。コメントの author は PK でも SK のプレフィックスでもないからです。それは新しいインデックスで、それを選ぶこと自体が独自の決定です。GSI と LSI の比較を参照してください。
LSI はテーブル作成時に存在しなければならないので、ライブテーブルでは GSI が唯一の選択肢です。
汎用的な GSI1 を追加し、そのキー属性を新しいコメントアイテムに書き込みます。値は author と createdAt から導き、ワークスペースにスコープします:
| GSI1PK | GSI1SK |
|---|---|
| WS#a91#MEMBER#u44 | 2026-04-02T09:15:00Z |
Query GSI1 WHERE GSI1PK = "WS#a91#MEMBER#u44" に ScanIndexForward = false を付けると、そのワークスペースでのメンバーごとの新しい順のコメントが得られます。
インデックスをオンラインで構築する
UpdateTable はダウンタイムなしでライブテーブルに GSI を追加します。DynamoDB はバックグラウンドで既存のアイテムをインデックスにバックフィルします。インデックスは完了するまで CREATING(コピーが始まると Backfilling: true)を報告し、その後 ACTIVE に切り替わります(GSI の管理)。
ここに2つの罠があります。1つ目、新しいキーが偏っている GSI は、構築中にベーステーブルの書き込みをスロットリングすることがあります。AWS のアドバイス:
- アプリケーションのトラフィックが最も少ないときに追加し、テーブルとインデックスの Contributor Insights を有効にしてキーの分布を確認します。
OnlineIndexPercentageProgressと、ベーステーブルのWriteThrottleEventsおよびThrottledRequestsを監視します。- "Be prepared to cancel the index creation." バックフィル中であれば削除できます:
aws dynamodb update-table --table-name Workspace --global-secondary-index-updates '[{"Delete":{"IndexName":"GSI1"}}]'。
仕組みはなぜ GSI がベーステーブルをスロットリングするのかにあります。
2つ目、インデックスは ACTIVE になった後でも結果整合性で、ConsistentRead: true を拒否します。
ユーザーが自分の書いたばかりのコメントを見なければならない場合は、ベーステーブルから強力な整合性の GetItem で読み取るか、書き込みのレスポンスから表示してください。なぜ GSI は結果整合性なのかを参照してください。
古いアイテムをバックフィルする
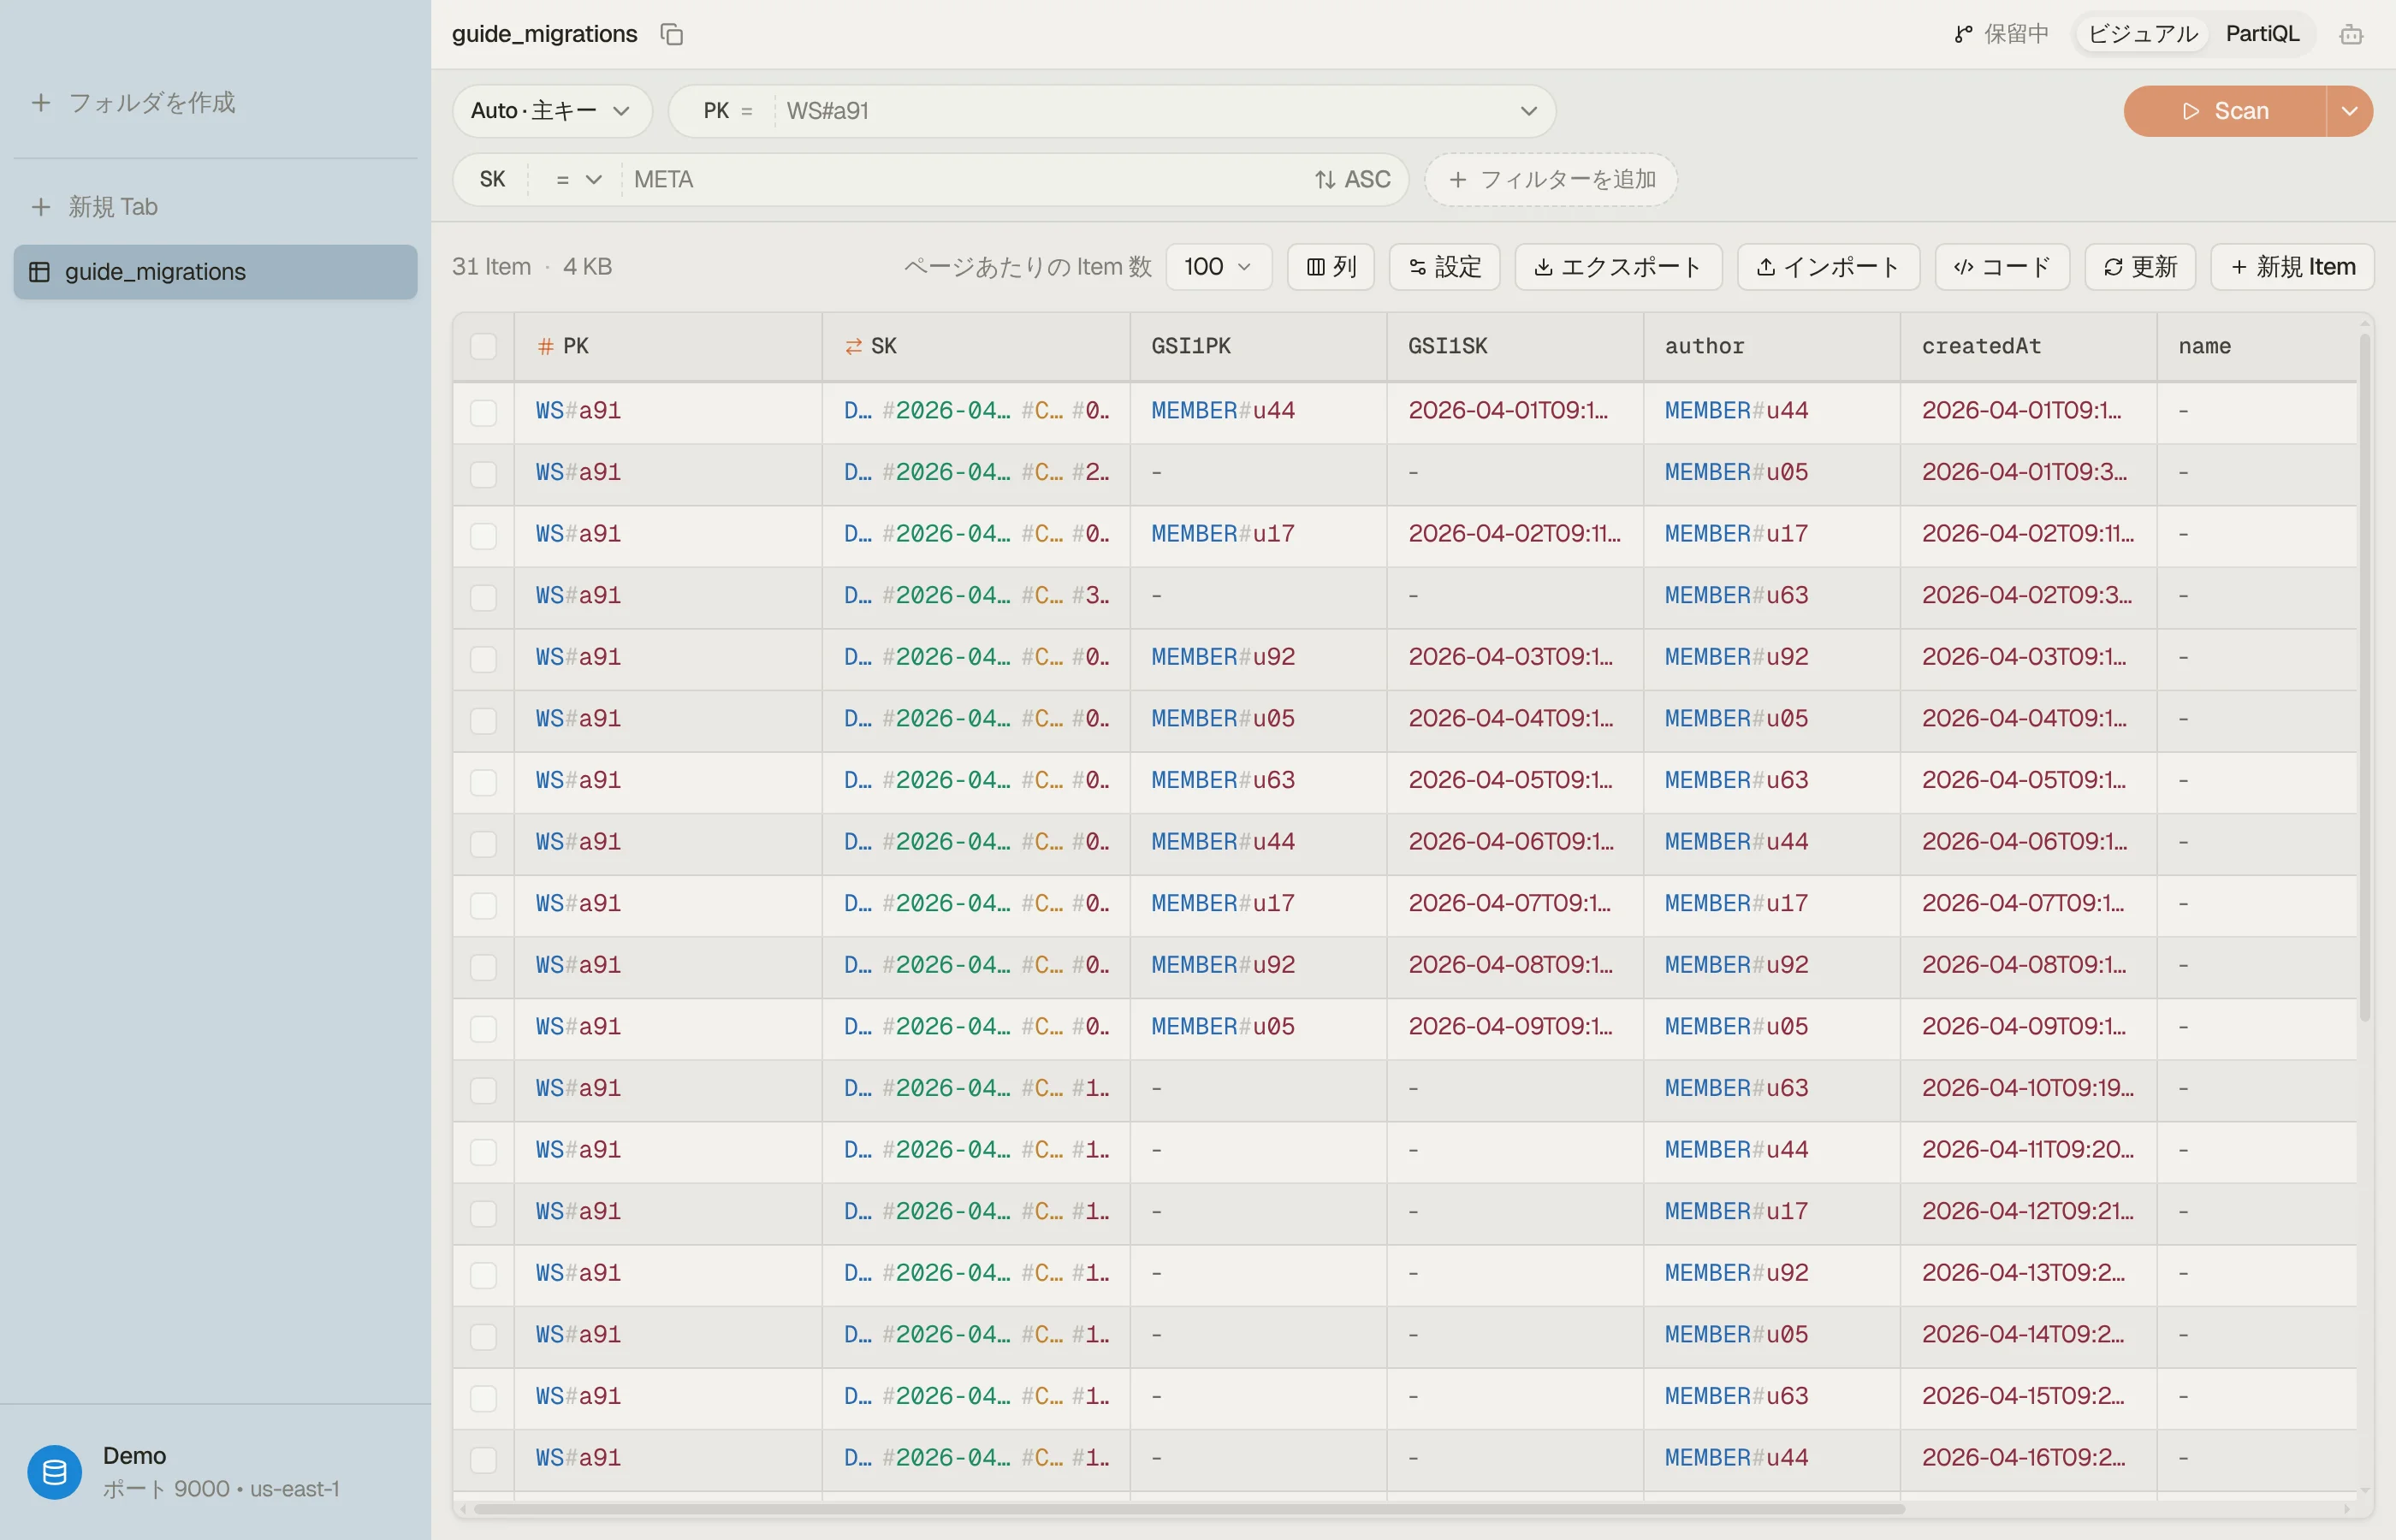
GSI は GSI1PK/GSI1SK を持つアイテムだけをインデックスします。属性が存在する前に書かれた移行前のコメントは、構築が完了した後でも決して現れません。値を追加しなければなりません。
2つの戦略:
| 戦略 | 仕組み | 使うべきとき |
|---|---|---|
| 遅延 | 古いアイテムの読み取り時に、新しい属性を書き戻す | 古いアイテムが頻繁に読まれる。最後にスイープする |
| スイープ | ページネーションされた Scan がすべての古いアイテムを1度更新 | 期限までに GSI を完成させる必要がある |
遅延だけでは決して終わりません。誰も読まない古いコメントは、いつまでも GSI1PK を得ないからです。遅延はコストを分散するために使い、読み取り側を GSI1 に切り替える前にスイープを実行してください。
スイープでは、Scan でページングし(大きなテーブルでは Segment / TotalSegments で分割して並列スキャンにします)、古いコメントごとにガード付きの UpdateItem を 1 回送ります:
# UpdateItem
Key                  PK = "WS#a91", SK = "CMT#2026-04-01#x7#01HZA"
UpdateExpression     SET GSI1PK = :pk, GSI1SK = :sk
ConditionExpression  attribute_exists(PK) AND attribute_not_exists(GSI1PK)
Values :pk = "WS#a91#MEMBER#u44", :sk = "2026-04-01T10:00:00Z"条件の両方の半分が重要です。UpdateItem はアイテムが存在しなければ作成するので、attribute_exists(PK) がないと、Scan のページの後に削除されたコメントが、キーと GSI 属性だけを持つゴーストとして戻ってきます。
attribute_not_exists(GSI1PK) は、デュアルライトのパスがすでに設定した値をスイープが上書きするのを防ぎます。ConditionalCheckFailedException は「スキップ」として扱ってください。DynamoDB Expression Builder は、名前と値のマップを含めて同じリクエストを構築します。
移行期間を通してデュアルライトする
すべての古いアイテムが新しい属性を持つまで、2つの形が共存します。書き込みパスはすべての書き込み(新しいコメントも、古いものへのあらゆる更新も)で GSI1PK/GSI1SK を設定しなければなりません。そうしてギャップだけが縮みます。
読み取り側を GSI1 に向ける前に、ギャップが閉じたことを証明してください。Select: COUNT と
FilterExpression: begins_with(SK, :cmt) AND attribute_not_exists(GSI1PK) を付けた Scan を実行し、すべてのページの Count を合計します。
これはテーブル全体の読み取りのコストがかかります。切り替えるのは 0 になってからだけです。


落とし穴
- 属性の追加 ≠ バックフィル済み。 クエリを信頼する前に、上のカウントで検証しましょう。
- キーをその場で変えるのは書き換え。 アイテムの
PK/SKを変更することはできません。各アイテムを 1 つのTransactWriteItemsで移動します。attribute_not_exists(PK)でガードした新しいキーのPutと、attribute_exists(PK)でガードした古いキーのDeleteです。移動が終わるまで、読み取り側は両方のキーを確認します。 - トランザクショナルな切り替えはない。 テーブル全体が反転する瞬間はありません。両方の形がライブである間も安全であるよう、すべてのステップを設計しましょう。
次のステップ
新しいキーとオーバーロードされたコレクションをシングルテーブル設計で健全性チェックしましょう。
DynoTable を試して、GSI を作成し、それが作成中からバックフィル中、アクティブへと進むのを見守り、GSI1PK が Attribute Not Exists のコメントでフィルタし、取り残されたアイテムを 1 つずつ修正してください。各 Commit は条件でガードされます。