DynamoDBをいつ使うべきか(そしていつ使うべきでないか)
決め手となる問いは「アクセスパターンを前もって把握しているか、そしてそれらはキーベースか?」 です。これを正しく押さえれば、DynamoDBはどんなスケールでも1桁ミリ秒の読み取りを提供します。誤れば、新しい問いが出るたびに新しいインデックスかスキャンが必要になります。
DynamoDBはいつ使うべきか?
- DynamoDBを使うのは、アクセスパターンが既知で、キーベースで、大量であり、管理するサーバーなしにどんなスケールでも予測可能なレイテンシが欲しいとき。
- 避けるのは、アドホッククエリ、豊富な結合、データセット全体にわたる分析が主なワークロードであるとき、またはデータが小さくクエリの形が変わり続けるとき。
- 核心的なトレードオフ: DynamoDBはクエリのために前もって設計させます。その見返りに、キーが負荷を分散している限り、成長してもレイテンシは横ばいのままです。
- これは構文が違うだけのリレーショナルデータベースではありません。そのようにモデリングすることが、最もよくある苦痛の原因です。
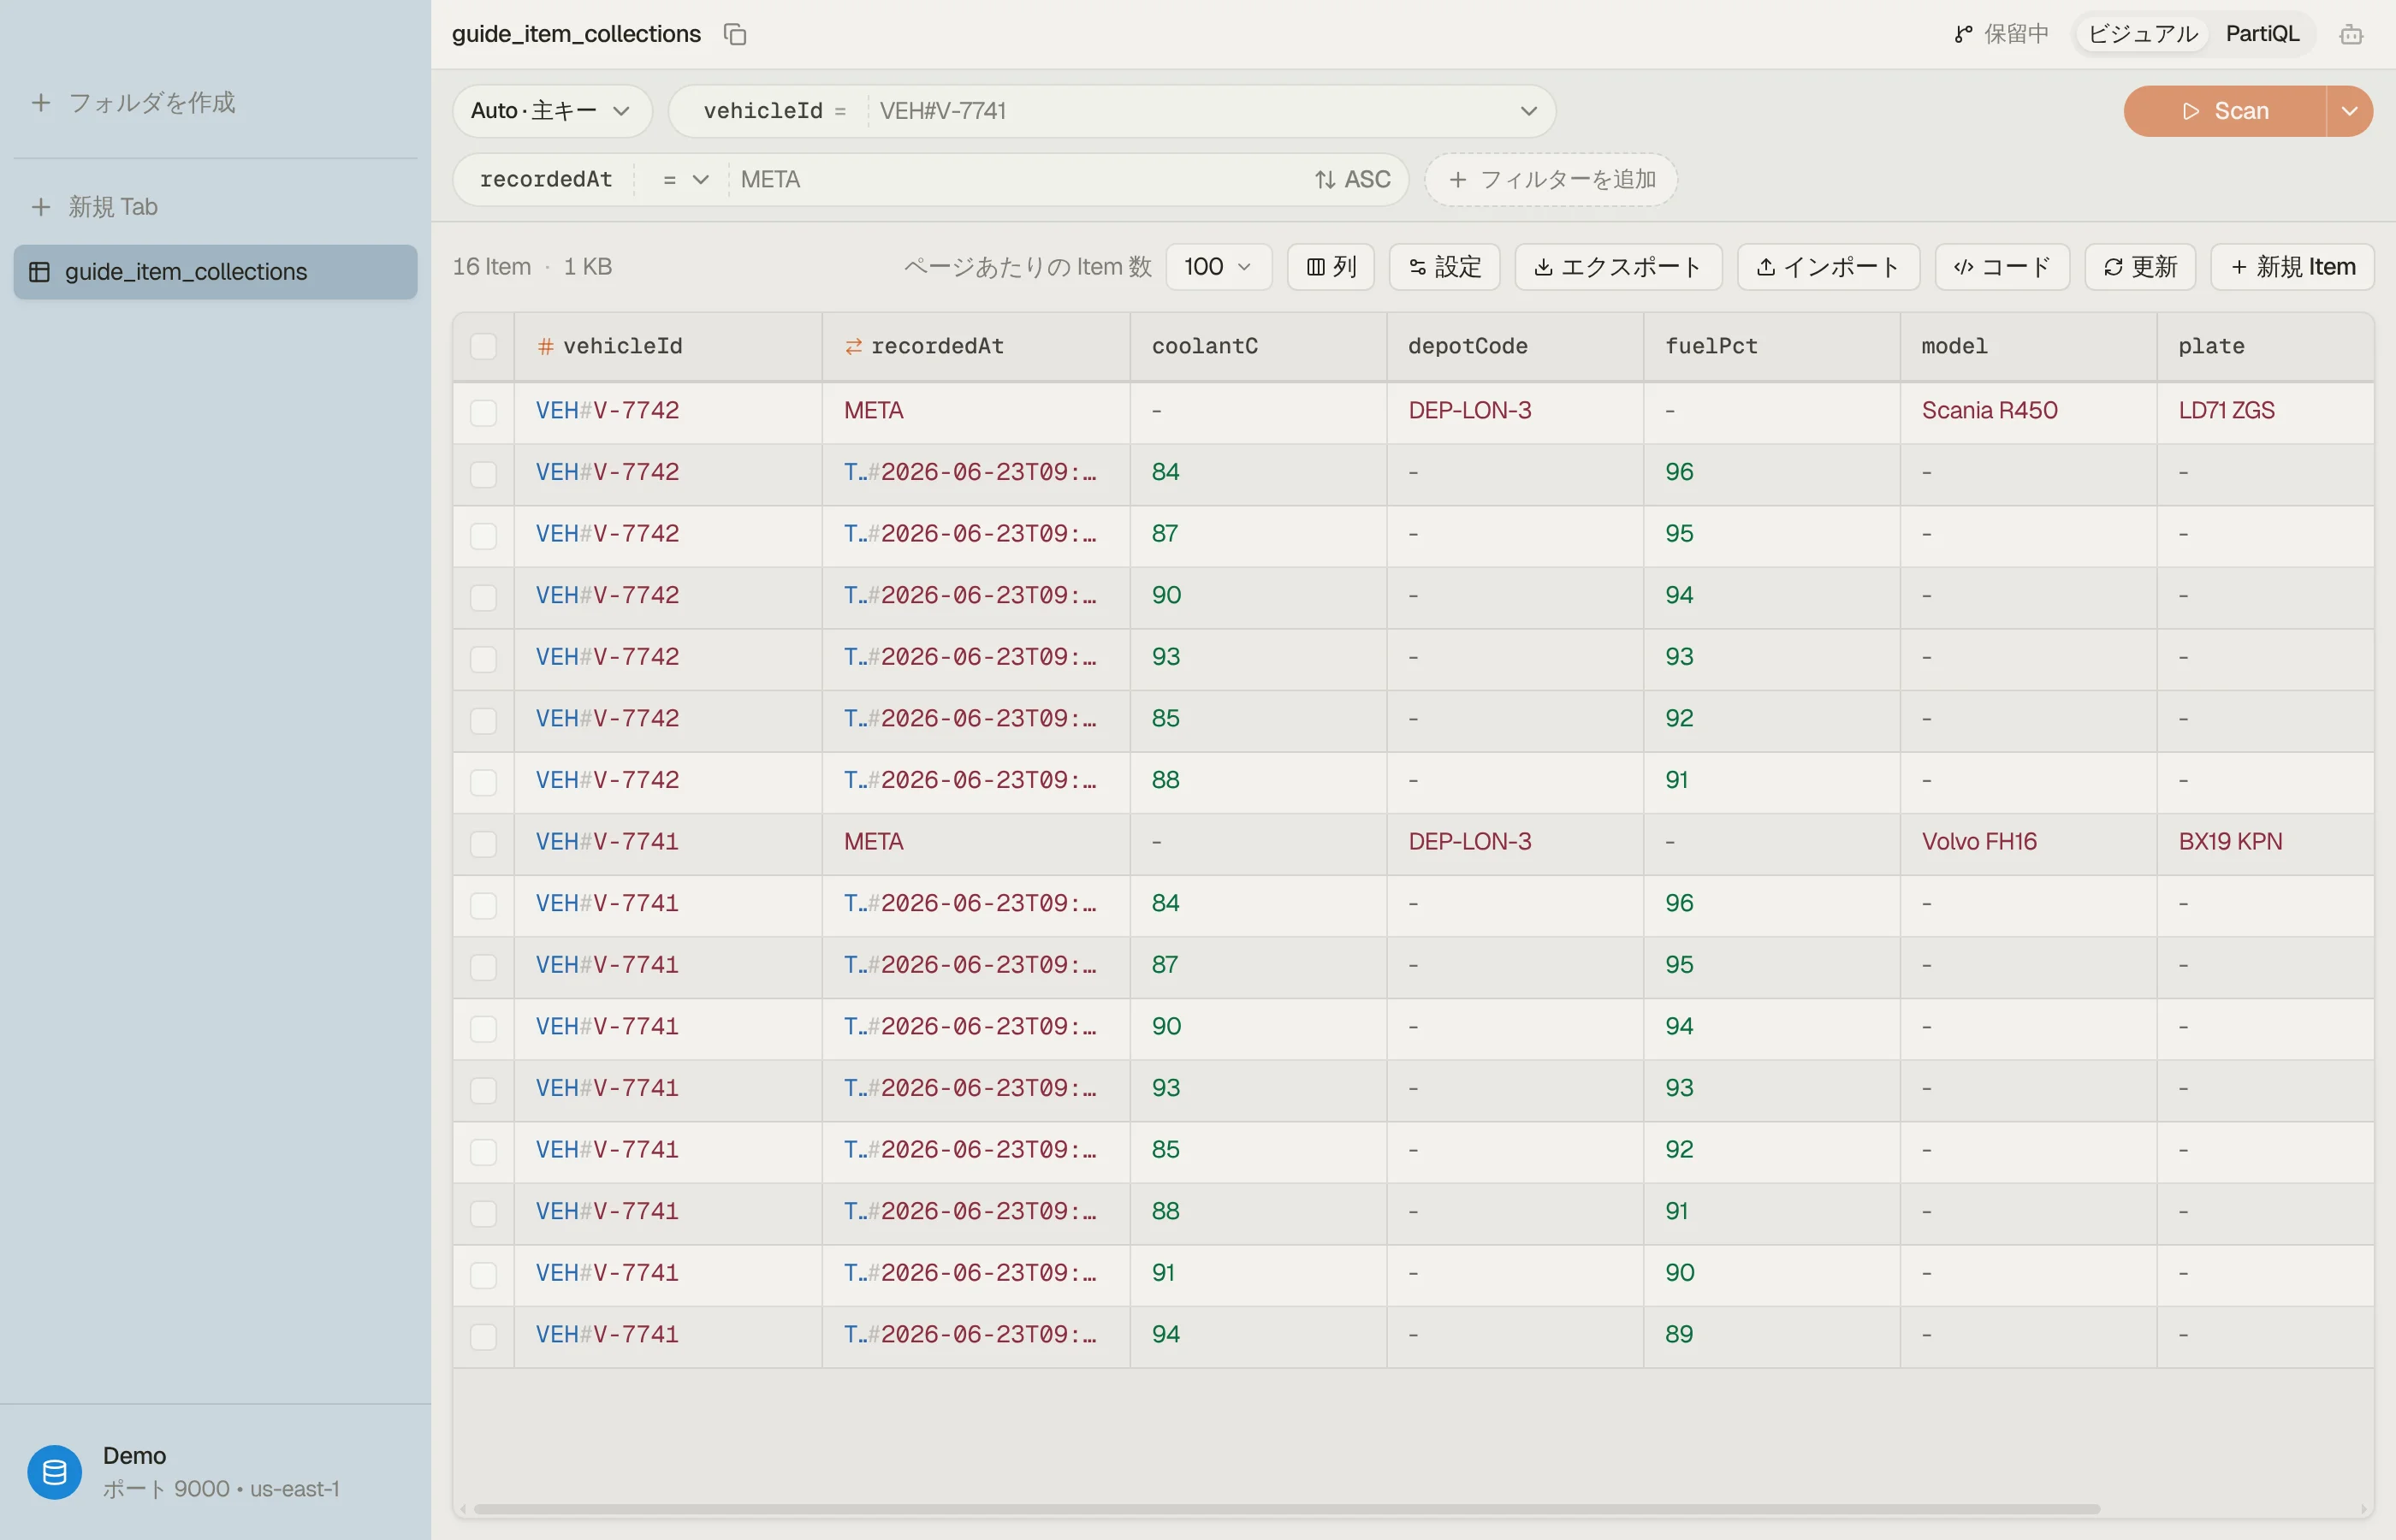
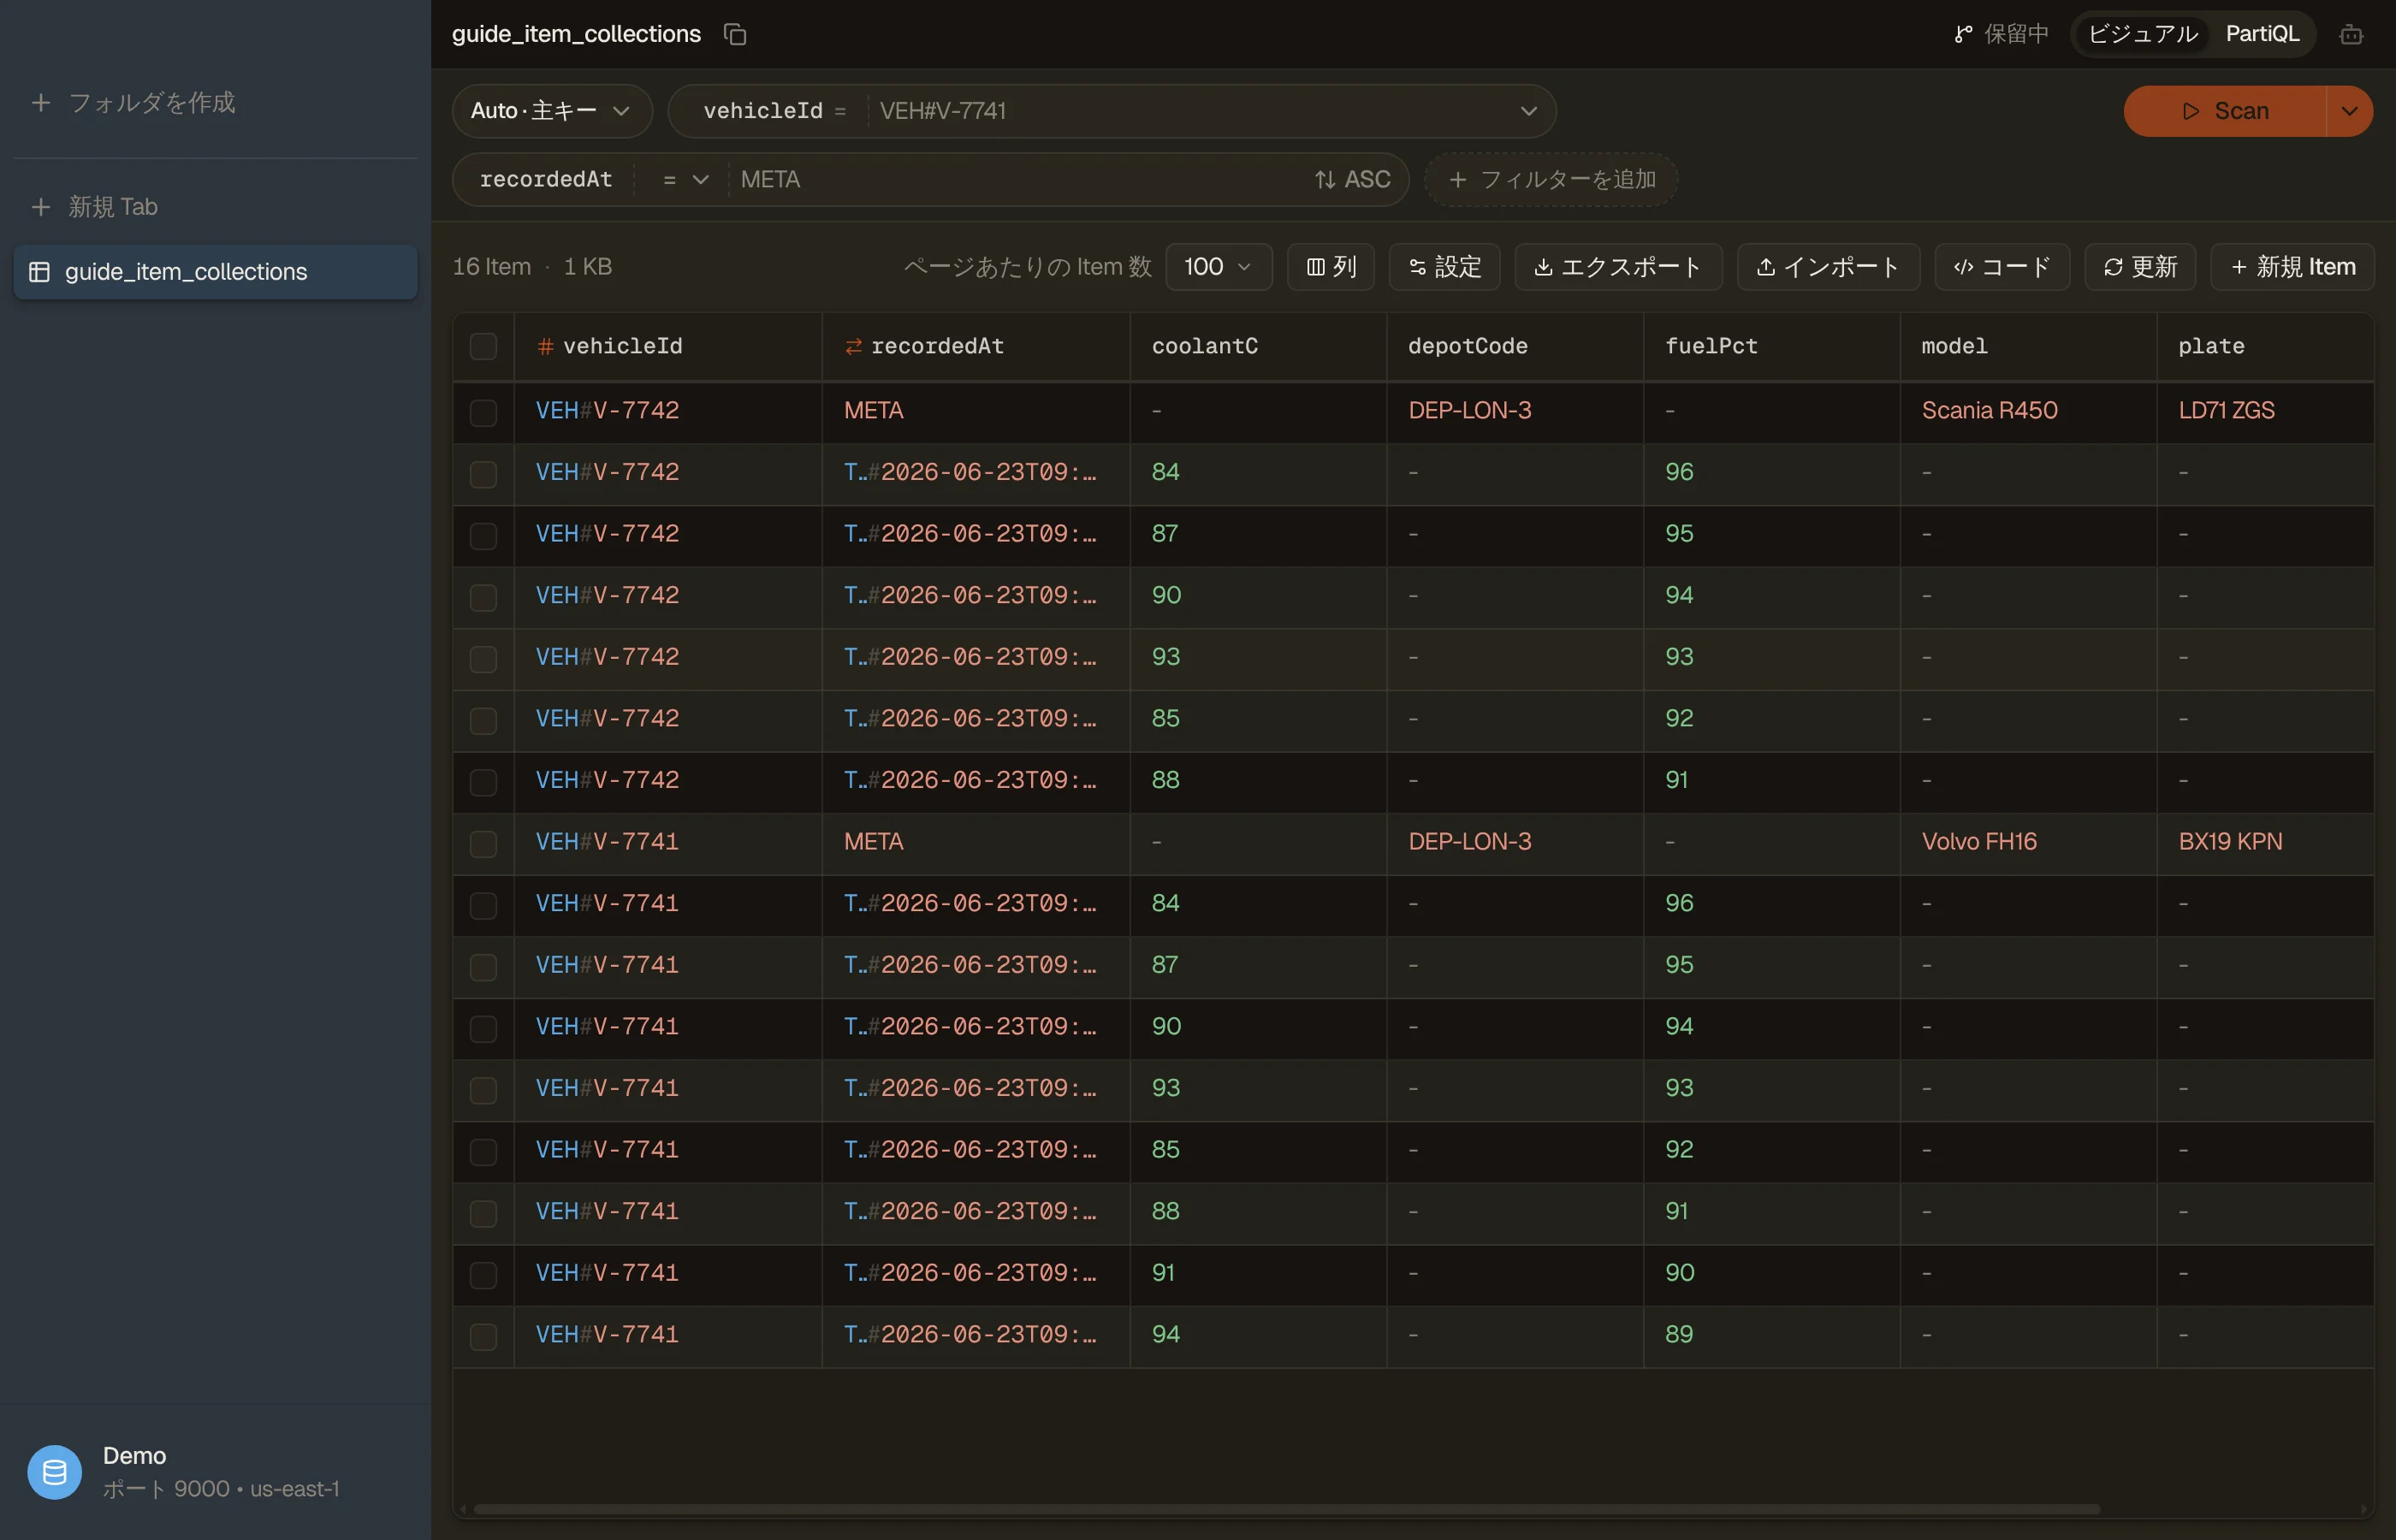
すでにテーブルがあるなら、DynoTable でデータに直接接続し、以下のシグナルを実際のアイテムで確かめられます。
DynamoDBが有利になるシグナル
DynamoDBは、これらの多くが当てはまるときに輝きます:
- アクセスパターンを事前に把握している。 アプリが行う正確なクエリ(「idでユーザーを取得」「ユーザーのサポートチケットを新しい順に一覧」)を列挙でき、それらが気まぐれに変わらない。DynamoDBはそれらのクエリを中心にモデリングされます。
- アクセスがキーベース。 任意の属性の組み合わせをスキャンするのではなく、既知のパーティションキーでアイテムを参照する。
- スケールと予測可能なレイテンシが重要。 DynamoDBは、テーブルが千件でも10億件でも一貫した1桁ミリ秒のパフォーマンスを発揮します。
- 運用オーバーヘッドをゼロにしたい。 インスタンスもフェイルオーバーもバキューミングもありません。フルマネージドで、オンデマンドモードならアイドル中のスループットに費用はかかりません。
- 書き込みスループットが高く急増する。 イベントログ、IoTテレメトリ、監査証跡、リーダーボード: 明確なキーを持つ追記中心のワークロード。
不利になるシグナル
代わりにリレーショナルデータベース(または検索/分析エンジン)を選ぶのは、次のときです:
- クエリがアドホック。 アナリストが任意のカラムでデータを切り分けたり、要件が毎週変わったりする。SQLの柔軟性が勝ちます。DynamoDBはパターンごとに新しいインデックスが必要になります。
- データセット全体にわたる結合と集計が必要。 レポーティング、ビジネスインテリジェンス、「地域別・月別の売上合計」はOLAPの仕事です。DynamoDBのデータでは、そうした作業のためにエクスポートしてください(DynamoDBデータでの分析を参照)。
- データセットが小さくトラフィックが少ない。 静かな管理アプリの数千行は、DynamoDBのスケールから恩恵を受けず、SQLの利便性を失います。
- アクセスパターンをまだ予測できない。 まだ形を模索している初期段階のプロダクト? 自由に再クエリできるリレーショナルなスキーマのほうが、パターンが固まるまでは寛容です。
ライブテーブルへの一度きりの質問は別の話です:
DynoTableのSQL Workbenchは、JOIN(INNERまたはLEFT、テーブルのキーまたはGSIのパーティションキーへの結合)、GROUP BY、集計をDynamoDBに対してクライアント側で実行します。よそに置くべきなのは常設のBIワークロードのほうです。
DynamoDBと他のデータベースの比較
「DynamoDBとXのどちらを使うべきか?」という問いは、たいてい1つの問いに帰着します: Xはアクセスパターンの決定を先送りさせてくれるのか、そしてその代償は何か? DynamoDBは、その先送りを許さない選択肢です。
リレーショナル: PostgreSQL、RDS、Aurora
リレーショナルデータベースではデータを手にした後でクエリを書けます。DynamoDBは、アイテムが1件も書き込まれる前に、クエリに合わせてテーブルの形を決めます。そしてこれが、チームが最もよく間違える選択です。
リレーショナルを選ぶのは、クエリの形がまだ動いているとき、データセット全体にわたる結合や集計が必要なとき、あるいはデータが十分に小さくスケールが問題になっていないときです。
DynamoDBを選ぶのは、パターンが固まっていてキーベースであり、そのコストが10億件でも千件でも同じであってほしいときです。
RDSとAuroraはマネージドなリレーショナルエンジンなので、SQLの柔軟性とそのスケーリングモデルを保ちます。Aurora Serverlessがあると、DynamoDBの「管理するサーバーがない」という論拠は弱まり、判断はアクセスパターンへと戻ってきます。
ドキュメント: MongoDBとDocumentDB
どちらもJSONのようなドキュメントを保存するので、DynamoDBと交換可能に見えることがあります。違いはクエリモデルです: MongoDBは任意のフィールドにインデックスを張り、アドホックなクエリを実行します。DynamoDBは、事前に宣言したキーとインデックスに応えます。
そのためMongoDBは変化し続けるクエリの形に、DynamoDBは既知のクエリを大量にさばく用途に向きます。DocumentDBはAWS上でMongoDBのAPIを話すので、同じ「柔軟性 対 予測可能性」の軸で比較してください。
ワイドカラム: Cassandra
Cassandraはアーキテクチャ上、DynamoDBに最も近い親戚です: パーティションキー、クラスタリングキー、そして「悪いパーティションキーはインデックスを足しても直せない」という同じルール。
両者の決め手になるのがデータモデルであることはまれです。誰が運用し、どう支払うかです: Cassandraは自分で運用するかマネージドを買う(AWSならAmazon Keyspaces)のに対し、DynamoDBには運用すべきクラスターがありません。
モデルがこれほど近いので、このサイトのモデリングの指針はほとんどそのまま通用します。シングルテーブル設計におけるパーティションキーとアクセスパターンの考え方は、Cassandraにもほぼ一行一行そのまま当てはまります。
インメモリ: Redis
Redisはメモリ優先で、サブミリ秒アクセスに最適化されています。永続化はオプションなので、 Amazon MemoryDBのような永続的なバリアントを使わない限り、再構築できるデータに向いています。 DynamoDBはデフォルトで永続的です。
本番での一般的な答えは両方です: DynamoDBを記録の正本とし、ホットキーの前にRedis(あるいは DynamoDB自身のリードスルーキャッシュであるDAX)を置きます。Redis単体を使うのは、レート制限のカウンターや短命なロックのような一時的なデータだけにしましょう。
検索: ElasticsearchとOpenSearch
DynamoDBにはキーワード(全文)検索がありません。Queryが一致させられるのはキーの等価条件と、限られたソートキー条件だけです。アナライザーも、あいまい検索も、ファセットも、キーワードの関連度もありません。
FilterExpression付きのScanは検索ではなくテーブルの総なめです: すべてのアイテムを読み、その大半を捨て、返ってきたアイテムではなく読んだアイテムの分だけ課金されます。
一方でベクトルインデックスはあります: SearchVectorsは、埋め込みがクエリベクトルに最も近いアイテムをスコア順に返します。これでセマンティック検索(「これに似たチケット」)をカバーできます。ベクトル検索を参照してください。
キーワードの関連度、アナライザー、ファセットには、やはり検索エンジンが必要です。標準的な構成は、DynamoDBを記録の正本とし、そこから流し込むOpenSearchのインデックスを置くものです。
マネージドなフィードは、DynamoDBの Amazon OpenSearch Serviceとのゼロ ETL 統合で、OpenSearch Ingestionのパイプラインです。S3へのエクスポートでスナップショットを読み込み、その後はテーブルのスループットを使わずにDynamoDB Streamsを追従します。
これにはポイントインタイムリカバリが有効で、Streamsが新旧両方のイメージに設定されている必要があります。ストリーム上に独自のLambdaを書くのは、パイプラインのプロセッサーでは表現できない変換が必要なときだけにしましょう。
どちらの方法でも2つ目のシステムを運用することになり、インデックスはテーブルに対して結果整合性になります。
ここではOpenSearchとElasticsearchは同じ判断です。 OpenSearchは、Elasticのライセンス変更を受けて、AWSが2021年にElasticsearch 7.10からフォークしたものです。どちらを選ぶかは、ライセンス、ホスティング、そしてどのマネージドサービスを使いたいかで決めましょう。
検索エンジンをプライマリのストアに据えるのは、検索がプロダクトそのものであるときだけにしましょう: ログ分析や、全文で検索されるカタログなど。それでも背後には永続的なストアを置きましょう: 検索インデックスは派生的なビューであり、再構築できる必要があります。
DynamoDBデータでの分析
DynamoDBが記録の正本で、レポーティングが必要なときは、ライブテーブルをスキャンしないでください。代わりにエクスポートします:
- テーブルのポイントインタイムリカバリを有効にする。エクスポートにはこれが必要です。
- S3へエクスポートする。コンソールから、または
aws dynamodb export-table-to-point-in-time --table-arn <arn> --s3-bucket <bucket>で行います。エクスポートはテーブルではなくバックアップを読むので、読み込みキャパシティを消費しません。フルまたは増分で、DynamoDB JSONまたはIon形式です。 - Athenaでエクスポートをクエリする: エクスポートされたファイルの上にテーブルを定義し (Glueクローラーで推論できます)、そこでSQLを実行します。
独自のパイプラインなしで最新に保たれるウェアハウスが欲しいなら、 Amazon Redshiftとのゼロ ETL 統合が増分エクスポートを使ってテーブルを15〜30分ごとにレプリケートします。こちらもポイントインタイムリカバリが有効である必要があります。
DynamoDBのエクスポートでは、S3へのエクスポートをステップごとに説明しています。
採用前にコストを見積もる
請求額はキャパシティモードによって決まります。オンデマンドのDynamoDBはリクエストごと (読み込み・書き込みリクエストユニット)とストレージに課金されるので、アイドル状態のテーブルにかかるのはストレージ代だけです。そのため、急増するワークロードやサーバーレスのワークロードには安価です。
プロビジョニングのDynamoDBは、設定した読み込み・書き込みキャパシティに対し、使っても使わなくても時間単位で課金されます。インスタンスとよく似ています。リザーブドキャパシティは、 1年または3年のコミットメント(3年の期間はすべてのリージョンで提供されているわけではありません)と引き換えにこの料金を下げますが、対象はStandardテーブルクラスのテーブルだけです。
どちらのモードでも、DynamoDBが高くつくのは持続的な重いスキャンです。スキャンは読んだすべてのアイテムの分を支払うからです。
注意すべき乗数はインデックスです。リレーショナルエンジンならインデックスを1つ増やすコストはストレージと多少の書き込みレイテンシですが、DynamoDBでは各グローバルセカンダリインデックスがテーブルと一緒に書き込まれます。
ALL投影で1 KBまでのアイテムなら、GSIが1つで書き込みの請求額はおよそ2倍、2つで3倍になります。インデックスキーを変更する更新はインデックスへの書き込み2回分のコストがかかり、狭い投影やスパースインデックスならコストは下がります。
インデックスの概要では、3つの書き込み量で計算しています。採用する前に料金計算ツールで実際の読み書きの構成をモデル化しましょう。技術的に適合するワークロードは、コスト面でも採算が合うべきです。
適合すると判断したら
作業はモデリングへと移ります。DynamoDBは、クエリを中心にテーブルを設計することに報います: DynamoDBでのデータモデリング方法とシングルテーブル設計、そしてシングルテーブルを選ぶべきでないときを参照してください。


落とし穴と次のステップ
- DynamoDBをリレーショナルデータベースのようにモデリングしてはいけない。 読み取り時に正規化されたテーブルを結合することは、DynamoDBが最も厳しく罰するパターンです。
- ライブテーブルで分析を実行してはいけない。 S3へエクスポートしてAthenaでクエリするか、上で説明したとおりゼロ ETLでRedshiftへレプリケートしましょう。
- アクセスパターンに自信がない? 待ちましょう。 クエリを把握する前にDynamoDBを採用することは、それを把握していることを要求する唯一のデータベースを選ぶことです。
- 関連: QueryとScanが、「キーベースのアクセス」が何をもたらすかを示しています。
アプリを賭ける前にDynamoDBテーブルを探索したいですか?
DynoTableをダウンロードして、データに直接接続してください。その
SQL Workbenchは、キーとインデックスの上でJOINと集計を実行します:
DynamoDBのアクセスパターンのルールの範囲内でのSQLです。