DynamoDB における 1 対多のリレーションシップ
SaaS のコントロールプレーンは、ほぼ必ず包含の階層構造を持ちます。1 つのワークスペースが多くのプロジェクトを所有する、といった具合です。SQL であれば projects テーブルに workspace_id の外部キーを置いて JOIN するでしょう。
DynamoDB には結合も外部キーもありません。正しく行えば、「あるワークスペースとその中のすべてのプロジェクトを読み込む」処理は、1 回の読み取りに続けてスキャンを行うのではなく、単一の Query になります。
DynamoDB で 1 対多のリレーションシップはどうモデリングするのか?
親とそのすべての子に同じパーティションキーを与えて 1 つのアイテムコレクションを共有させ、次にソートキーで区別します。リレーションシップはキースキーマの中に置かれ、親とすべての子を読み込む処理は 1 回の Query になります。
- エンティティではなく、読み取りをモデリングする。 このリレーションシップは「ワークスペースのプロジェクトを一覧表示する」ために存在するので、そのクエリを中心にキーを形づくりましょう。
- 親を子のパーティションキーにエンコードする。 ワークスペースとそのすべてのプロジェクトに同じパーティションキー値を与えます。
- すると一覧の読み取りは 1 回の
Queryになる。 親とその子がまとめて返ってきます。1 ページあたり最大 1 MB で、次のページはLastEvaluatedKeyで取得します。 - ホットパーティションに注意する。 非常に忙しいテナントは、そのトラフィックを 1 つのキーに集中させます。1 つのキーが吸収できる量を超えたら、キーをシャーディングしてすべてのシャードをクエリします。
まずはアクセスパターン
DynamoDB のモデリングはエンティティ優先ではなく、アクセスパターン優先です。これはシングルテーブル設計 の背後にあるのと同じ規律です。どんなキーを選ぶ前にも、アプリが実際に発行する読み取りを書き出しましょう。
- あるワークスペースの設定を取得する。
- あるワークスペース内のすべてのプロジェクトを、新しい順に一覧表示する。
- ワークスペースがわかっているとき、特定のプロジェクトを id で取得する。
「1 つのワークスペース、多数のプロジェクト」というリレーションシップが重要なのは、読み取り #2 があるからだけです。ワークスペースのプロジェクトをまとめて一覧表示することがないのなら、プロジェクトを独立して保存するでしょう。
なぜ素の外部キーでは足りないのか
すべての GetItem と Query はパーティションキーをターゲットにします。AWS の
Core Components
のページによれば、パーティションキー値は、データがどこに存在するかを決める内部ハッシュ関数への入力です。
プロジェクトアイテム上の素の workspace_id 属性 は、インデックスを作るまでクエリできません。「あるワークスペースのプロジェクト」を 1 回の Query にする方法は 2 つあります。
- パーティションキーを共有する(このガイド): プロジェクトのパーティションキー そのものがワークスペースです。1 回の
Queryでワークスペースのレコードとそのプロジェクトがまとめて返ります。 workspace_idへの GSI: プロジェクトは自分のパーティションキーを保ち、インデックスがそれらをワークスペースごとにまとめます。プロジェクトが主に自分の id で読まれるときに選びます。インデックスは結果整合性で、その書き込みも課金されます。
実例: ワークスペースとプロジェクト
汎用的で、オーバーロードしたキースキーマを使います。パーティションキーを EntityRef、ソートキーを
Detail と名付けましょう。ワークスペースの識別子は、ワークスペースアイテムとその配下のすべてのプロジェクトの両方について EntityRef に入ります。
| EntityRef | Detail | attributes |
|---|---|---|
| WS#acme | META | displayName, region, seatLimit |
| WS#acme | PROJ#2026-0007 | title, status, createdBy |
| WS#acme | PROJ#2026-0042 | title, status, createdBy |
| WS#acme | PROJ#2026-0118 | title, status, createdBy |
| WS#globex | META | displayName, region, seatLimit |
| WS#globex | PROJ#2026-0009 | title, status, createdBy |
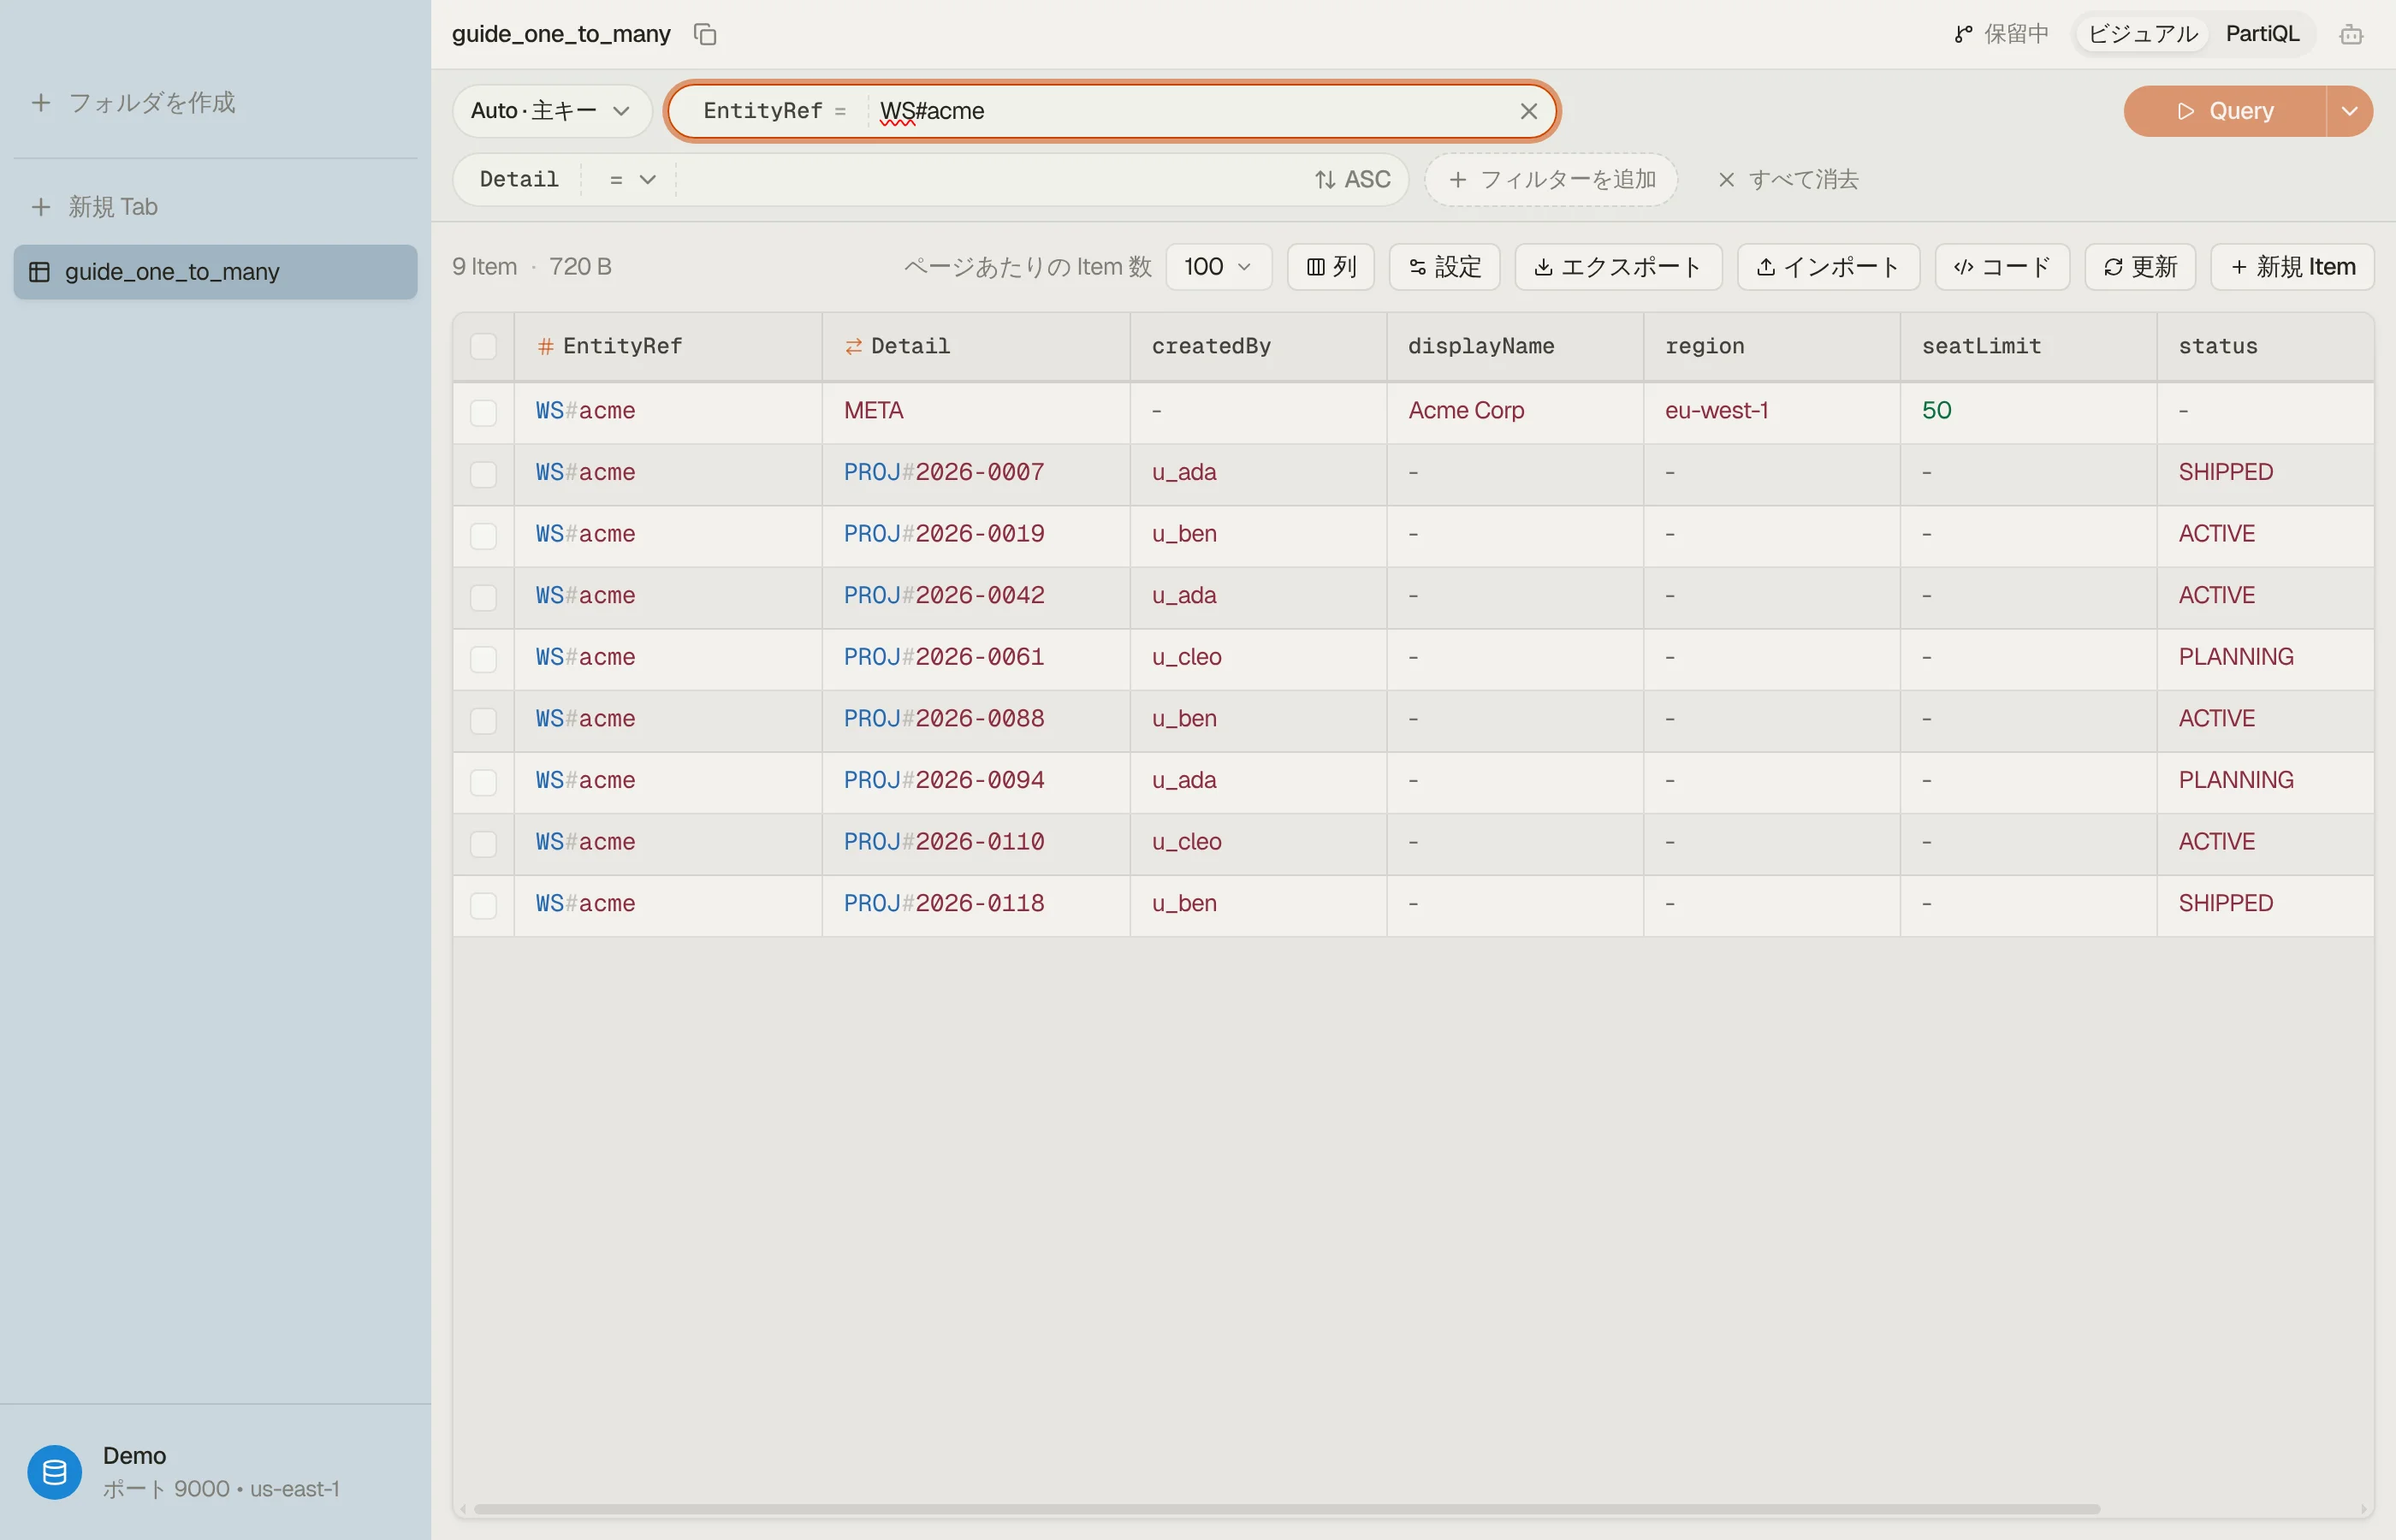
ワークスペースとそのすべてのプロジェクトは EntityRef = "WS#acme" を共有するため、Detail の順で格納される単一のアイテムコレクションを形成します。
META はワークスペースのレコードです。各プロジェクトは PROJ# プレフィックスに、ゼロ埋めされた時間順の id を付けて持つため、プロジェクトは作成順にソートされます。
DynamoDB にはオートインクリメントがありません。1 つのグローバルなアイテム(たとえば
COUNTER#project)上のアトミックカウンターから次の番号を取るか、
ULID のような時間でソートできる id を使います。
どちらの方法でも id はワークスペースをまたいで一意になり、後述する id だけでの検索はそれを前提にしています。
ゼロ埋めの桁数は、1 つのワークスペースではなくグローバルなカウンターに合わせて決めます。8 桁以上を使い、キーを書き込むコードで桁数をチェックしてください。
例では読みやすさのために 4 桁を使っていますが、これだとカウンターは 9,999 プロジェクトが上限になります。
10,000 番目の PROJ#2026-10000 は PROJ#2026-9999 より前にソートされ、新しい順が崩れます。
これで、3 つのアクセスパターンがそれぞれ 1 回の呼び出しに収まります。
- ワークスペースの設定:
GetItem(EntityRef="WS#acme", Detail="META")。 - プロジェクトを新しい順に一覧表示:
Detail begins_with "PROJ#"を指定したQuery(EntityRef="WS#acme")を、降順(ScanIndexForward = false)で実行。 - 1 つのプロジェクト:
GetItem(EntityRef="WS#acme", Detail="PROJ#2026-0042")。
プロジェクトの一覧は、2 回目の往復なしに1 つの Query から、1 回につき最大 1 MB のページで返ってきます。ソートキーのプレフィックスに対する begins_with は、複合ソートキーの手法の最も単純な形です。
DynamoDB Expression Builder は、その begins_with の読み取りに対する
KeyConditionExpression、#name/:value のプレースホルダーマップ、そしてすぐ実行できる
SDK スニペットを生成します。
KeyConditionExpression     "#er = :er AND begins_with(#d, :p)"
ExpressionAttributeNames   { "#er": "EntityRef", "#d": "Detail" }
ExpressionAttributeValues  { ":er": "WS#acme", ":p": "PROJ#" }
DynoTable でアイテムコレクションを確認する
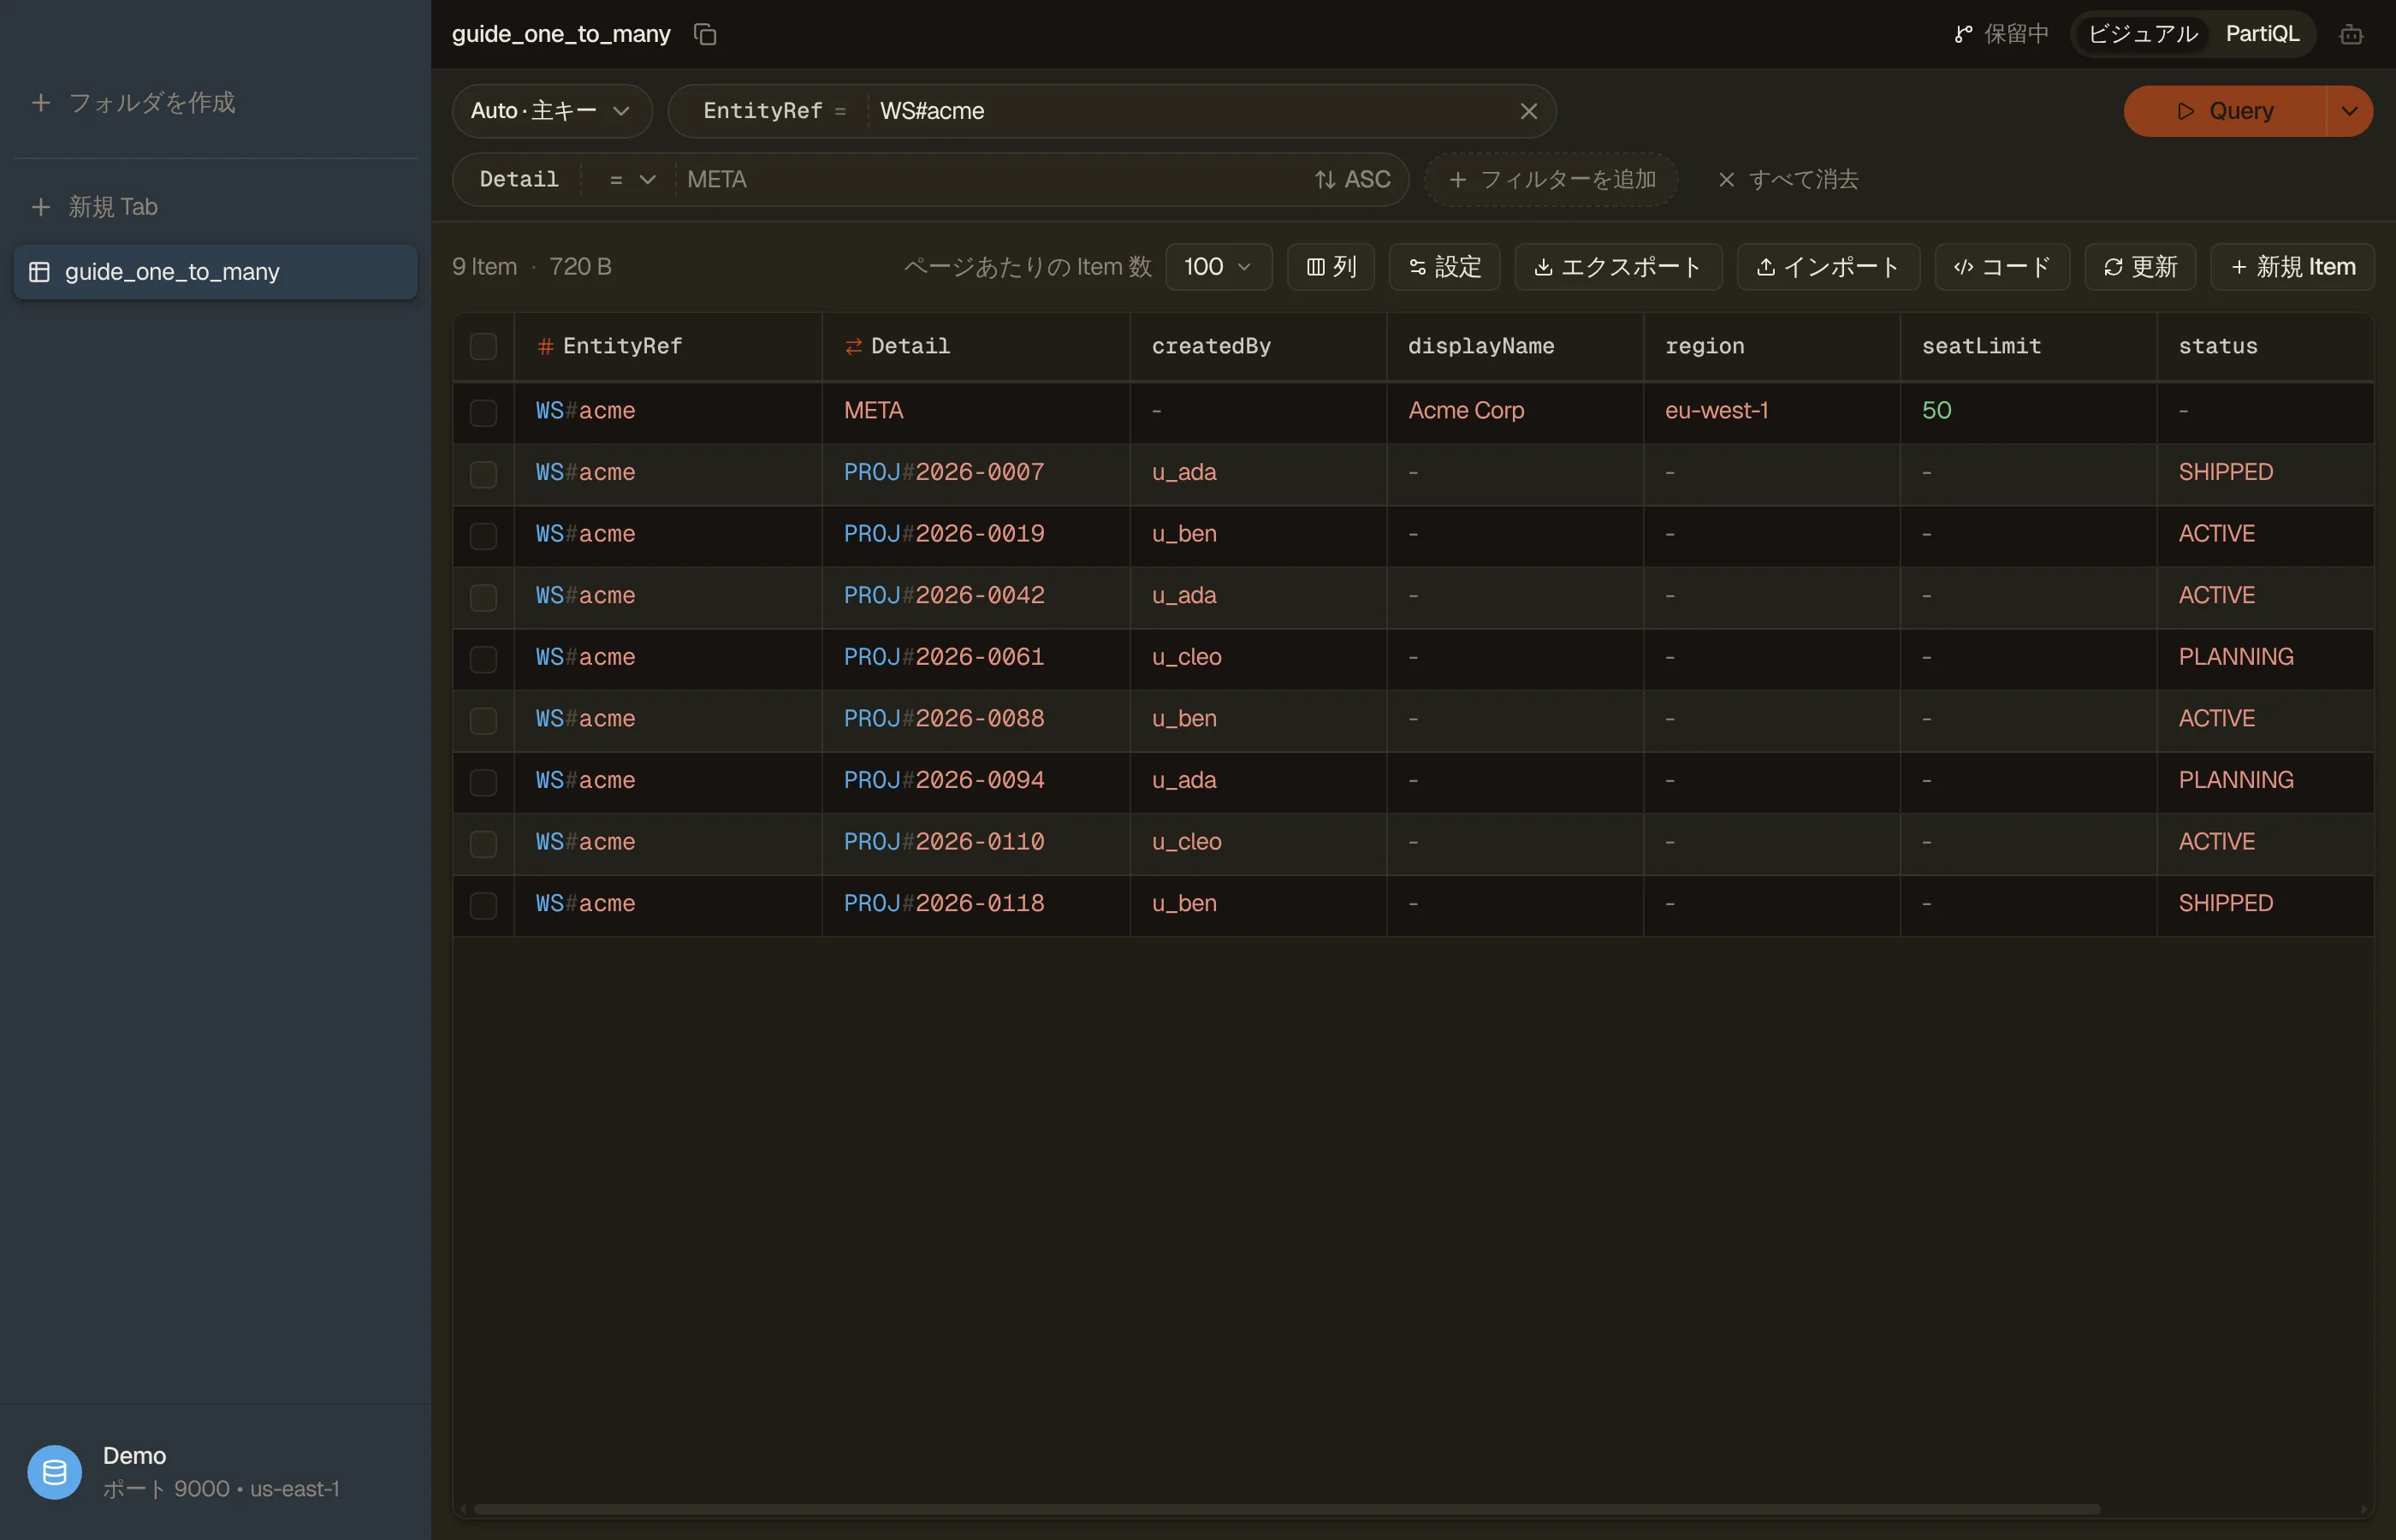
EntityRef = WS#acme に対して Query を実行すると、行は 1 つの連続したブロックとして返ってきます。最初に META、続いて各プロジェクトがソートキー順に並びます。1 対多のリレーションシップを、別々のテーブルにまたがって推測するのではなく、1 つのコレクションとして目にできます。


落とし穴と代替の形
ホットパーティション: 非常に忙しい 1 つのテナントは、そのトラフィックを 1 つのキーに集中させます。サイズだけが引き金になるわけではありません。
LSI がなければ、DynamoDB は忙しいコレクションをソートキーで分割できます。ただし、新しい時間順の id のように、トラフィックが着実に増加するソートキーを追う場合は別です(分割の仕組み)。
それでも持続的な書き込みがスロットルされるなら、キーをシャーディングし(WS#acme#0 … #9)、シャードごとに 1 回の Query で読み取って、コード内で新しい順にマージします。
サフィックスはプロジェクト id から導出し(ハッシュの mod 10)、1 つのプロジェクトの取得が
GetItem のままになるようにし、META はシャーディングしないキーに置きます。ホットパーティションで両方を扱います。
アイテムコレクションのサイズ: ローカルセカンダリインデックスがある場合、1 つのパーティションキー値のアイテムコレクションは 10 GB に制限されます。LSI がなければそのような制限はありません。ワークスペースがそれを超えて成長しうるなら、LSI ではなく GSI を使います。
LSI を残すなら、書き込みに ReturnItemCollectionMetrics = SIZE を設定し、10 GB よりかなり手前(AWS は 8 GB を推奨)でアラートを出します。上限はアイテムコレクションで扱います。
Scan ではなく必ず Query を選ぶ: この設計全体は、1 つのパーティションを Query できるようにするために存在します。「ワークスペースのプロジェクトを見つける」ためのフィルタ付き Scan はテーブル全体を読みます。これは Query vs Scan で扱う罠です。
ワークスペースのないプロジェクト id: 2026-0042 だけを持つディープリンクや Webhook には、読み取りに使うキーがありません。各プロジェクトに projectId 属性を保存して GSI でインデックスします。(前述の)グローバルに一意な id であれば、検索は 1 つのプロジェクトを返します。
代わりにワークスペースごとにプロジェクトを採番するなら、2026-0042 は多くのワークスペースに存在するので、公開 id にワークスペースを埋め込み(acme/2026-0042)、GSI は省きます。
ワークスペースをまたいだ一覧表示: 「すべての ACTIVE なプロジェクト」は、パーティションキーがワークスペース単位にスコープされたベーステーブルからは取得できません。
スパースインデックスを使います。アクティブなプロジェクトにだけ
GSI1PK = ACTIVE と GSI1SK = プロジェクト id を書き込み、プロジェクトがクローズしたら両方を削除します。
するとインデックスはアクティブなプロジェクトだけを保持します。その 1 つの GSI1PK 値に多くの書き込みが集中するなら、前述のようにシャードのサフィックスを付けます。
次のステップ
DynamoDB Expression Builder でキー条件を構築して検証しましょう。アクセスパターンそのものから始めたいなら、無料のシングルテーブル設計ツールが、例のアイテム付きの PK/SK/GSI プランを下書きしてくれます。
その後、DynoTable をダウンロードしてこのテーブルを作成し、ワークスペース→プロジェクトのアイテムコレクションをクエリして、親とその子が 1 回の Query から返ってくるのを確かめてください。