DynamoDB の多対多リレーションシップ
1 人の学生は多くの講座に登録し、1 つの講座は多くの学生を抱えます。SQL では結合テーブルと 3 テーブルの JOIN に手を伸ばします。
DynamoDB には結合がないので、リレーションシップは キー の中に存在しなければなりません。各登録を、両側が直接 Query できる形で保存します。
DynamoDB で多対多リレーションシップをどうモデル化しますか?
各リンクを、片側でキー付けした独自のエッジ項目として保存し、キーを入れ替えた反転 GSI を追加します。これが隣接リストパターンで、ここではエッジにデータを持つ 2 つのエンティティ型に適用しています。
仕組みとコストは隣接リストのガイドで詳しく扱っています。
- 各登録をそれ自身のエッジ項目として保存する。 どちらかの側のリスト属性にはしません。
- エッジを学生でキー付けする(
PK = STU#…、SK = ENROLL#CRS#…)ので、1 つのQueryが学生の講座リスト全体を返します。 - 役割を入れ替える反転 GSI を追加する(
GSI1PK = CRS#…)ので、同じエッジが「この講座には誰がいるか?」にも答えます。 - 講座のレコードもそのインデックスに入れるので、講座のページも 1 回の
Queryで済みます。
まずアクセスパターンを枠組む
DynamoDB のモデリングはアクセスパターンファーストです。単一の属性名を選ぶ前に読み取りを決めます。多対多リレーションシップはほぼ常に 2 つ の対称な読み取りに、エンティティのルックアップを加えたものを持ちます。
- 学生のプロフィールを取得し、その学生が登録しているすべての講座をリストする。
- 講座のメタデータを取得し、その講座に登録しているすべての学生をリストする。
- 単一の登録エッジを引く。成績を更新するか講座を取り消すために。
2 つのリスト読み取りは、同じエッジの集合を挟んで正反対の方向を指します。素朴な設計は一方を安価に提供し、もう一方には Scan を強います。Query vs Scan で扱った落とし穴です。仕事は 両方 の方向を単一の Query にすることです。
エッジ項目とインデックスを使う理由
DynamoDB が与えるプリミティブは、1 つのパーティションに対する Query です。1 つのパーティションキーの下で連続したソートキー値の範囲を読みます。それがエンジンの提供する唯一の「結合」です。
そこで各登録を学生でキー付けして一度だけ書き、講座でキー付けした 2 つ目のコピーはセカンダリインデックスに持たせます。そのコピーを書くのはあなたではありません。DynamoDB が維持し、インデックスへの書き込みを課金します。
AWS はこれを多対多のモデリングガイドで文書化しています。
これはシングルテーブル設計のオーバーロードされたキーの考え方を、親子階層ではなくリレーションシップに適用したものです。同じエッジの 2 つの積み重なったビューです。
例を作る: 学生 ↔ 講座
汎用のキー PK と SK を持つ 1 つのテーブルを使い、エンティティ型を値の中にエンコードします。各エンティティ自身のレコードは SK = META に置き、登録エッジは学生のレコードの隣に置きます。
| PK | SK | attributes |
|---|---|---|
| STU#a91 | ENROLL#CRS#cs101 | enrolledOn, grade |
| STU#a91 | ENROLL#CRS#math204 | enrolledOn, grade |
| STU#a91 | META | name, year, major |
| STU#b30 | ENROLL#CRS#math204 | enrolledOn, grade |
| STU#b30 | META | name, year, major |
| CRS#cs101 | META | title, credits, term |
| CRS#math204 | META | title, credits, term |
単一の Query PK = "STU#a91" は、学生の登録 と プロフィールを、1 MB ずつのページで一緒に返します。SK begins_with "ENROLL#" で絞れば、講座エッジだけを取得できます。それで「学生の講座をリストする」が解決します。
「講座の学生をリストする」は逆方向を指します。ベーステーブルはそれに答えられません。講座 id はソートキーにしか現れず、Query はパーティションキーを指定しなければならないからです。
汎用の GSI1PK/GSI1SK の対でキー付けした反転 グローバルセカンダリインデックス GSI1 を追加します。各エッジは GSI1PK に講座を、GSI1SK に学生を持ちます。講座の META 項目には、GSI1PK = 自身の id、GSI1SK = META を与えます。
| PK | SK | GSI1PK | GSI1SK |
|---|---|---|---|
| CRS#math204 | META | CRS#math204 | META |
| STU#a91 | ENROLL#CRS#math204 | CRS#math204 | STU#a91 |
| STU#b30 | ENROLL#CRS#math204 | CRS#math204 | STU#b30 |
| CRS#cs101 | META | CRS#cs101 | META |
| STU#a91 | ENROLL#CRS#cs101 | CRS#cs101 | STU#a91 |
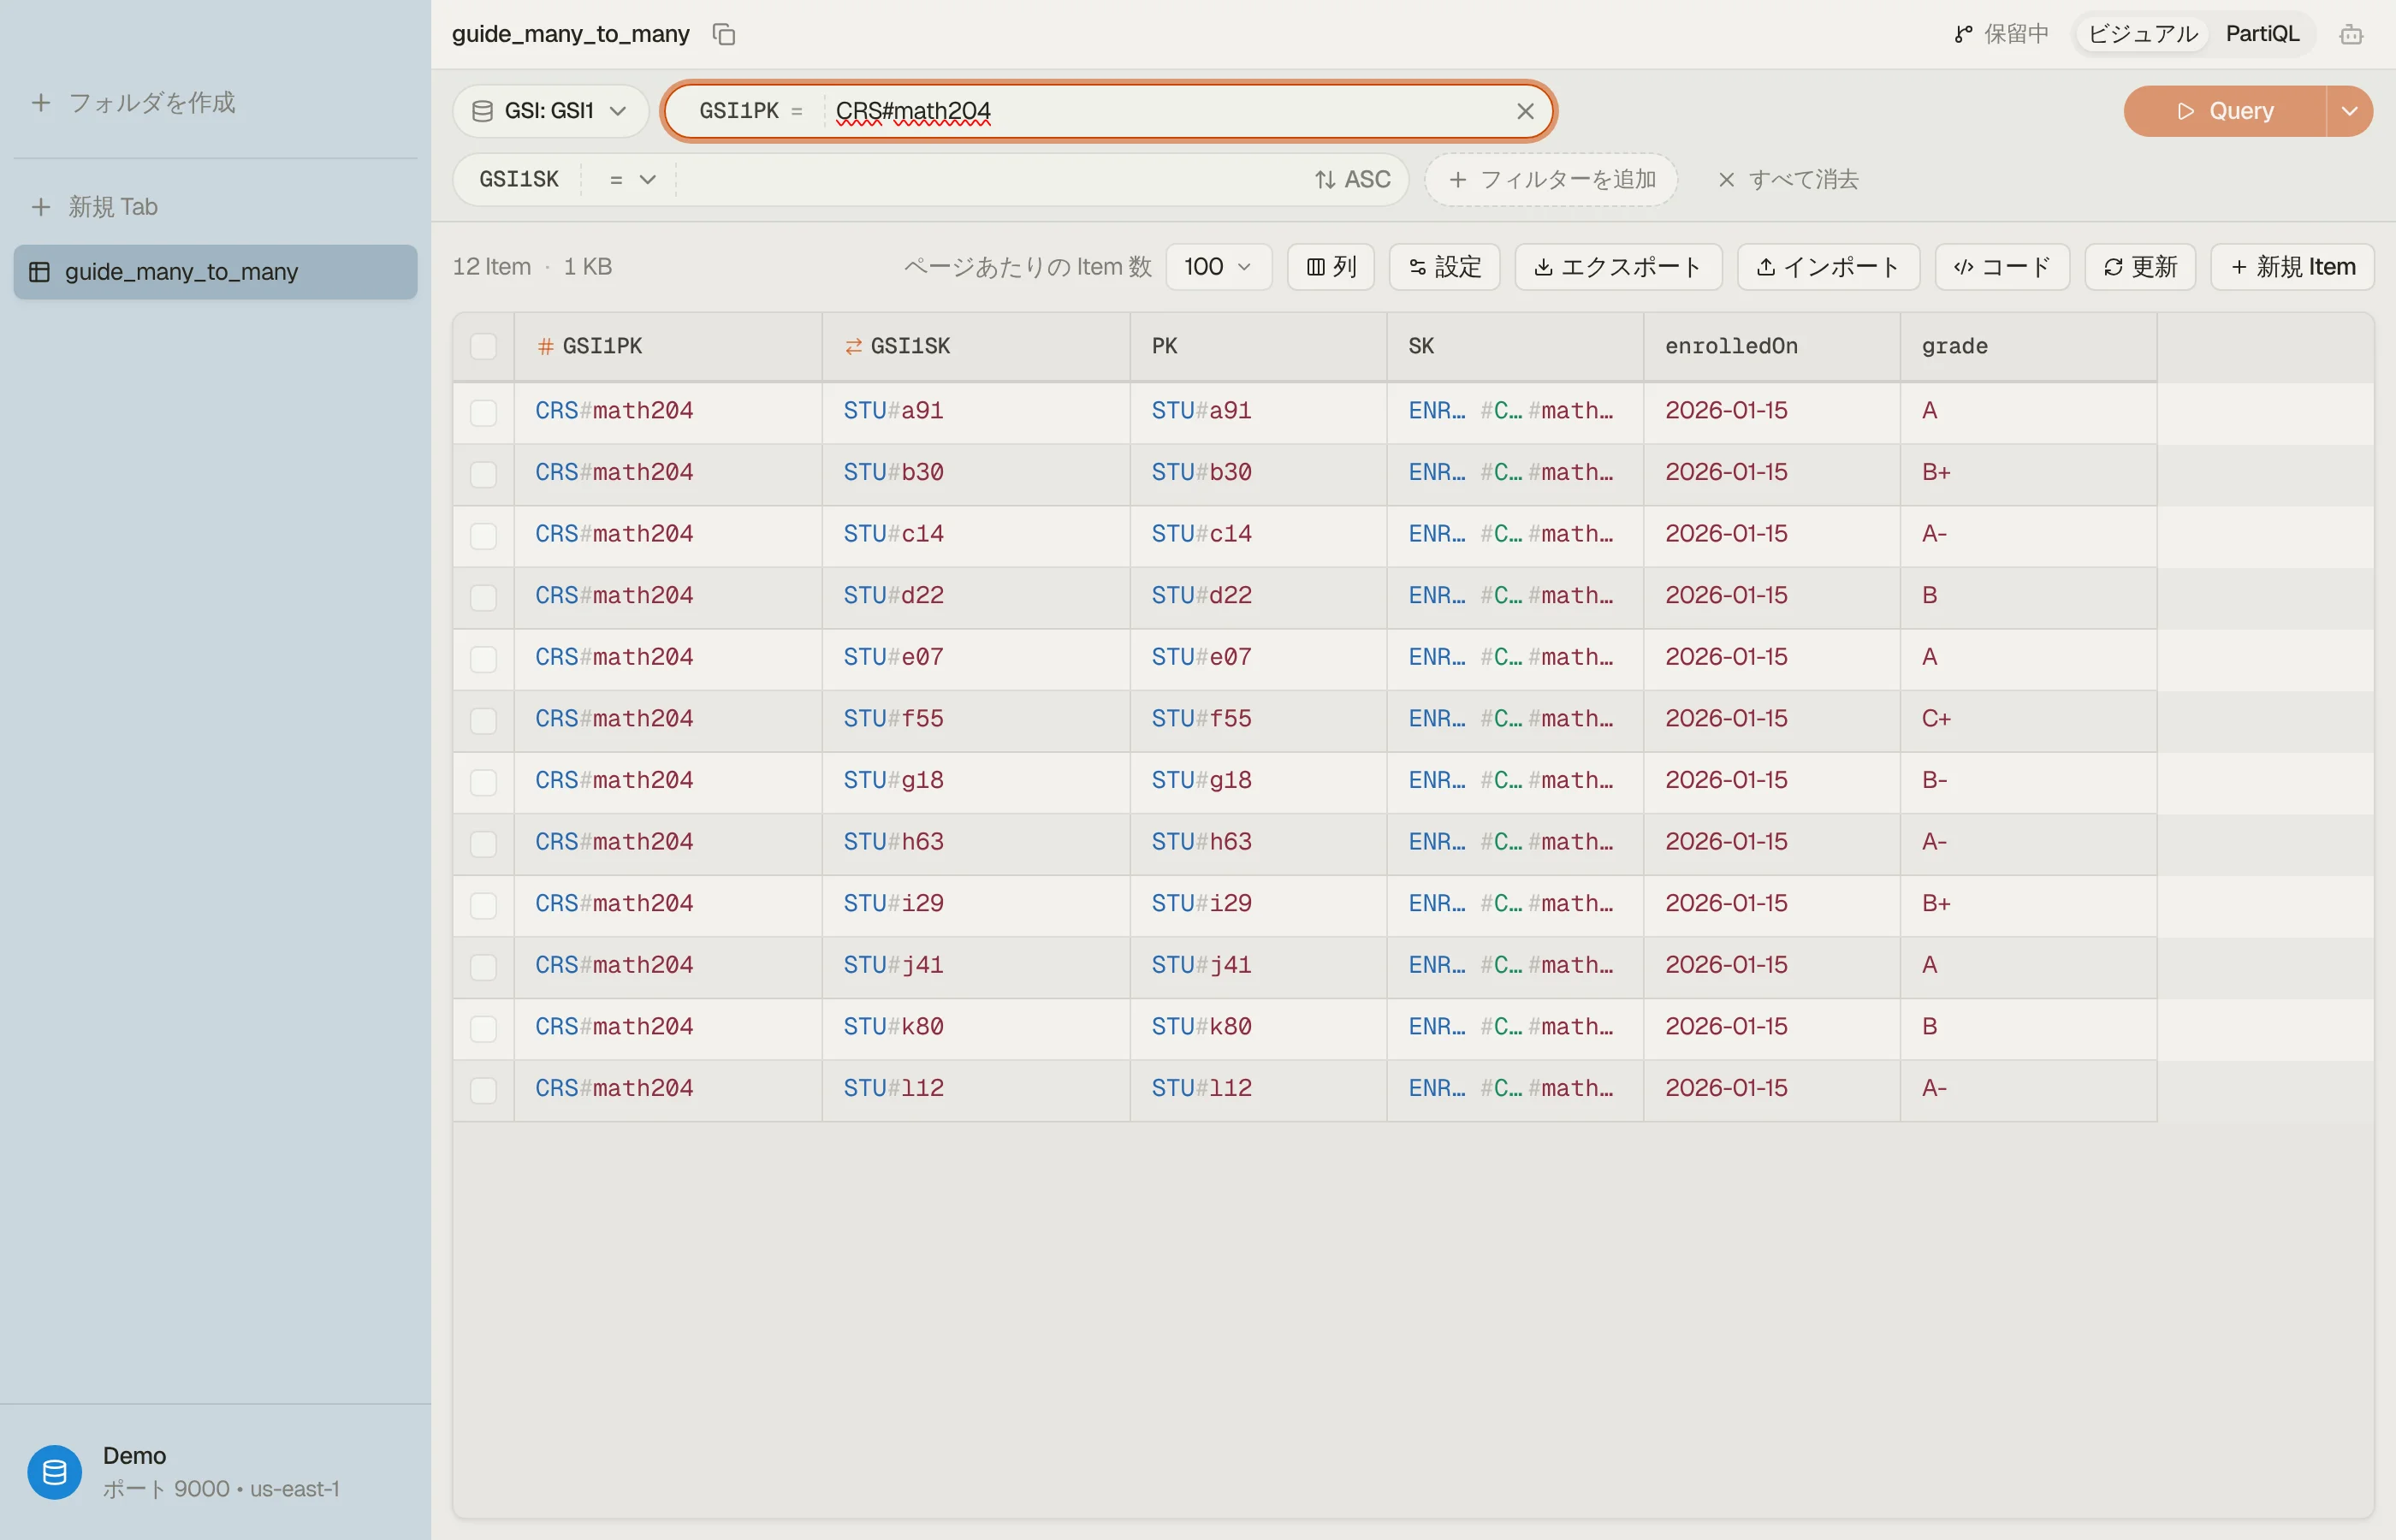
いまや Query GSI1 WHERE GSI1PK = "CRS#math204" は、講座のレコードに続けて登録しているすべての学生を返します。META は STU# より前にソートされるからです。名簿だけが欲しいときは begins_with(GSI1SK, "STU#") を加えます。
これは LSI ではなく GSI でなければなりません。LSI はベーステーブルのパーティションキーを共有しますが、講座のパーティションはまったく別のキーです。GSI vs LSI を参照してください。
講座の方向は結果整合性です。新しい登録は通常 1 秒足らずでインデックスに届きますが、GSI は ConsistentRead を拒否します。
登録直後に自分の書き込みを読みたいときは、ベースのエッジを GetItem で読む(PK = STU#a91、SK = ENROLL#CRS#math204、ConsistentRead: true)か、書いたばかりの登録をクライアント側で名簿にマージします。
DynoTable で書いて読む
登録を書くとは、4 つのキー属性に加えてエッジ自身のデータをセットすることです。
エッジの Put に attribute_not_exists(PK) 条件を付けると、学生が同じ講座に二重に登録するのを止められます。まったく同じ PK と SK を持つ項目がすでに存在すると失敗するからです。
その条件は、ExpressionAttributeNames とプレースホルダー値を手で書く代わりに、DynamoDB 式ビルダーで視覚的に組み立てられます。
DynoTable ではインデックスピッカーで GSI1 を選び、GSI1PK = "CRS#math204" をセットすると、講座とその名簿がテーブルとして返ります。ソートキーピルを降順に切り替えれば逆順になります。行はインデックスが返したままの形でアイテムエディタに開くため、INCLUDE 射影では射影された属性しか見えません。登録を編集するには、その行の PK と SK でベーステーブルを照会し、ベースのアイテムを開きます。


落とし穴と次のステップ
- 片側をリスト属性として保存しない。 学生項目上の
courseIds配列では、講座が名簿をリストする手段がなく、400 KB の項目上限にも達します。読み取り・変更・書き込みで更新すれば、2 つの登録が互いを潰すこともあります。 - エッジのデータはエッジに保つ。 登録の
gradeとenrolledOnはエッジ項目に属するので、(学生, 講座) の対ごとに更新する項目はちょうど 1 つです。学生の名前のようなフィールドをエッジにコピーするのは、名簿にそれを表示しなければならないときだけにします。 - 講座のページが必要とするものだけを射影する。
title、enrolledOn、コピーした名前を指定するINCLUDE射影ならインデックスを小さく保てます。KEYS_ONLYは id だけを返すので、レコードはMETAキーに対するBatchGetItemで取得します。
さらに深く掘るには、オーバーロードされたキーについてシングルテーブル設計を、書き込みコスト、インデックスの遅延、ホットなターゲットについて隣接リストのガイドを読んでください。
自分のリレーションシップから始めるなら、無料のシングルテーブル設計ツールが、「学生の講座を一覧する / 講座の学生を一覧する」のようなアクセスパターンのリストを、例のアイテム付きの PK/SK/GSI プランに変換してくれます。
それから DynoTable をダウンロードして、学生 ↔ 講座のスキーマを実際にモデル化してみてください。テーブルとその GSI1 を作成し、アイテムエディタでエッジを書き、リレーションシップの両方向を 1 度のスキャンもなしに照会します。