DynamoDBテーブルをCSVにエクスポートする方法(4つの方法)
DynamoDBにネイティブの「CSVにエクスポート」ボタンはありません。すべての値はDynamoDBのマーシャリングされたJSON({"S": "..."}、{"N": "123"}、{"M": {...}})に包まれて返ってきますし、テーブルにはネストされたマップ、リスト、セットが入っていて、自明なフラットカラム表現がありません。
つまり「DynamoDBをCSVにエクスポートする」は実際には2つの問題です:アイテムを取り出すこと、そして型付きJSONを行にフラット化することです。CLIとマネージドS3エクスポートが行うのは1つ目のステップだけです。
DynamoDBテーブルをCSVにエクスポートするには?
テーブルのサイズと、どれくらいの頻度で必要かで選びます:
- フィルタ済み、またはアドホックなCSV(一部のアイテム、一部のカラム): GUIのエクスポート (方法1)かスクリプト。AWSの無料のNoSQL Workbenchもクエリ結果をCSVとしてエクスポートできますが、1ページずつです。
- 小さなテーブル、ターミナルだけ: AWS CLIの
scan+jq(方法2)。 - 大きなテーブル(GB以上): DynamoDBのS3へのエクスポート (方法3)を使い、そこからAthenaでCSVを書き出します。エクスポートは非同期で実行され、読み取りキャパシティを消費せず、一部に絞り込むこともできますが、出力はCSVではなくDynamoDB JSONです。
- 無人実行、夜間ジョブ: 短いスクリプト (方法4)。
方法1:DynoTableからエクスポート
DynoTableはエクスポートを閲覧の一部として扱います:クエリを実行またはフィルタし、⌘⇧E(またはタブのツールバーのエクスポートボタン)を押して、ファイル、CSV、スコープを選び、エクスポートを押します:
- フォーマット: CSV(1アイテムにつき1行、ヘッダー付き)、JSON、NDJSON。JSON/NDJSONは値: プレーンな値(
"count": 3)か、大きな数値を保持するロスレスなラウンドトリップが必要なときはDynamoDB-JSONで出力できます(DynamoDB-JSONにはフィルター完全一致のスコープが必要です)。 - スコープ: 現在読み込み済みの行、選択範囲だけ、またはフィルター完全一致:画面に表示されているものだけでなく、クエリに一致するすべてのアイテムをDynamoDBから直接ストリームします。
- 出力先: ファイル、クリップボード、またはAmazon S3を最初に選びます。S3を選ぶと、テーブルのポイントインタイムリカバリのバックアップから、クエリに一致するアイテムをDynamoDBがあなたのバケットへ書き出します。読み取りキャパシティは使いません。方法3のフィルタ付き版で、出力は引き続きCSVではなくDynamoDB JSONかIonです。単発の取り出しなら、行を右クリックして形式を選んでコピーを使えば、ダイアログなしでCSV、JSON、NDJSON、DynamoDB-JSONをそのままクリップボードに置けます。

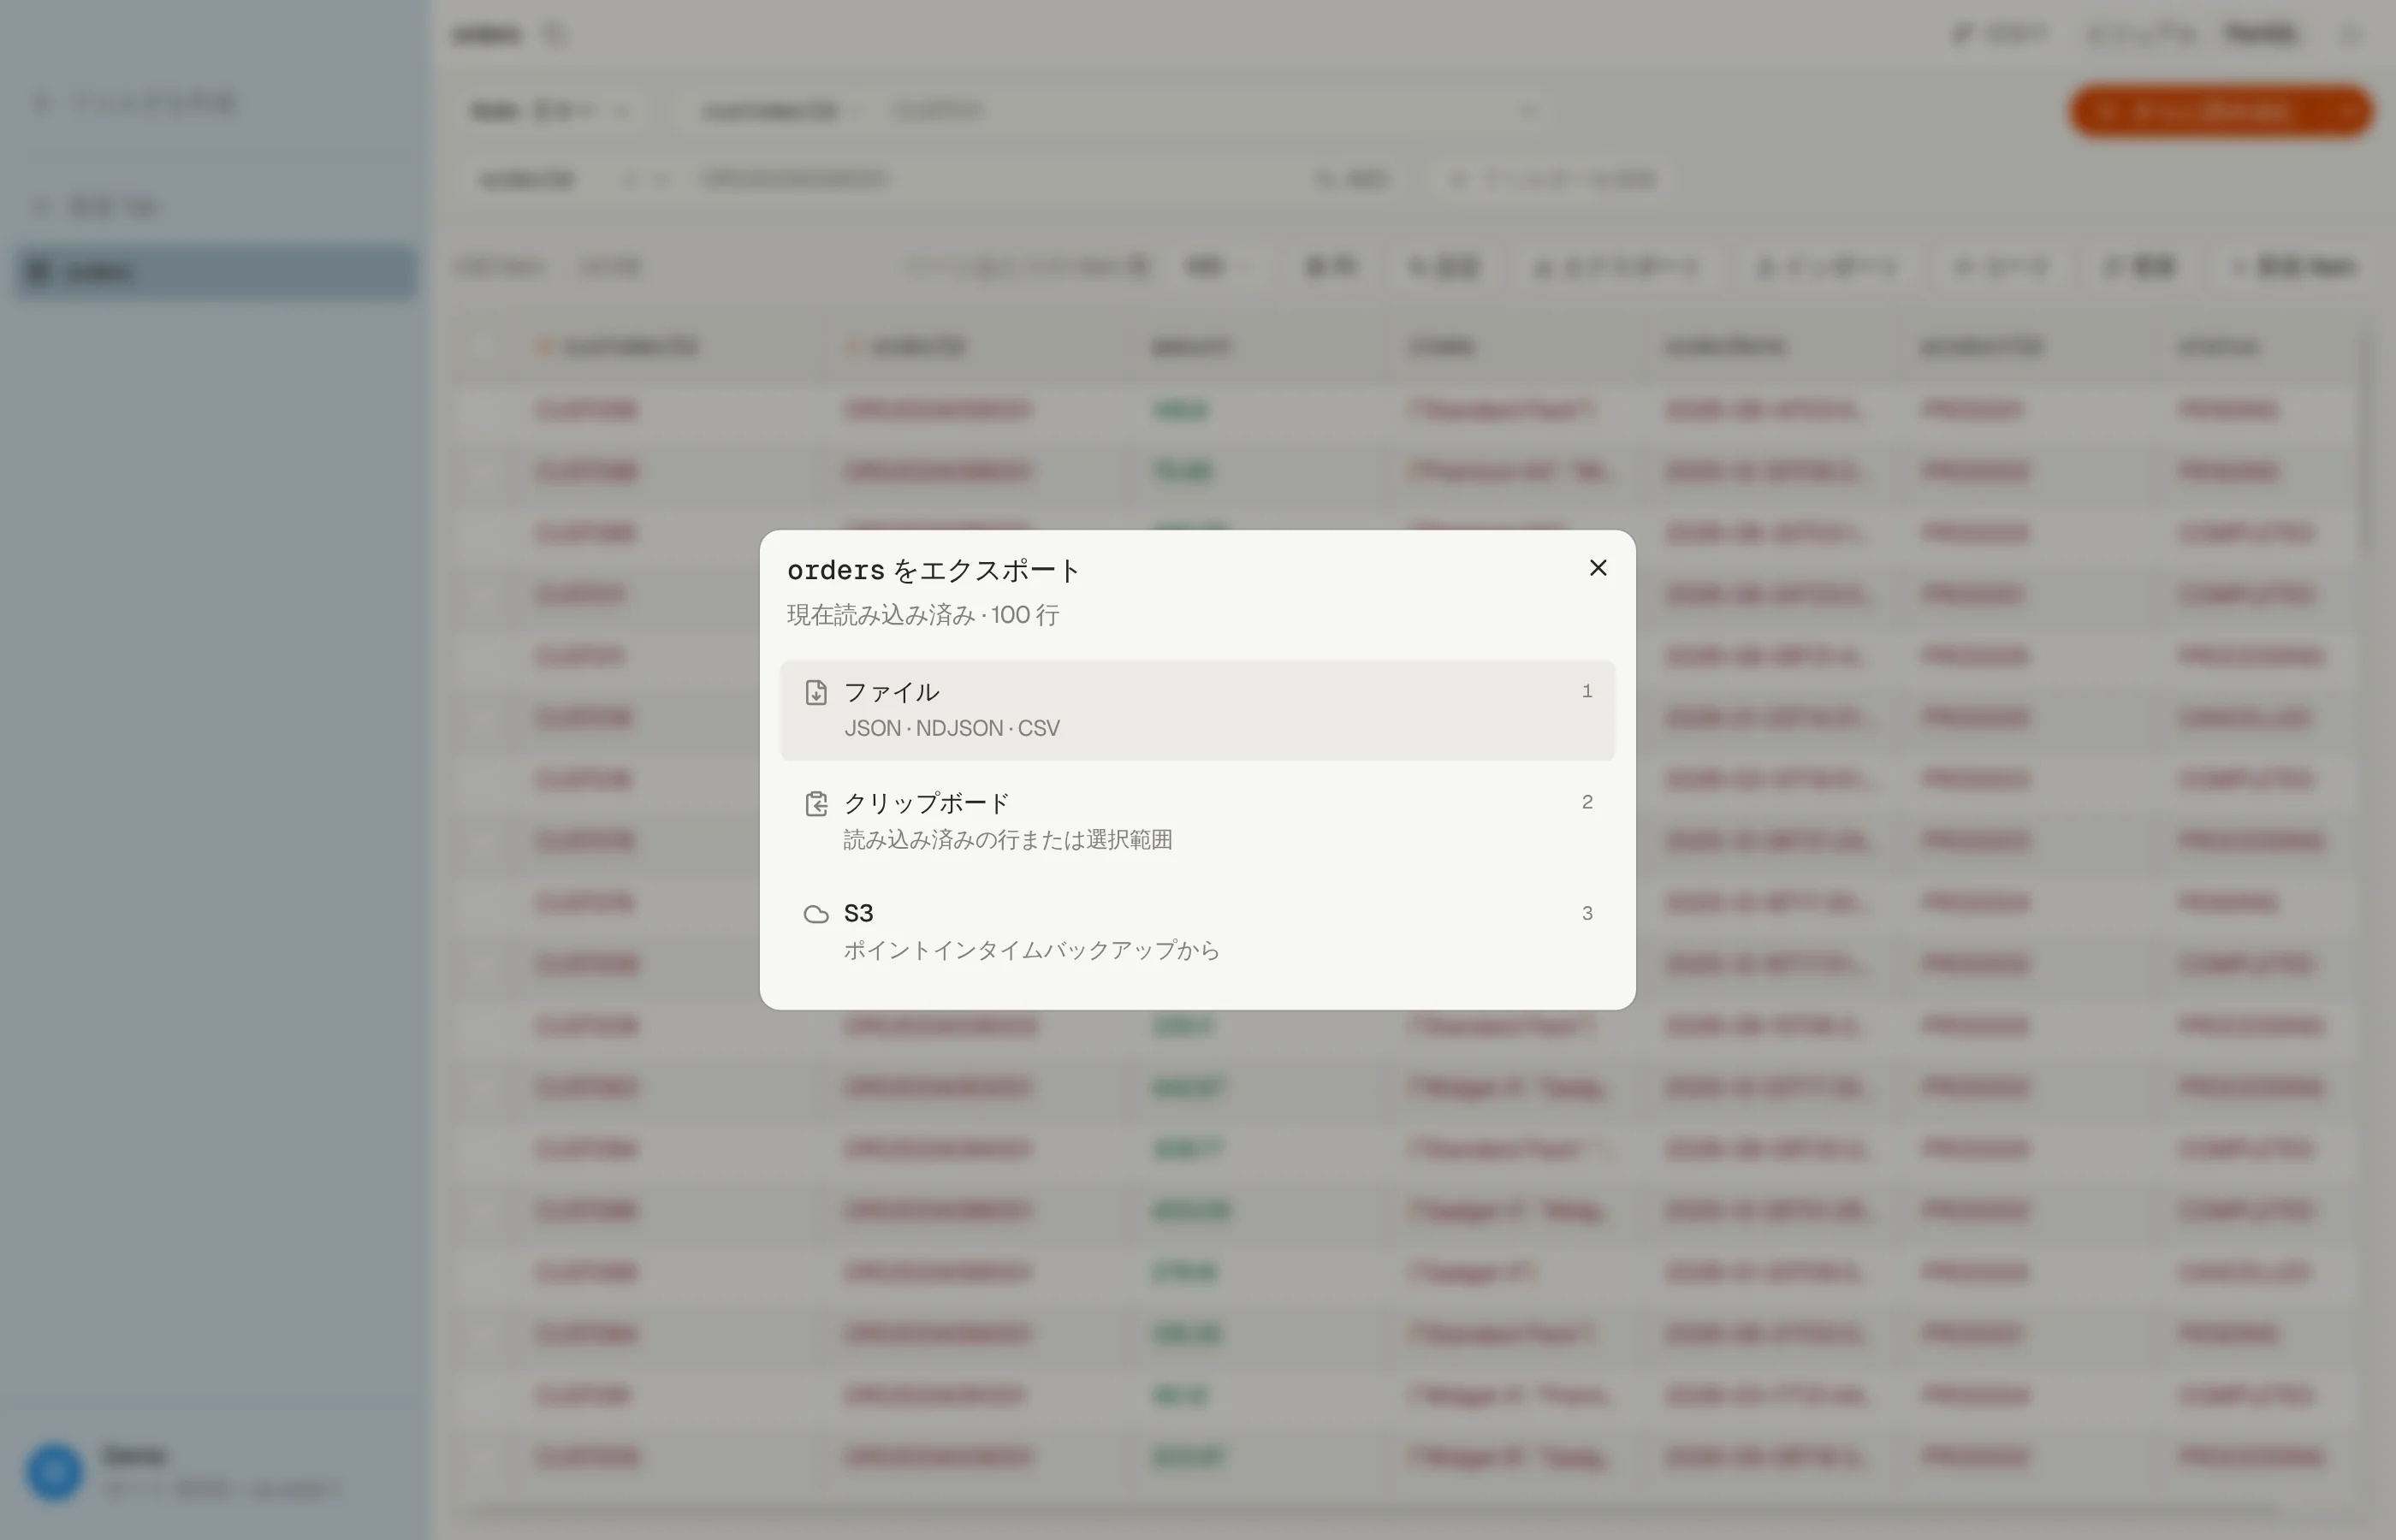

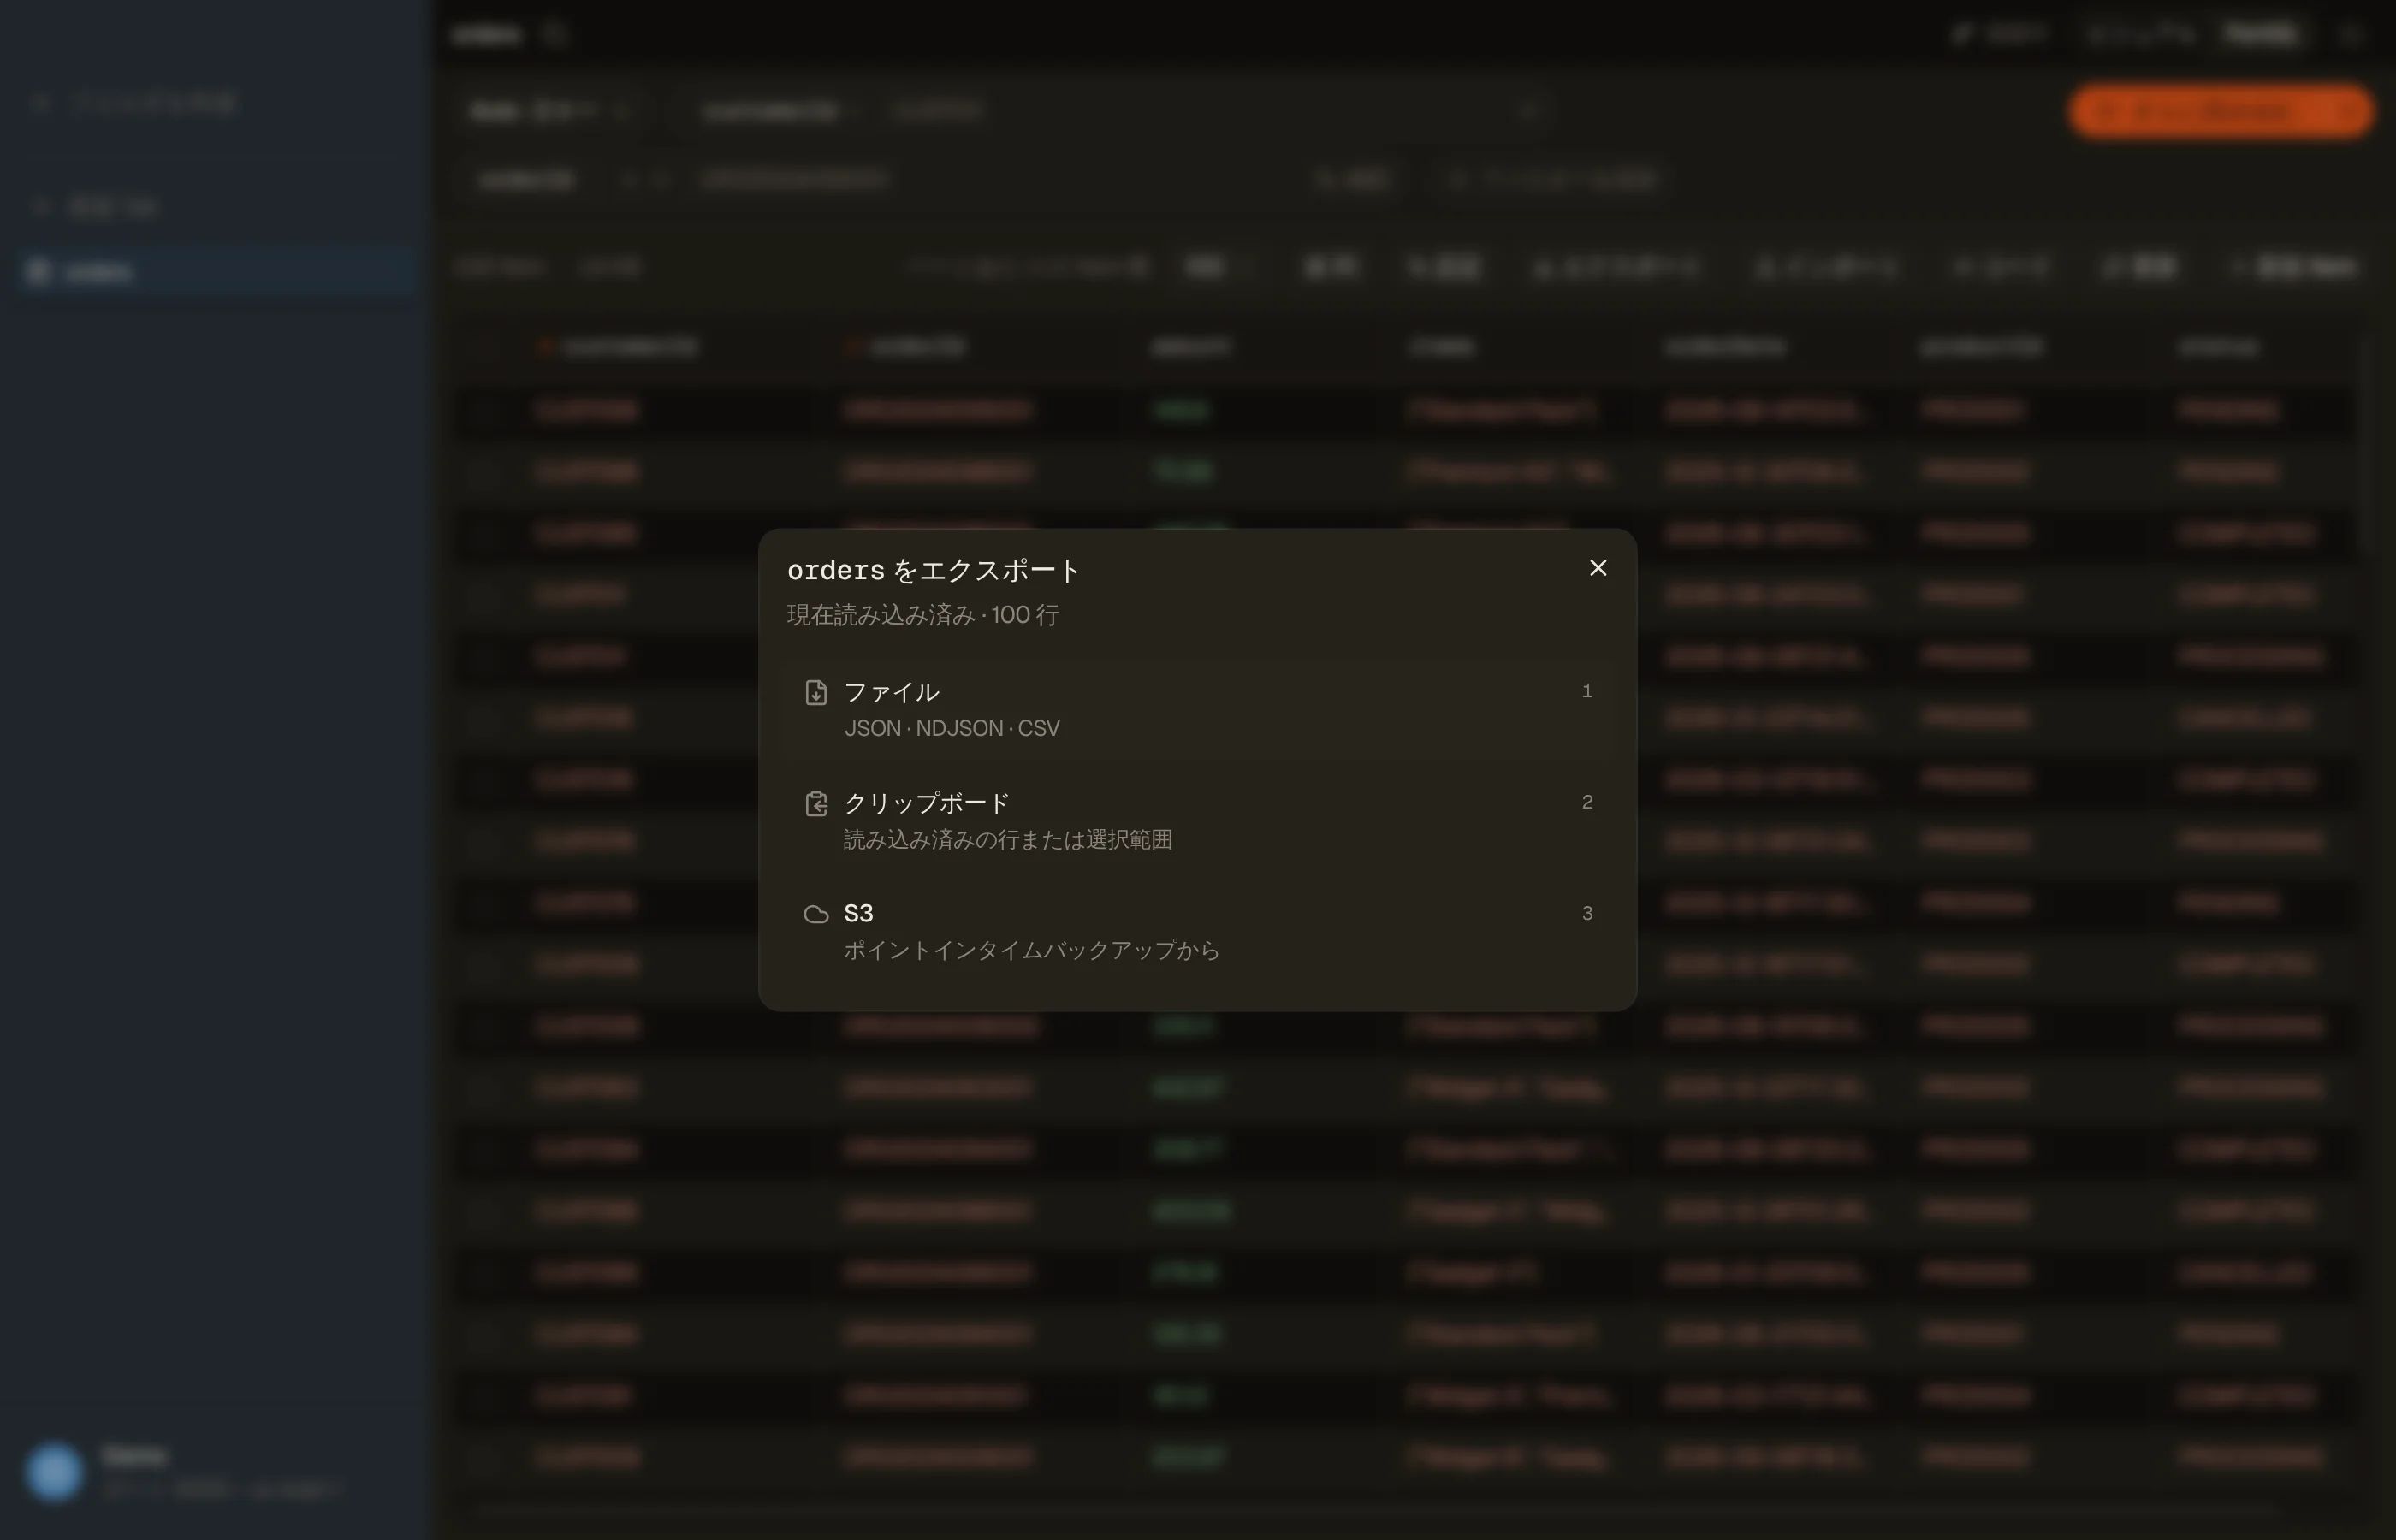
CSVでは型記述子が展開され、ネストされたマップ、リスト、セットは1つのセルにJSONとして入り(セットはJSON配列になるため、その順序に意味はありません)、リネームしたカラムはヘッダーに反映されます。
大きなエクスポートはデタッチしてバックグラウンドで実行されます。1行ずつディスクにストリームされ、タブの切り替えやアプリのリロードさえも生き延びるので、数ギガバイトのエクスポートでもメモリに収まる必要はありません。
これはデスクトップのDynamoDBクライアントで、テーブルの閲覧にすでに使っているのと同じツールです。他のDynamoDB GUIとの比較も参照してください。では、いつ使わないのか?エクスポートをパイプラインの中で無人実行しなければならないときです。それがスクリプトのルート(方法4)の役目です。
方法2:AWS CLIのscan + jq
小さなテーブルなら、スキャンしてjqで出力を整形できます。Scanはテーブル内のすべてのアイテムを読み取り、最大1 MBのページで返します。CLIはページネーションを自動で辿ってくれます
(AWSドキュメント: テーブルのスキャン)。
aws dynamodb scan --table-name MyTable --output json \
  | jq -r '.Items[] | [.id.S, .name.S, .price.N] | @csv' \
> out.csv罠はそのjqの行にあります:.id.S、.name.S、.price.Nを手で書き、各属性の型記述子(S、N、B、BOOL、M、L、SS、NS、BS)を越えて生の値に手を伸ばしています。文字列カラムが3つのフラットなテーブルなら管理できます。しかし次のものが現れた瞬間に崩壊します:
- ネストされたマップ/リスト:
{"M": {...}}や{"L": [...]}にはフラット化する先の単一カラムがなく、@csvはそれらを拒否します。 - セット:
{"SS": ["a","b"]}はスカラーではなく配列です。 - スパース属性:DynamoDBはスキーマレスなので、アイテムAには
priceがあってアイテムBにはないかもしれません。固定のカラムリストは、名前を挙げていないカラムを黙って落とします。
次の版は3つすべてに対応します。スキャン内のすべての属性名からヘッダーを組み立て、バイナリ値はプレーンなbase64として、セットは;で連結した値として、マップとリストは1つのセルにJSONとして(内側の型記述子も含めて)書き出します:
aws dynamodb scan --table-name MyTable --output json > scan.json
jq -r '(.Items | map(keys) | add | unique) as $cols
  | $cols, (.Items[] | [$cols[] as $c | .[$c]
      | if . == null then ""
        else to_entries[0]
          | if .key == "S" or .key == "N" or .key == "B" then .value
            elif .key == "BOOL" then (.value | tostring)
            elif .key == "NULL" then ""
            elif .key == "SS" or .key == "NS" or .key == "BS" then (.value | join(";"))
            else (.value | tojson) end
        end])
| @csv' scan.json > out.csv--output csvも存在しません:CLIの出力フォーマットはjson、yaml、yaml-stream、text、table、offで、どれもDynamoDBの型を理解しません。つまり型タグを剥がすには依然としてjq(かスクリプト)が必要です。
この方法でより大きなテーブルを一日がかりにせずエクスポートするには、--segment / --total-segmentsでスキャンを並列化し
(AWSドキュメント: 並列スキャン:
DynamoDBは "assigns items to segments by applying a hash function to each item's
partition key" ため、セグメントは不均等になりえます)、最初の1 MBページで止まらないようにページネーションを読んでください。
方法3:DynamoDBのS3へのエクスポート(大きなテーブル)
大きなテーブルには、マネージドのAmazon S3へのエクスポートが正しいツールです。ポイントインタイムリカバリ(PITR)のウィンドウ内の任意の時点のスナップショットをエクスポートするので、まずテーブルでPITRを有効化しておく必要があります。そうでなければエクスポートはPointInTimeRecoveryUnavailableExceptionで失敗します。
エクスポートは非同期で実行され、読み取りキャパシティユニットを消費しません (AWSドキュメント: "Exports are asynchronous, they don't consume read capacity units (RCUs) and have no impact on table performance and availability"、"You need to enable PITR on your table to use the export functionality")。
コンソールのExports to S3アクションは同じAPIのフロントエンドで、同じPITR要件と同じJSON出力を伴います。次のコマンドはテーブル全体をエクスポートします:
aws dynamodb export-table-to-point-in-time \
  --table-arn arn:aws:dynamodb:us-east-1:123456789012:table/MyTable \
  --s3-bucket my-export-bucket \
--export-format DYNAMODB_JSON一部だけをエクスポートするにはフィルタを追加します:CLIの--filter-specificationか、コンソールのオプションのフィルタステップです
(フィルタ付きエクスポート)。フィルタは1つのパーティションキーの値に対するキー条件、フィルタ式、射影を受け付けます:
  --filter-specification '{"KeyConditionExpression": "PK = :p",
    "FilterExpression": "#s = :open", "ProjectionExpression": "PK, SK, #s, #t",
    "ExpressionAttributeNames": {"#s": "status", "#t": "type"},
"ExpressionAttributeValues": {":p": {"S": "ACCOUNT#42"}, ":open": {"S": "open"}}}'古いAWS CLIは--filter-specificationをUnknown optionsで拒否します。それが出たらCLIを更新してください。
DynamoDBが読み取って課金するデータを減らすのはキー条件だけで、フィルタ式は読み取りの後に適用されます。DynoTableのS3へのエクスポートはこのフィルタをクエリから組み立てます。
式は通常のルールに従うので、statusやtypeのような予約語はExpressionAttributeNamesでエイリアスしてください。DynamoDBはエクスポートの開始前にフィルタを検証し、そうでなければリクエスト全体をValidationExceptionで拒否します。
エクスポートはCSVを出力しません。書き出すのはDynamoDB JSONかAmazon Ionだけで、JSON-lines形式(1行1アイテム)のgzip圧縮ファイルとマニフェストファイルです(AWSドキュメント: エクスポート出力形式:
データファイルは.json.gzとして書き出され、"the format is JSON lines" で、manifest-summary.json / manifest-files.jsonが付随します)。
CSVへの定番のホップはAthenaで、AWSはAthenaが "will parse this format automatically" と述べています
(エクスポート出力形式)。エクスポートのデータフォルダにテーブルを向け、欲しいカラムを選択します。structの小文字のsとnがエクスポートの"S"と"N"のキーに一致するのは、OpenX JSON SerDeがデフォルトでキーの大文字小文字を無視するためです:
CREATE EXTERNAL TABLE tickets_export (
  Item struct<id:struct<s:string>, status:struct<s:string>, priority:struct<n:string>>
)
ROW FORMAT SERDE 'org.openx.data.jsonserde.JsonSerDe'
LOCATION 's3://my-export-bucket/AWSDynamoDB/<export-id>/data/';

SELECT Item.id.s AS id, Item.status.s AS status, Item.priority.n AS priority
FROM tickets_export;AthenaはすべてのSELECT結果を、ヘッダー行付きのCSVファイルとしてクエリ結果の保存場所に書き出し、コンソールからダウンロードできます。
大きな結果では、SELECTを
UNLOADで
WITH (format = 'TEXTFILE', field_delimiter = ',')と包みます:指定した空のS3プレフィックスに、gzip圧縮されたカンマ区切りのファイルを書き出します。
AWSがカラムヘッダーを文書化しているのは通常のSELECT結果についてだけで、TEXTFILE出力のクォートについては何も述べていません。ヘッダー行はないものと考え、ファイルに頼る前にカンマを含む値を確認してください。値にカンマが含まれうるなら、SELECTの結果を使ってください。
あるいは自前でやる:.gzファイルを解凍し、各JSON行をパースし、フラット化します(他のすべての方法と同じフラット化の問題です)。
方法4:短いスクリプト(boto3 / Node)
エクスポートを無人で実行しなければならないとき(夜間ジョブ、CIステップ)は、小さなスクリプトが上のすべてに勝ります。AWS SDKは型付きJSONをアンマーシャリングしてくれます:boto3のリソースインターフェースとJS SDKのDynamoDBDocumentClientは、{"price": {"N": "2000"}}の代わりにプレーンな値(boto3では{"price": Decimal("2000")})を返します(boto3のリソースインターフェースは、AWS Pythonガイドによれば "the data typing
implicit" にし、JSのDocumentClientは、@aws-sdk/lib-dynamodbによれば "converts annotated response data to native JavaScript types" します)。
import boto3, csv, json
from decimal import Decimal

def cell(v):
    if isinstance(v, (set, frozenset)):          # SS / NS: unordered, so sort
        return ";".join(sorted(str(x) for x in v))
    if isinstance(v, (dict, list)):              # M / L: JSON in one cell
        return json.dumps(v, default=str)
    if isinstance(v, Decimal):                   # N: keep every digit
        return str(v)
    return v

table = boto3.resource("dynamodb").Table("MyTable")
rows, resp = [], table.scan()
rows += resp["Items"]
while "LastEvaluatedKey" in resp:                  # paginate to the end
    resp = table.scan(ExclusiveStartKey=resp["LastEvaluatedKey"])
    rows += resp["Items"]

columns = sorted({k for r in rows for k in r})     # union of attributes
with open("out.csv", "w", newline="") as f:
    w = csv.DictWriter(f, fieldnames=columns)
    w.writeheader()
    for r in rows:
w.writerow({k: cell(r[k]) if k in r else "" for k in columns})cell()ヘルパーは、SDKが代わりに下せない2つの判断を行います:ネストされたマップとリストは1つのセルのJSONになり(address.cityのようなドットパスのカラムが代替案です)、欠けた属性は空のセルになります。マップやリストの中の数値はJSON文字列({"zip": "75001"})として書き出されるので、すべての桁は保たれますが、数値型は失われます。LastEvaluatedKeyのループを落とさないでください:単一のscan()呼び出しは最初の1 MBページしか返さないので、ループなしではテーブルの一部だけを黙ってエクスポートすることになります。
方法2と同じ注意点です:ここでのテーブル全体のscanもやはり読み取りキャパシティを消費し、ライブトラフィックと競合します。大きなテーブルには方法3を使ってダンプを整形するほうを選んでください。
落とし穴:DynamoDB JSONとフラットなCSV
どの方法を選んでも、DynamoDBのデータモデルとフラットなCSVの間の同じ一握りの不一致に噛みつかれます:
- 型記述子。 生のAPI / CLI / S3エクスポートの出力は、すべての値を包みます(
{"S": "..."}、{"N": "123"})。SDKで展開するか、自分で記述子を剥がします。全セットはS、N、B、BOOL、NULL、M、L、SS、NS、BSです。DynamoDBのデータ型を参照してください。 - ネストされたマップとリスト(
M、L)は最大32レベルの深さまでネストでき (AWSドキュメント: データ型: リストとマップは "can be nested within each other, to represent complex data structures up to 32 levels deep")、自然な単一カラムの形がありません。前もって決めてください:セルをJSONエンコードするか、ネストされたキーをドットパスのカラム(address.city)に展開するか。 - セット(
SS/NS/BS)はスカラーではなく順序のないコレクションです。AWSは "the order of the values within a set is not preserved" と警告しています (データ型)。なので区切り文字付きの文字列にフラット化し、要素の順序に依存しないでください。 - スパース属性。 DynamoDBはスキーマレスなので、2つのアイテムが異なる属性を持てます。固定のカラムセットは存在しません。すべてのアイテムにわたってキーの和集合を取らないと、カラムがずれます。これは1つのテーブルが複数のエンティティの形を保持するシングルテーブル設計の直接の帰結です。
- ページネーション。
Scan(とQuery)は1回の呼び出しで最大1 MBしか返しません。LastEvaluatedKeyでループしなければ、最初のページだけを黙ってエクスポートすることになります。ページネーションを参照してください。 - 数値の精度。 DynamoDBの数値は最大38桁の精度を持ち、文字列として転送されます(AWSドキュメント: データ型: "Numbers can have up to 38 digits of precision"、"All numbers are sent across the network to DynamoDB as strings")。表計算ソフトは長い数値やIDをfloatに強制変換して桁を失うことがあります。Excelではファイルをダブルクリックせず、データ → テキストまたは CSV からを使い、それらのカラムをテキストに設定してください (Microsoftサポート)。
よくある質問
DynamoDBテーブルをCSVにエクスポートする最速の方法は?テーブルによります。小さなテーブルならCLIのscan + jq。大きなテーブルなら、S3エクスポートとAthenaのSELECT。フィルタ済み、またはアドホックな一部ならGUIのエクスポートです:DynoTableでテーブルをフィルタし、⌘⇧Eを押してCSVを選び、スコープを選択します。選択した行から、フィルタに一致するすべてのアイテムまで選べます。
AWS CLIでDynamoDBテーブルをCSVにエクスポートするには?テーブルをスキャンしてjqで出力を整形します(方法2):aws dynamodb scan → jqで各値の型記述子を剥がす → @csv。DynamoDBを理解する--output csvは存在しないため、型の除去は常に自分で行います。方法2では、ネストされたマップ、リスト、セット、スパース属性にも対応するjqフィルタを示しています。
AWSから直接DynamoDBテーブルをCSVにエクスポートできますか?テーブル全体を一段階では無理です。マネージドのS3エクスポートはDynamoDB JSONかAmazon Ionを出力し、CSVは決して出力しません。NoSQL Workbenchはクエリ結果を1ページずつCSVにエクスポートします。それを超えるなら変換ステップが必要です:CLI + jq、スクリプト、S3ダンプに対するAthena、またはフラット化を代行するGUIです。
本番に影響を与えずにDynamoDBテーブル全体をエクスポートするには?
S3へのエクスポート機能(方法3)を使います。非同期で実行され、読み取りキャパシティユニットを消費しないので、テーブルのスループットに対して計測されるScanとは異なり、ライブトラフィックと競合しません
(AWSドキュメント)。
PITRの有効化が必要です。一部のアイテムだけをエクスポートするなら、API、CLI、コンソールのいずれもフィルタを受け付け、DynoTableのS3へのエクスポートはクエリからフィルタを組み立てます。
DynamoDBをS3にCSVとしてエクスポートするには?マネージドエクスポートはS3にDynamoDB JSON / Ionしか書き出さないので、「CSVへ」は2ホップ目です:エクスポートのデータフォルダをAthenaのテーブルとして登録し、SELECT(その結果がCSVファイルです)か、format = 'TEXTFILE'を指定したUNLOADを実行します。--export-format CSVは存在しません。
DynamoDBをExcelにエクスポートするには?まず(上のいずれかの方法で)CSVにエクスポートし、Excelのデータ → テキストまたは CSV からで読み込み、長い数値のIDがfloatに強制変換されないようテキストに設定します。DynamoDBからの直接の.xlsxエクスポートはありません。DynoTableは現在のビューをスプレッドシートでそのまま使えるCSVに保存します。
エクスポートしたJSONのあちこちに{"S": ...}や{"N": ...}があるのはなぜですか?それはDynamoDBのマーシャリングされたワイヤフォーマットです:各値に型記述子がタグ付けされています。CSVを書く前に、SDK、DynamoDB JSONコンバータ、またはGUIでアンマーシャリングしてください。ワイヤフォーマットは、データがAPI、CLI、S3エクスポートのどこから来たかにかかわらず同じです。
DynoTableで自分のテーブルを閲覧、フィルタ、CSVエクスポートするか、まずJSONコンバータでDynamoDB JSONのサンプルを展開してみてください。