DynamoDB の隣接リストパターン
グラフはノードとエッジであり、隣接リストパターンはその両方を1つのテーブルのプレーンなアイテムとして保存します。各エッジは、パーティションキーにソース、ソートキーにターゲットを持つアイテムです。
このガイドでは仕組みを扱います。エッジアイテム、それを逆向きに読むインデックス、そしてそれぞれのコストです。エッジにデータを持つ2つのエンティティ型(学生、コース、成績)に同じパターンを適用した例は、多対多のリレーションシップを参照してください。
DynamoDB の隣接リストパターンとは?
グラフを、リレーションシップ(A が B をフォロー)ごとに1つのエッジアイテムとしてモデル化します。ソースのパーティションに対する Query はそれが指す相手をリストし、2つのキーを入れ替えた GSI はそれを指す相手をリストします。
- エッジはアイテム。 各フォローは独自のアイテムなので、独自のデータ(
createdAt)を持ち、単独で書き込みや削除ができます。 - テーブルが一方向に、GSI がもう一方向に答える。 ベーステーブルは「A は誰をフォローしているか?」に答えます。ターゲットを先頭にキー付けしたインデックスは「誰が A をフォローしているか?」に答えます。
- どちらの読み取りも既知のパーティションキーに対する
Query。 どちらの方向もテーブル全体のScanを必要としません。 - 各読み取りは1ホップ。 フォロー、メンバーシップ、いいね、友達関係が当てはまります。友達の友達を辿るには 1 + N 回の
Query呼び出し(友達1人につき1回)が必要で、コード側でマージします。ミリ秒単位のレイテンシーで深く辿るには、AWS は Amazon Neptune を勧めています。
アクセスパターンとして捉える
SQL の出身者には、フォローグラフは結合テーブルです: follows(follower_id, followee_id)。誰かのフォロワーをリストするには一方の列にインデックスを張り、誰をフォローしているかをリストするにはもう一方にインデックスを張ります。
DynamoDB には結合がないので、各読み取りに直接応えるようにキーを設計します。
まず読み取りを書き出しましょう。ソーシャルのフォローグラフでは:
- ユーザー A は誰をフォローしているか?(フォロー中のリスト)
- 誰がユーザー A をフォローしているか?(フォロワーのリスト)
- A は B をフォローしているか?(単一のポイントルックアップ)
- A のフォロワーは何人か?(プロフィール画面に表示する数)
キーを正しく設計すれば、各読み取りは1回の Query か GetItem になります。
エッジをアイテムとしてモデル化する
テーブルが複数のエンティティ型を保持できるよう汎用的なキー名を使い、ノードの型を値にエンコードします。フォローエッジは、ベーステーブルのキーに加えて、次のセクションでインデックス化する GSI1PK/GSI1SK の組を持ちます。4つすべてをコードで設定します:
| PK | SK | GSI1PK | GSI1SK | attributes |
|---|---|---|---|---|
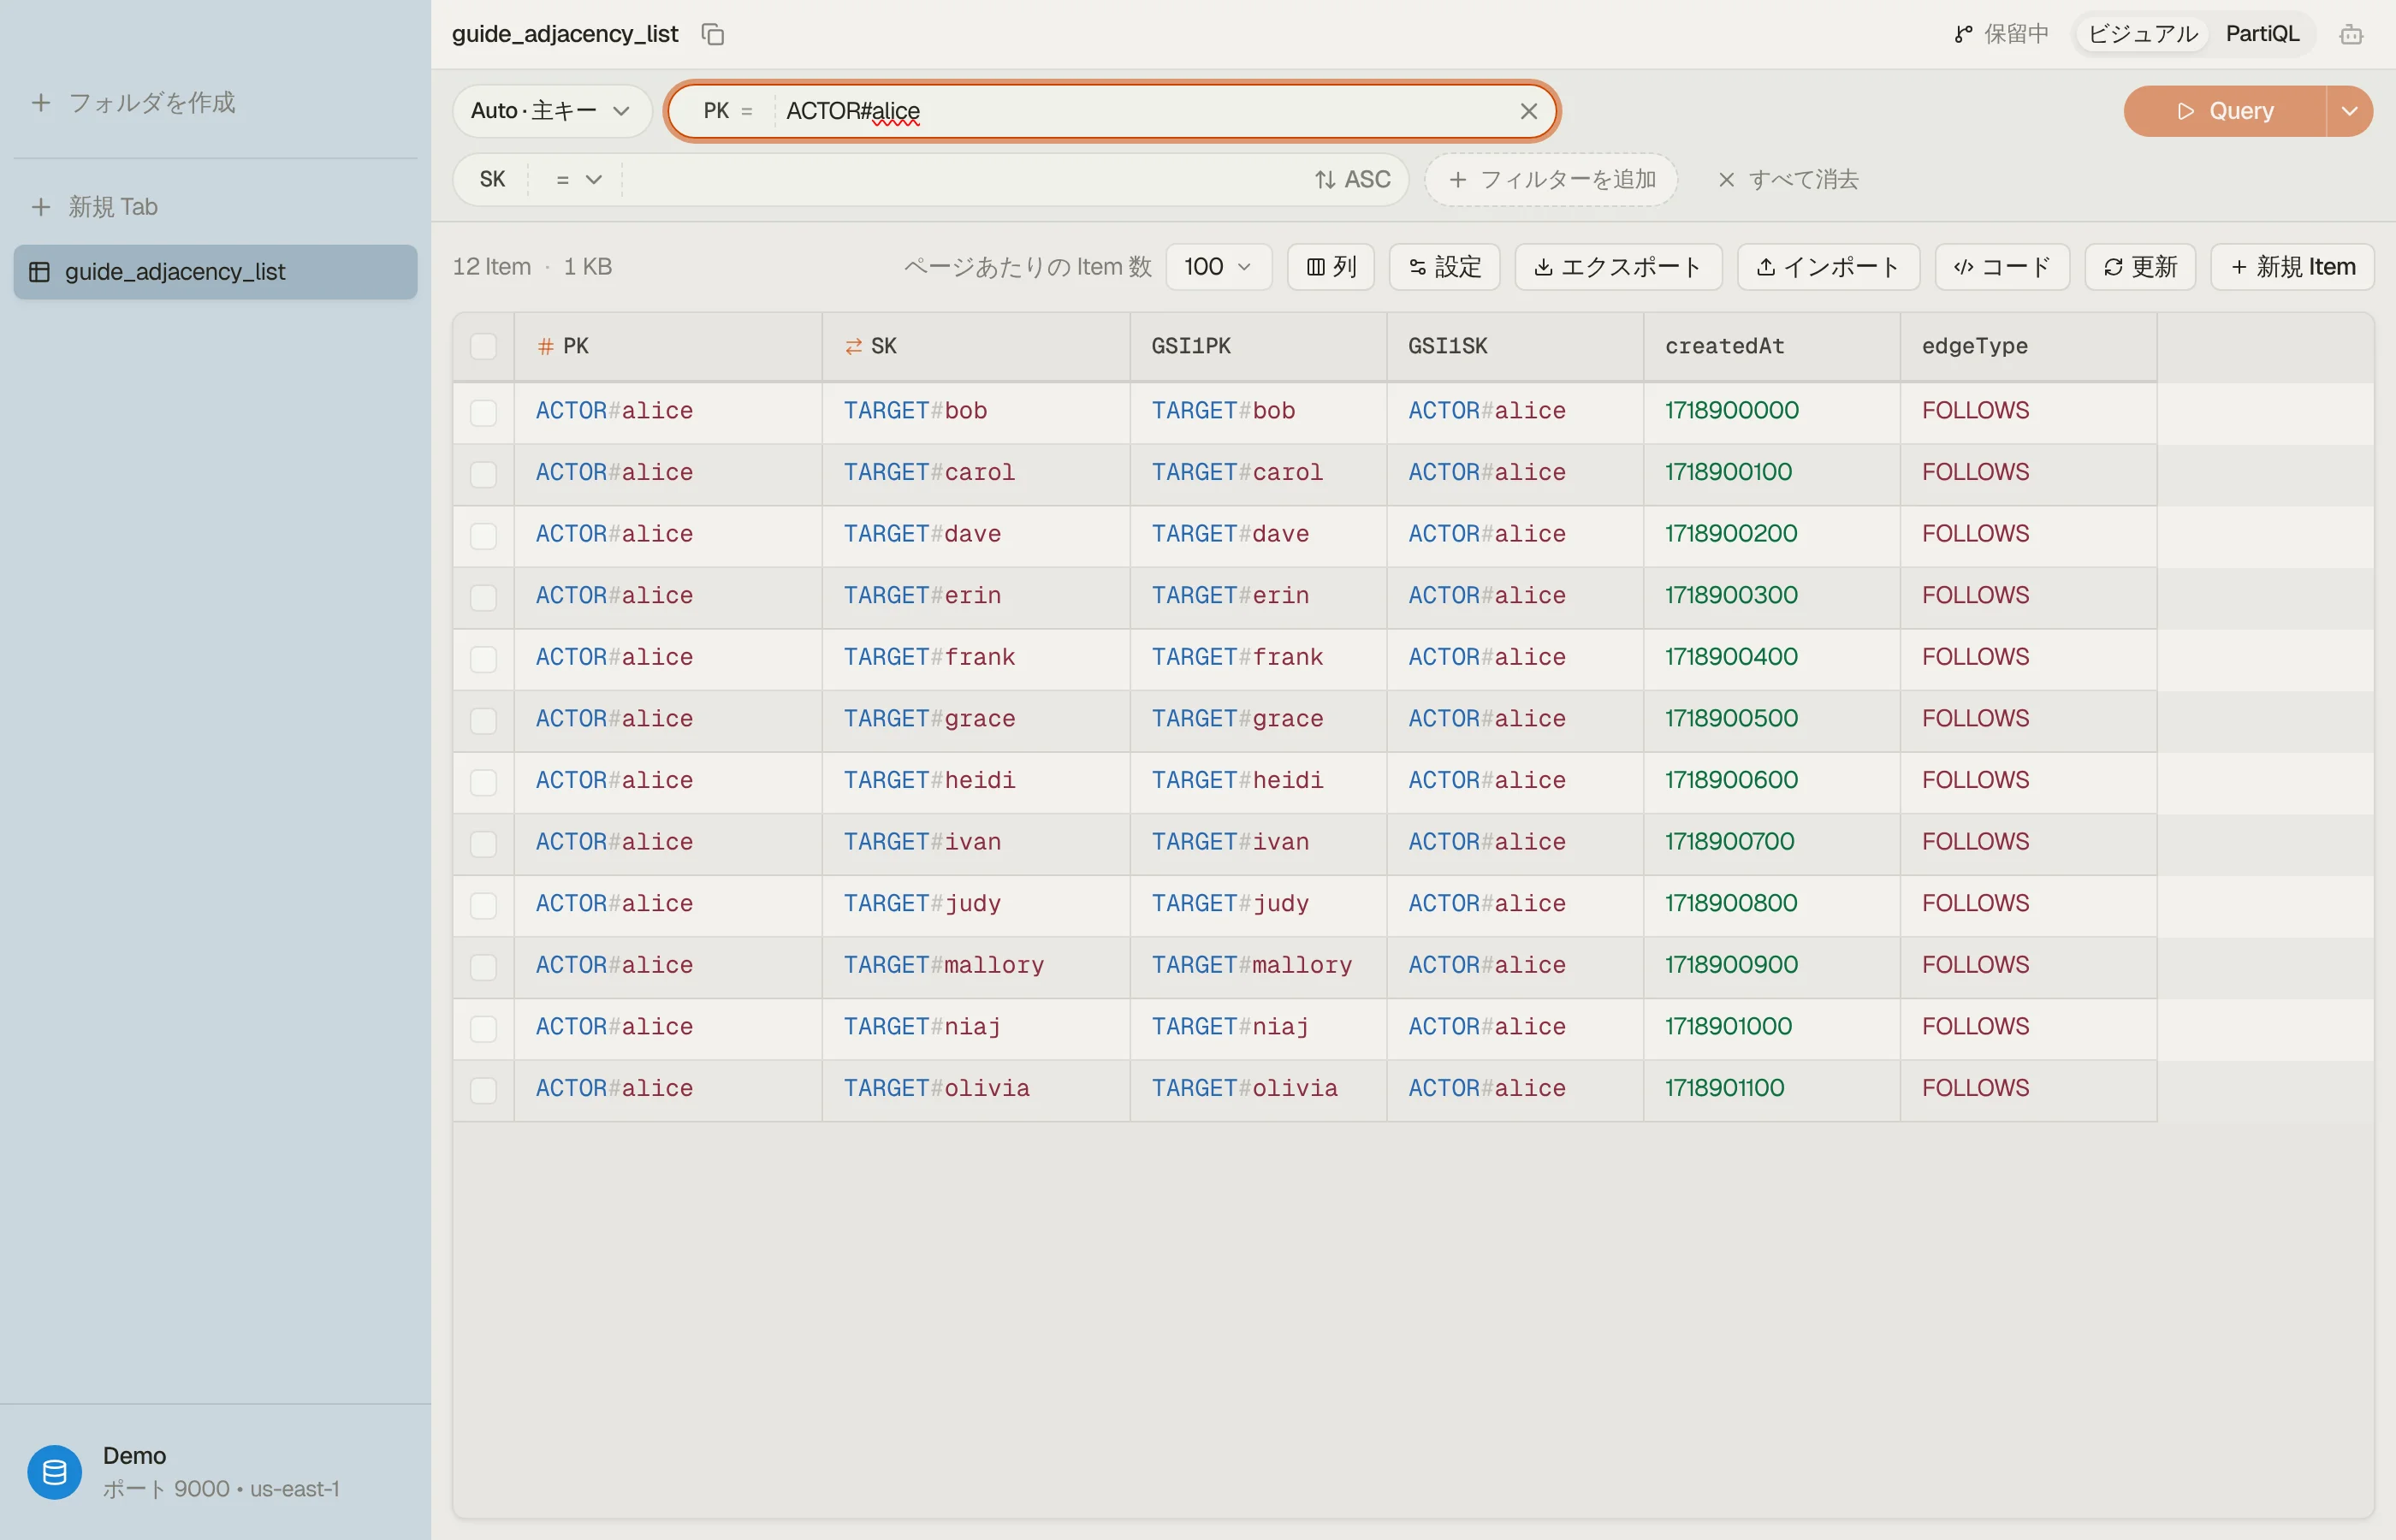
| ACTOR#alice | TARGET#bob | TARGET#bob | ACTOR#alice | createdAt=1718900000 |
| ACTOR#alice | TARGET#carol | TARGET#carol | ACTOR#alice | createdAt=1718900100 |
| ACTOR#dave | TARGET#bob | TARGET#bob | ACTOR#dave | createdAt=1718900200 |
| USER#bob | META | - | - | displayName, followerCount |
PK = ACTOR#alice はエッジのソースで、SK = TARGET#bob は彼女がフォローしている相手です。1回の Query PK = "ACTOR#alice" で、Alice のフォロー中のリスト全体が、1 MB のページ単位で返ります(次のページは LastEvaluatedKey を辿ります)。
USER#bob / META アイテムは Bob のプロフィールです。フォロワー数を保持しているので、プロフィール画面がエッジを数えることはありません。
もう一方向を GSI で辿る
ベーステーブルはソースを先頭にキー付けされているので、スキャンなしには「誰が Bob をフォローしているか?」に答えられません。
GSI1PK をパーティションキー、GSI1SK をソートキーとするグローバルセカンダリインデックス GSI1 を追加します。各エッジではこれらがターゲットとソースを保持しているので、インデックスはエッジを反転させて保存します:
| GSI1PK | GSI1SK | base item |
|---|---|---|
| TARGET#bob | ACTOR#alice | ACTOR#alice to TARGET#bob |
| TARGET#bob | ACTOR#dave | ACTOR#dave to TARGET#bob |
| TARGET#carol | ACTOR#alice | ACTOR#alice to TARGET#carol |
これで Query GSI1 WHERE GSI1PK = "TARGET#bob" が、Bob をフォローしている全員(alice と dave)をリストします。インデックスが保持するのはそのキー属性を持つアイテムだけなので、GSI1PK を持たないプロフィールアイテムはインデックスに入りません。
書き込み呼び出しはエッジ1つにつき1回で、インデックスのコピーは DynamoDB が維持します。そのコピーは課金されます。書き込みコストはベーステーブルへの書き込みとインデックスへの書き込みの合計で、インデックスは独自のストレージも追加します。
古い変種では、ID を入れ替えてエッジを2度書き込みます。GSI はその2度目の書き込みを代わりに行い、そのコピーが最初のものとずれることはありません。
フォロワー方向は結果整合性です。GSI は ConsistentRead を拒否し、新しいフォローは通常1秒もかからずにインデックスに反映されます。
フォローしたばかりのユーザーがすぐにそれを見る必要があるときは、ベースのエッジを GetItem と ConsistentRead: true で読みます。
これは AWS が多対多のモデル化ガイドで文書化しているパターンです。エッジをアイテムとして保存し、GSI を使ってリレーションシップを反転させます。
単一のエッジをチェックし、一度だけ書き込む
「Alice は Bob をフォローしているか?」はどちらのリストも必要としません。エッジは
PK = ACTOR#alice、SK = TARGET#bob でキー付けされているので、ベーステーブルに対する単一アイテムの GetItem です。4 KB までのアイテムなら、結果整合性で 0.5 RCU です。
フォロー自体は、整合していなければならない2つの書き込みです。エッジと、Bob の followerCount への +1 です。両方を1つの TransactWriteItems に入れ、エッジの Put を、それがまだ存在しないという条件でガードします:
attribute_not_exists(PK)すると重複したフォローはその条件で失敗し、DynamoDB はトランザクション全体をキャンセルするので、カウントが二重に増えることはありません。参照カウントでは、このトランザクション、対になるフォロー解除、そしてキャンセルの扱い方を順に説明しています。
その条件とマーシャリングされたキーの値は、ConditionExpression と ExpressionAttributeValues を手書きする代わりに、DynamoDB Expression Builder で組み立てられます。
DynoTable でやってみる
テーブルを閲覧すると、1人のアクターのエッジが単一のパーティションキーの下に1つのアイテムコレクションとして積み重なります。インデックスの選択で GSI1 を選び、GSI1PK = TARGET#bob をクエリすると、反転したフォロワーリストが表示されます。


落とし穴
人気者のパーティション。 数百万人のフォロワーを持つユーザーは、すべてのフォロワーエッジを1つの GSI1PK = TARGET#<star> 値の下に集中させます。そのリストの読み取りは 1 MB ずつページングされ、新しいフォロワーはすべて同じインデックスパーティションに書き込みます。
危険なのは書き込み側です。書き込みキャパシティが不足したインデックスはベーステーブルへの書き込みをスロットルするので、1人のスターへのフォローの嵐がテーブルへのすべての書き込みを遅くすることがあります。
解決策は、インデックスキーにシャードサフィックスを付けることです。GSI1PK = TARGET#bob#<n> と書き込み、n はフォロワー ID のハッシュを N で割った余りにします。「誰が Bob をフォローしているか」は、サフィックスごとに1回、計 N 回の Query 呼び出しになり、コード側でマージします。
「Alice は Bob をフォローしているか」はベーステーブルに対する単一の GetItem のままで、サフィックスの影響は受けません。
N はピークから見積もります。1 KB 未満のエッジは1書き込みユニットで、1つのインデックスパーティションは毎秒約 1,000 をさばくので、N はスターのピーク時の毎秒フォロー数 ÷ 1,000 を、余裕を持たせて切り上げた値です。
ランダムと計算のどちらのサフィックスを選ぶかはホットパーティションで扱っています。
フォロワー数はユーザーアイテムに保持する。 プロフィール表示のたびにパーティション全体を読んで数えることで導出してはいけません。followerCount はエッジと同じトランザクションで増やします(上記)。
スターのカウントも1つのアイテムなので、毎秒およそ 500 フォローを超えると、アトミックカウンターのシャーディングされたカウンターが必要になります。
完全なプロフィールの取得。 エッジが保持するのは ID であり、プロフィールではありません。Alice がフォローしている人々を表示するには、彼女のページから TARGET# の ID を取り出し、それらの USER#<id> / META アイテムを1回の BatchGetItem(1回の呼び出しで最大 100 キー)で取得します。
あるいは、エッジを書き込むときに表示名をエッジにコピーし、名前変更時にはすべてのエッジを更新することを受け入れます。
次のステップ
隣接リストはシングルテーブル設計のリレーションシップの構成要素です。反転インデックスは LSI ではなく GSI です。パーティションキーが変わるからです。ここでのすべての読み取りは既知のキーに対する Query か GetItem であり、決して Scan の罠ではありません。
この形を自分のエッジリストから下書きするには、無料のシングルテーブル設計ツールが、アクセスパターンを例のアイテム付きの PK/SK/GSI プランに変換してくれます。
DynamoDB Expression Builder で条件式とキー式を構築し、DynoTable をダウンロードして、自分のテーブルに対してフォローグラフをモデル化し、それぞれの方向が独自の Query から返ってくる様子を確かめましょう。