インポート
DynoTable は CSV、JSON、NDJSON ファイルを既存のテーブルへインポートします — エクスポートの対になる機能です。ファイル全体を 1 行も書き込む前にチェックするので、不正なファイルは行番号付きで失敗し、データが中途半端にインポートされたまま残ることはありません。
テーブルツールバーの インポート ボタンから開きます。インポートはテーブルに書き込むため、Trialing または Active なライセンスが必要です。

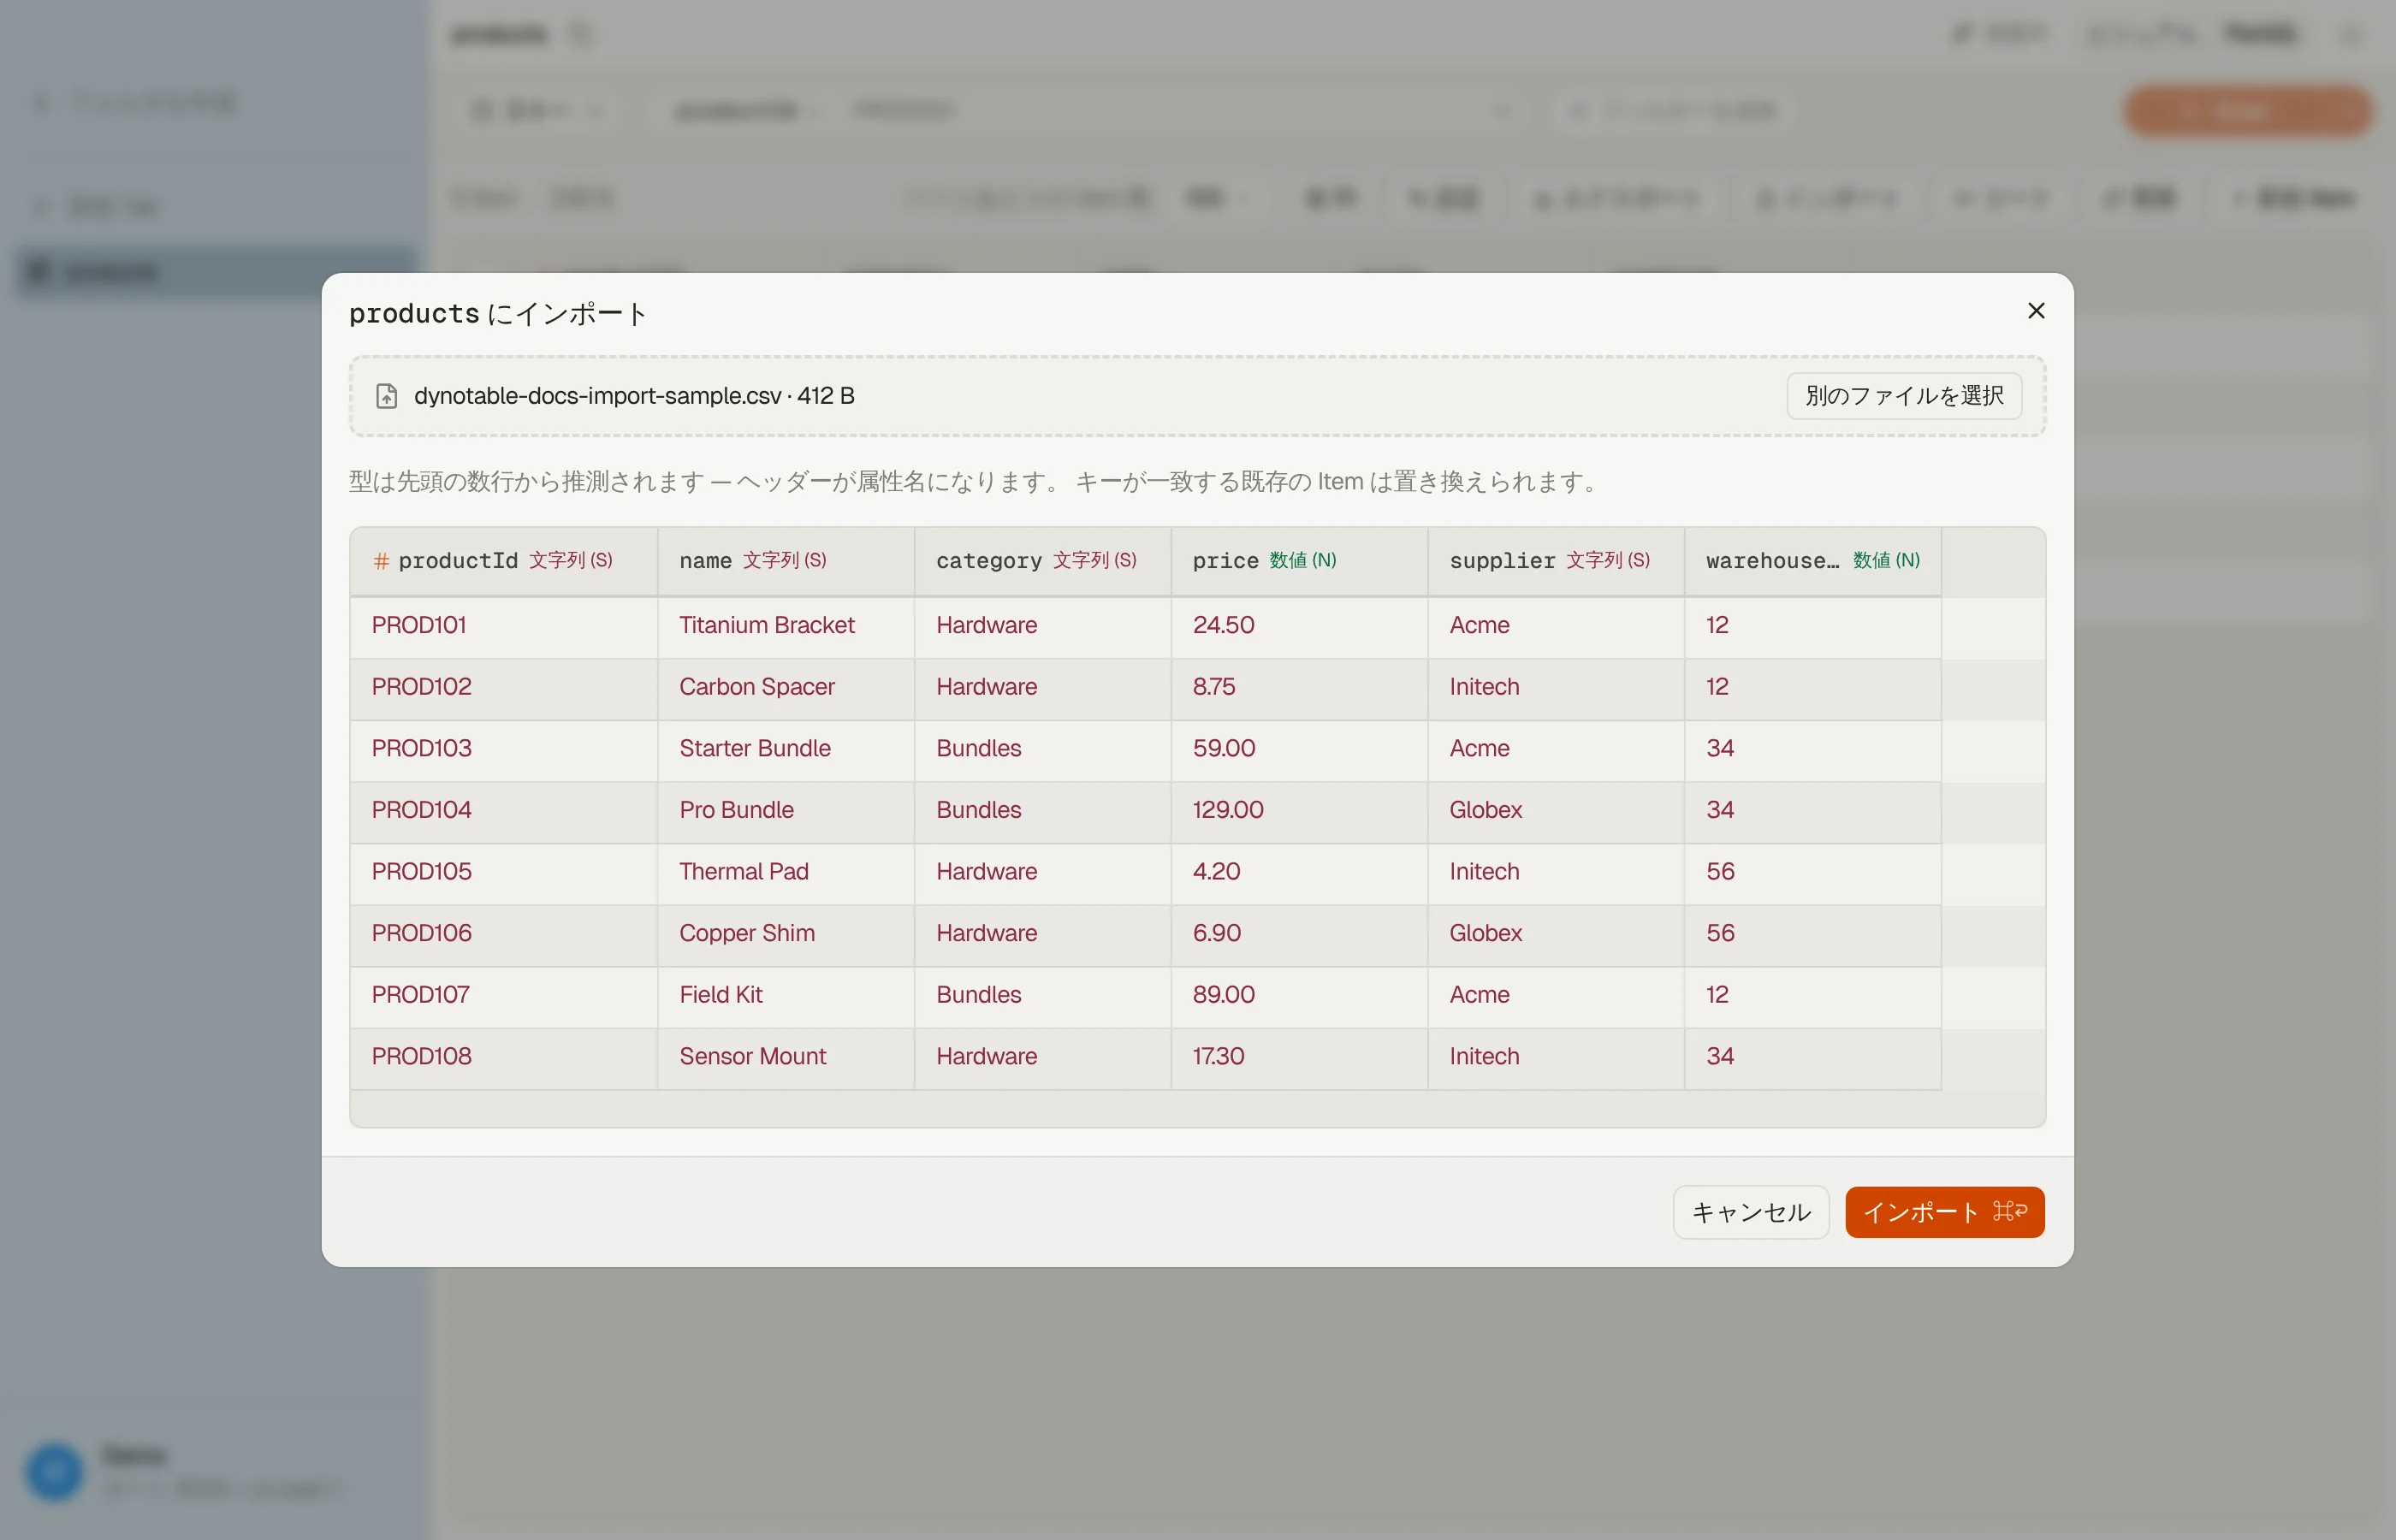

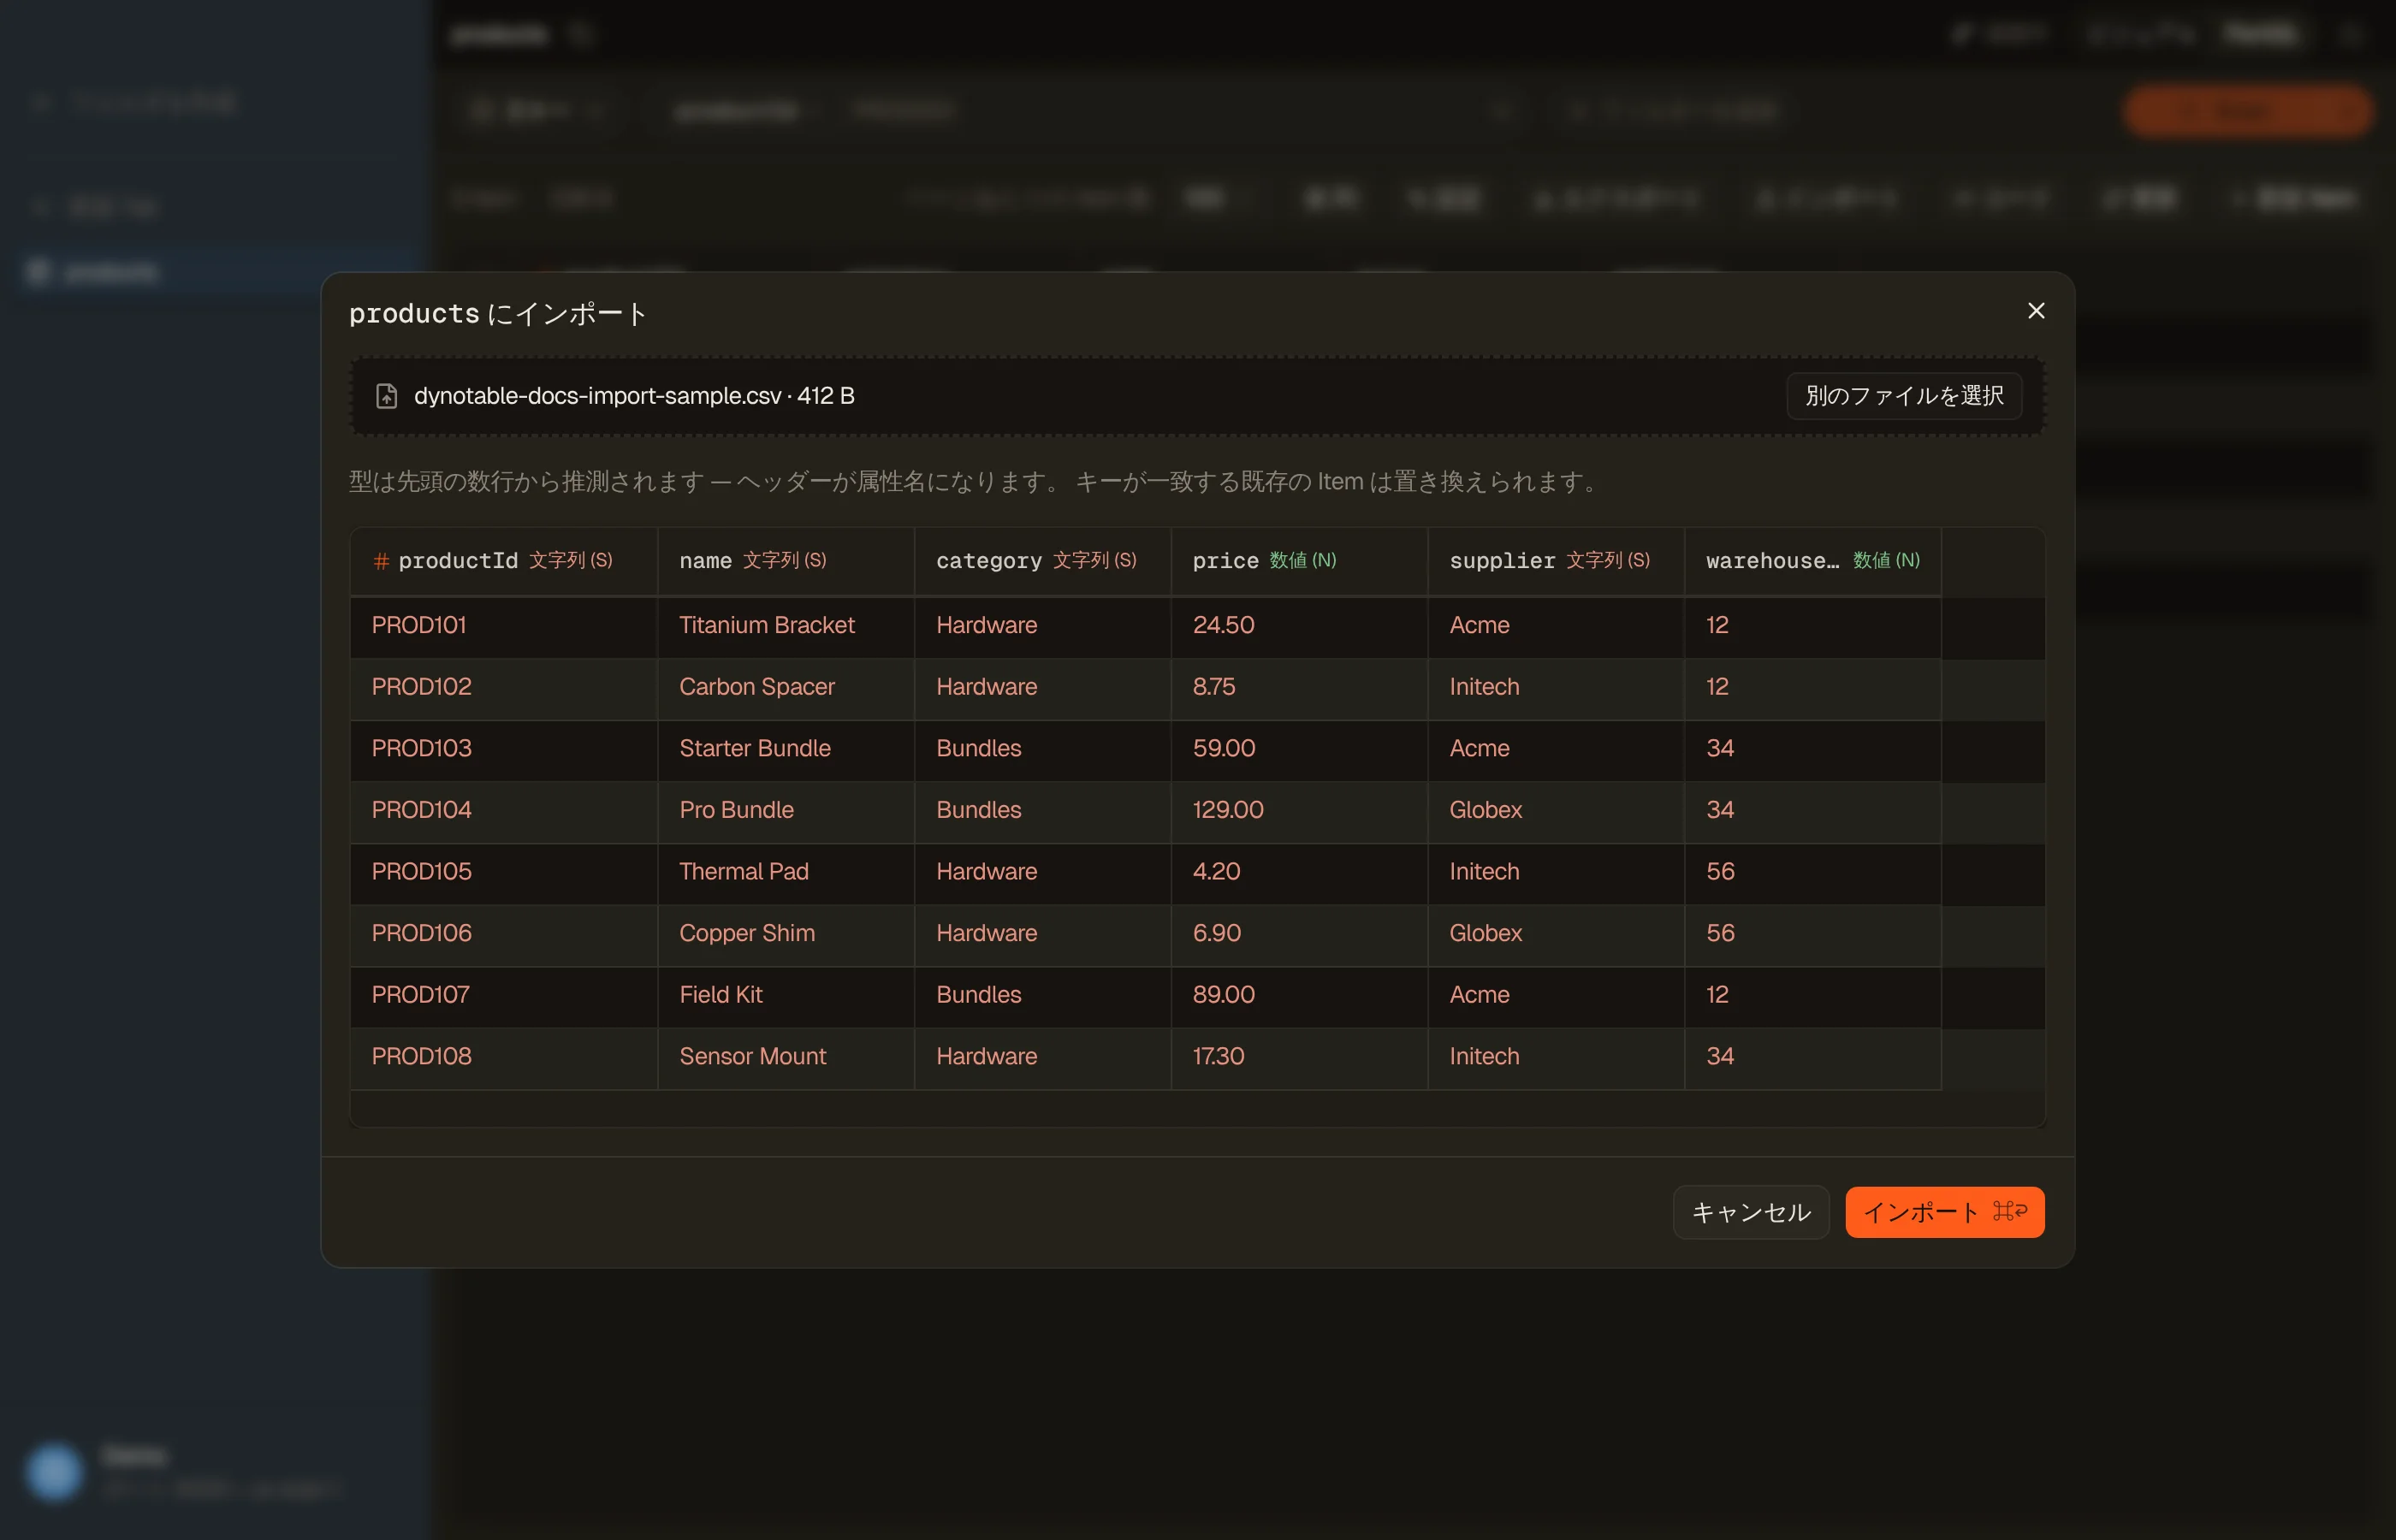
インポートはすでに存在するテーブルへデータを読み込みます — テーブルを新規に作ることはありません。まずテーブル(とそのプライマリキー)を作成してから、そこへインポートしてください。
忠実度の 2 段階
完全 — マーシャリング済み(DynamoDB-JSON)のワイヤ形式で書かれた JSON / NDJSON。何も推測しません — 値はすでにそれぞれの型を持っているので、この形式で取得したエクスポートは何も変わらずに再インポートされます。データが重要なときはこの形式を使ってください。
簡便 — CSV とプレーンな(アンマーシャリングされた)JSON。これらは型情報を持たないため、DynoTable が列ごとに型を推論し、コミットする前に何を選んだかを表示します。手軽な一方、決められた形で情報が失われます — 詳しくは簡便な形式のファイルで失われる情報を参照してください。
列と型
ファイルのヘッダーが属性名になります。プレビューには、DynoTable が推論した型とともにすべての列が一覧表示されます。CSV とプレーン JSON では、列ヘッダーを右クリックすると、ヘッダーが自分の属性名と一致しないときに名前を変更したり、推論された型が望むものと違うときにデータ型を変更したりできます — たとえば、数字だけで構成された商品コードを、数値ではなくテキストのまま保ちたい場合などです。マーシャリング済みの DynamoDB-JSON ファイルは名前と型を自分で持っているため、調整するものは何もありません。
型の候補一覧には、その列の値が実際になり得る型しか表示されません。プレーンテキストの列であれば Map や List は候補に出てきません。候補が 1 つしかない列には一覧自体が表示されません。マッピング用の画面はこれ以上ありません。
ファイルはテーブルの完全なプライマリキーを備えている必要があります。キー属性が欠けている行や、キーの型が間違っている行は、名前を示した上で拒否されます。
ファイル全体が通るまで何も書き込まれない
インポートはファイルを 2 回読みます。1 回目のパスはすべての行を検証し、何も書き込みません。ファイルが通ったときだけ、2 回目のパスで書き込みます。
- 問題は行番号(JSON 配列の場合はアイテムの位置)とともに報告され、一度に最大 20 件まで表示されます。
- 1 つのファイル内に同じキーを持つ行が 2 つあると拒否され、両方の位置が表示されます — DynamoDB は最後の 1 件だけを黙って残してしまいます。
- ファイルを直して再度インポートを押してください。ダイアログは選択したファイルのまま維持されます。
インポートは一致するアイテムを置き換える
インポートされた行は、同じプライマリキーを持つ既存のアイテムを、属性ごとそのまま置き換えます — マージはされません。古いアイテムが持っていてファイルにはない属性は失われます。
インポートはステージングも経由しません。そのため確認ステップも取り消し(revert)もありません。ステージされた編集とは異なり、インポートはアプリの履歴から元に戻すことができません。大切なデータに対しては、まずテーブルのコピーにインポートして結果を確認してください。
制限
| 制限 | 値 |
|---|---|
| CSV / NDJSON のファイルサイズ | 250 MB |
単一の .json 配列 | 50 MB — それ以上は NDJSON を使ってください |
| インポートあたりの行数 | 2,000,000 |
| アイテム 1 件 | 400 KB(DynamoDB 自体の上限) |
.json ファイルは 1 つの大きな配列を丸ごとパースする必要があるため、上限が低くなっています。NDJSON — 1 行に 1 アイテム — はストリーミングできるため、
250 MB まるごと扱えます。
簡便な形式のファイルで失われる情報
以下は CSV とプレーン JSON のみに当てはまります。マーシャリング済みの DynamoDB-JSON 形式にはこうした問題はありません。
- 型は先頭およそ 200 行のサンプルから推論されます。 そこでは数値に見える列が、ファイルの後の方で数値でなくなると、検証中に拒否されます — 直すにはファイル側を修正してください。
- Set とバイナリは CSV で表現できないため、CSV からインポートすることはできません。
- プレーンな値でエクスポートしたバイナリは String として再インポートされます。プレーンな値でのエクスポートはバイナリ属性を base64 のテキストとして書き出し、インポートはテキストからバイナリを推論しません。バイナリをラウンドトリップするには、DynamoDB-JSON の値でエクスポートしてください。
- 空のセルはスキップされ、空文字列としては書き込まれません。アイテムには単純にその属性が存在しなくなります。
- Map と List はそのまま維持されます。 エクスポートはそれらを CSV セルに JSON テキストとして書き込み、インポートはそのテキストを認識して構造を再構築します。あるテキストの列がたまたま JSON のように見えるだけの場合は、プレビューにその結果が表示されるので、その列のデータ型を String に戻すことができます。
- プレーン JSON の非常に大きな数値は、DynoTable が受け取る前に精度が失われます — これは JSON 自体の制約です。厳密な値を保つ必要がある ID や金額には DynamoDB-JSON を使ってください。
- スプレッドシート保護のマークは戻す際に処理されます。 エクスポートは、スプレッドシートが数式とみなすセルの先頭にアポストロフィを付加します。インポート時、
'-5は数値の-5に、'+7はテキストの+7として戻ります — ただし'=SUM(A1)のような本物の数式は、アポストロフィをそのまま維持します。これを取り除くと、そのマークが本来防ぐはずのものが再び有効になってしまいます。
インポート時に行の埋め込みを生成する
テーブルに埋め込みモデルとソース属性が紐付いたベクトルインデックスがある場合、ダイアログにインポート時に埋め込みを生成が表示されます。これをオンにすると、各行は書き込まれると同時に埋め込みが生成されるので、インポートしたアイテムは 2 回目の処理を待たずにそのまま意味で検索できるようになります。この項目には、使われるインデックスとモデル、そして 1 行あたりのテキスト上限が示されます。
実行ごとのオプトインで、インポートを止めることはありません。テキストが長すぎる行やモデルが拒否した行は、ベクトルなしで書き込まれてカウントされ、サマリーが埋め込みなしで届いた行数とその理由を伝えます。ファイル自体が与えた埋め込みはそのまま保たれます。埋め込みの呼び出しは Bedrock が課金するため、ほかの AI 機能と同じく AI の設定とアクティブなプランが必要です。
進捗、キャンセル、失敗
実行中のインポートは、サイドバー下部の アクティビティ パネルにライブの進捗とともに表示され、他のタブで作業している間も継続します。そこから停止することもでき、すでに書き込まれた行はそのまま残ります。
DynamoDB がテーブルを強くスロットリングし、リトライしても一部の行が書き込めなかった場合、インポートは完了し、何行が書き込めなかったかを伝えます。同じファイルを再実行しても安全です — 書き込みに成功していた行は、同じ値でもう一度書き込まれるだけです。
問題なく完了したインポートは、数秒後にアクティビティパネルから自動的に消えます。書き込めなかった行、スキップされた埋め込み、停止、またはエラーがあるインポートは、あなたが閉じるまで残ります: その行が、対応が必要なことを示す唯一の記録だからです。アクティビティのポップアップで見ている間に完了したインポートは、完了 をクリックするまでそこに残ります。