SQL Workbench
Workbench は、DynamoDB テーブルをまたいで実際の JOIN、GROUP BY、集計クエリ — PartiQLにはできないこと — を実行する SQL オーサリングタブです。これは DynamoDB のアクセスパターンの規則の中の SQL です: 単一の
SELECT を書くと、コンパイラがすべての結合が実際のキーまたはインデックスを通って読み取ることを確認し、結合された行をマテリアライズし、その上でステートメントの残り — フィルタ、集計、GROUP BY、ORDER BY — を実行します。
サイドバーの右クリックメニュー(新規 Workbench)、⌘⌥B ショートカット、または ファイル → 新規 Workbench から開きます。SQL を書いて、 ⌘↩ を押して実行します。
エディタは、カーソル位置の SQL コンテキストに応じて、テーブル名と、インデックス化されたフィールドや値を提案します。ローカルインデックスに何が含まれ、どう更新するかはテーブルの概要とインデックス作成を参照してください。
SELECT c.email, COUNT(*) AS orders, SUM(o.total) AS revenue
FROM orders o
JOIN customers c ON o.customerId = c.id
GROUP BY c.email
ORDER BY revenue DESC
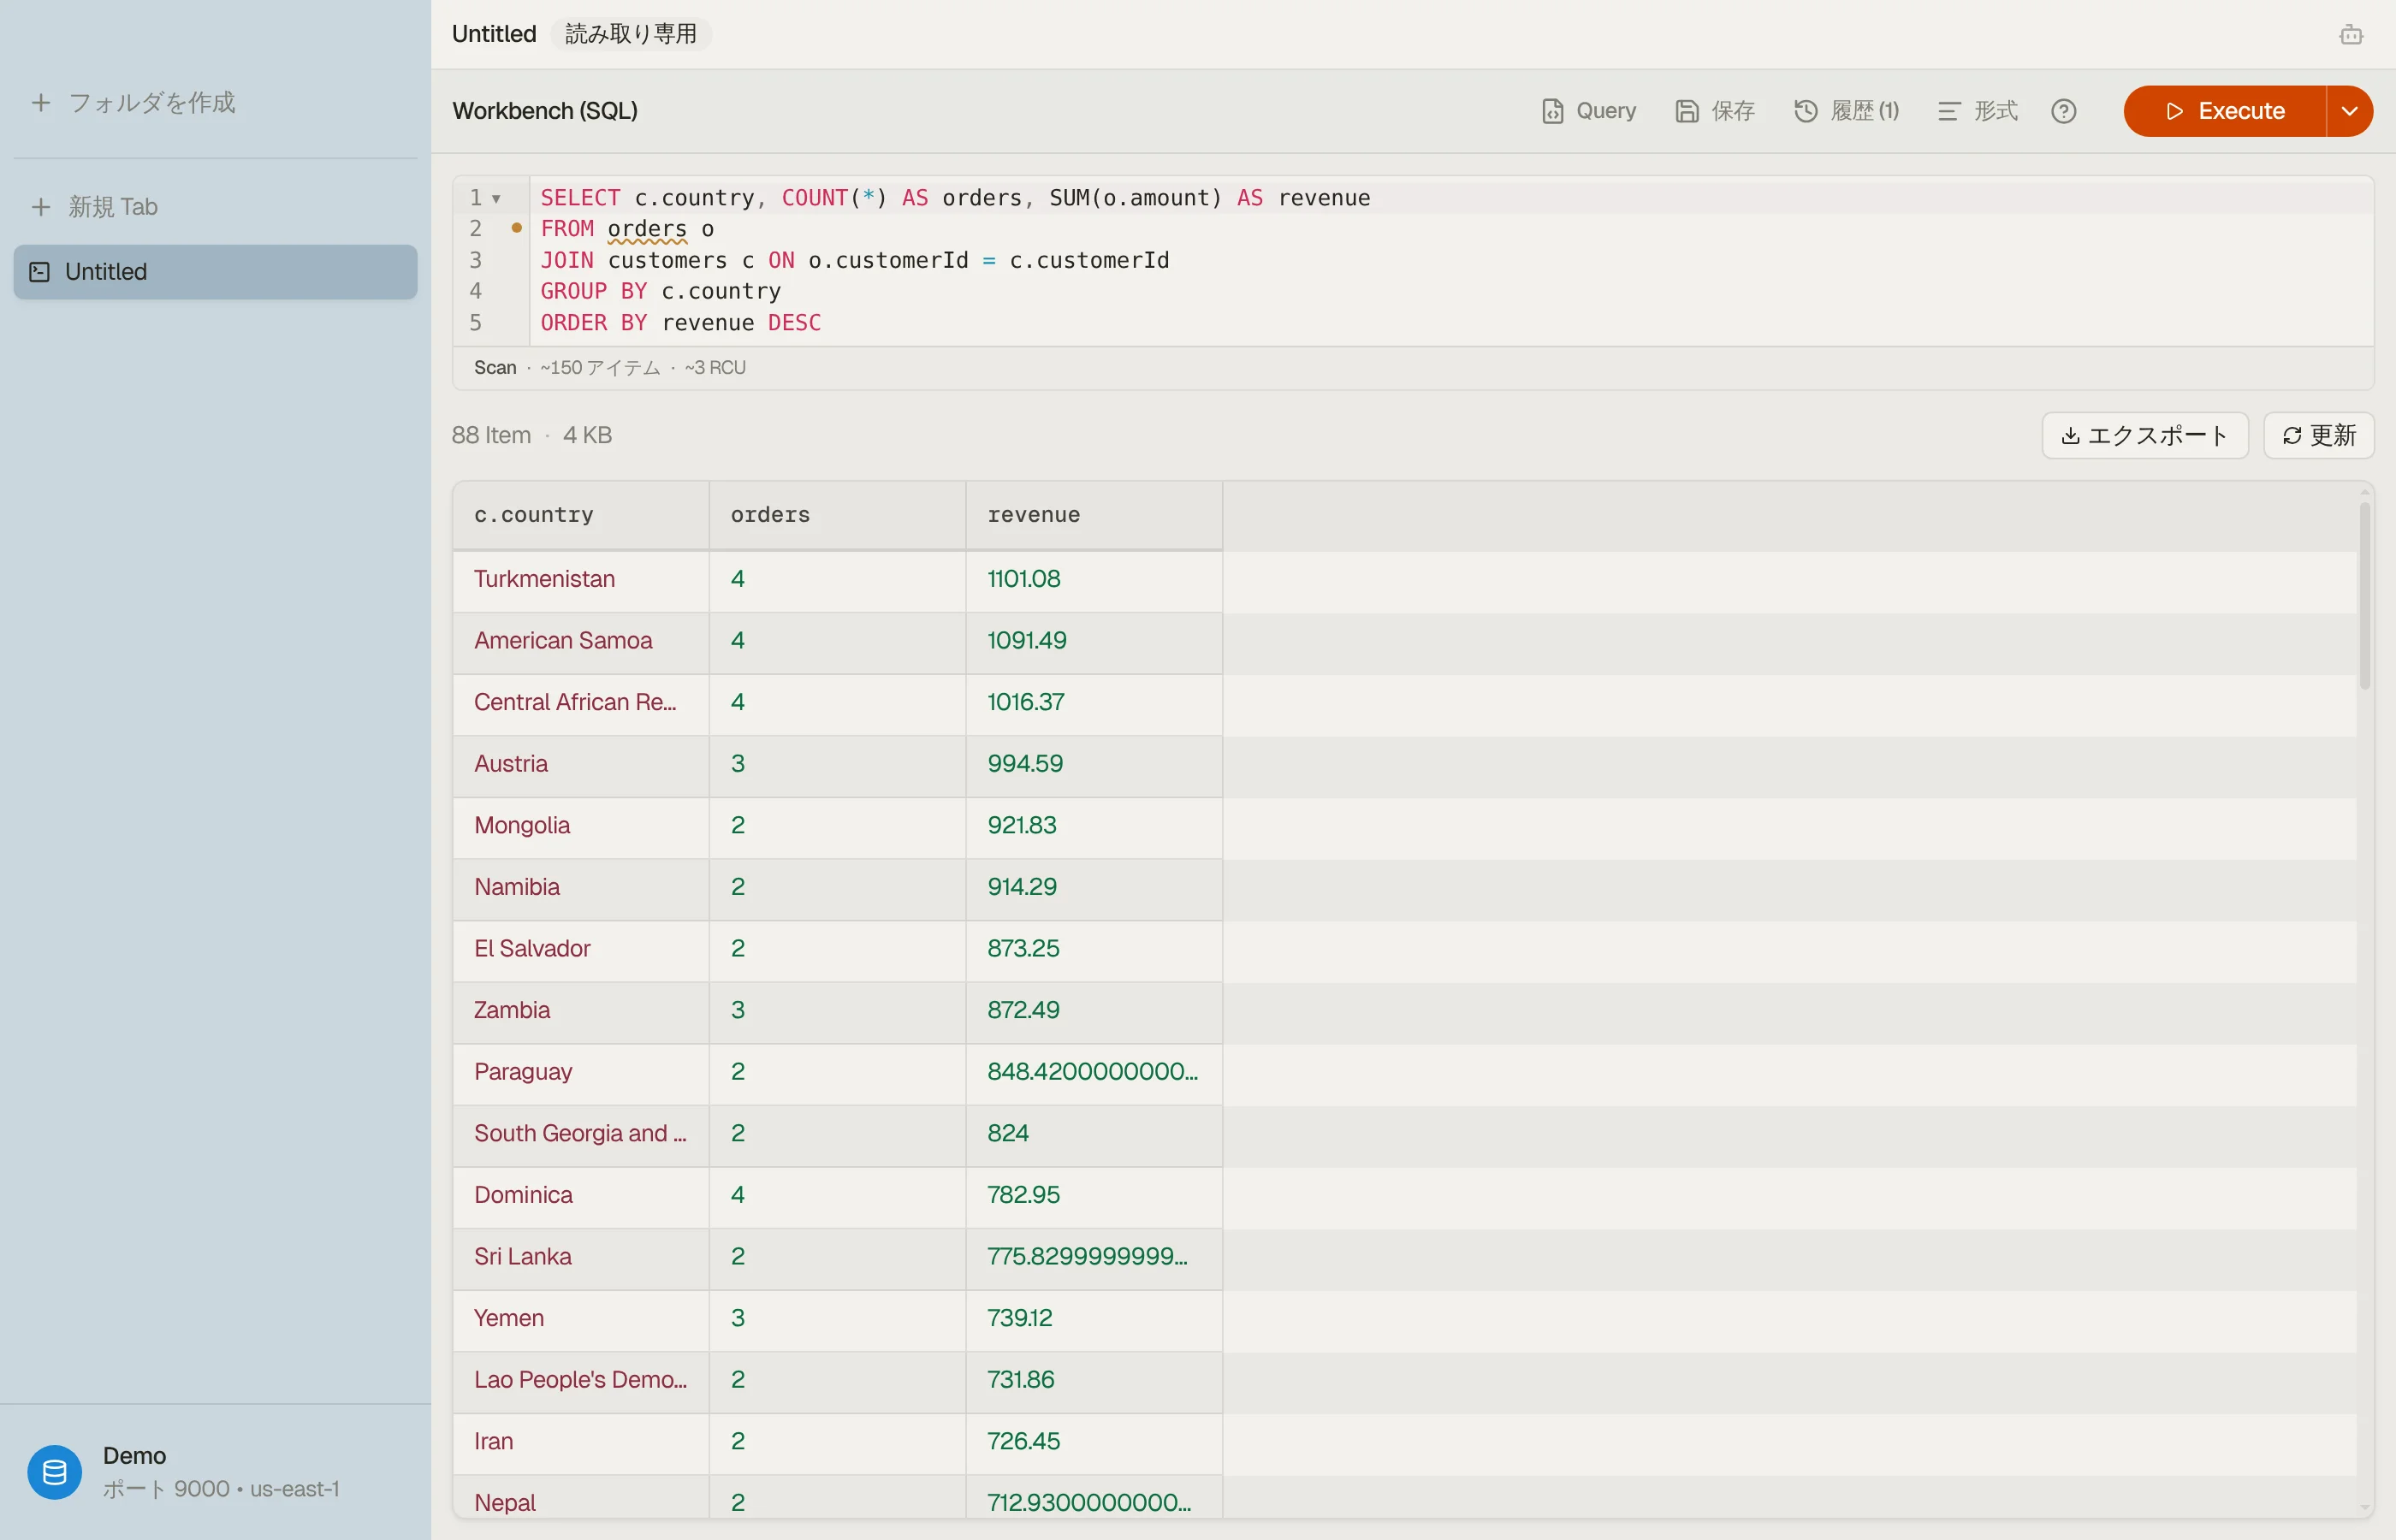

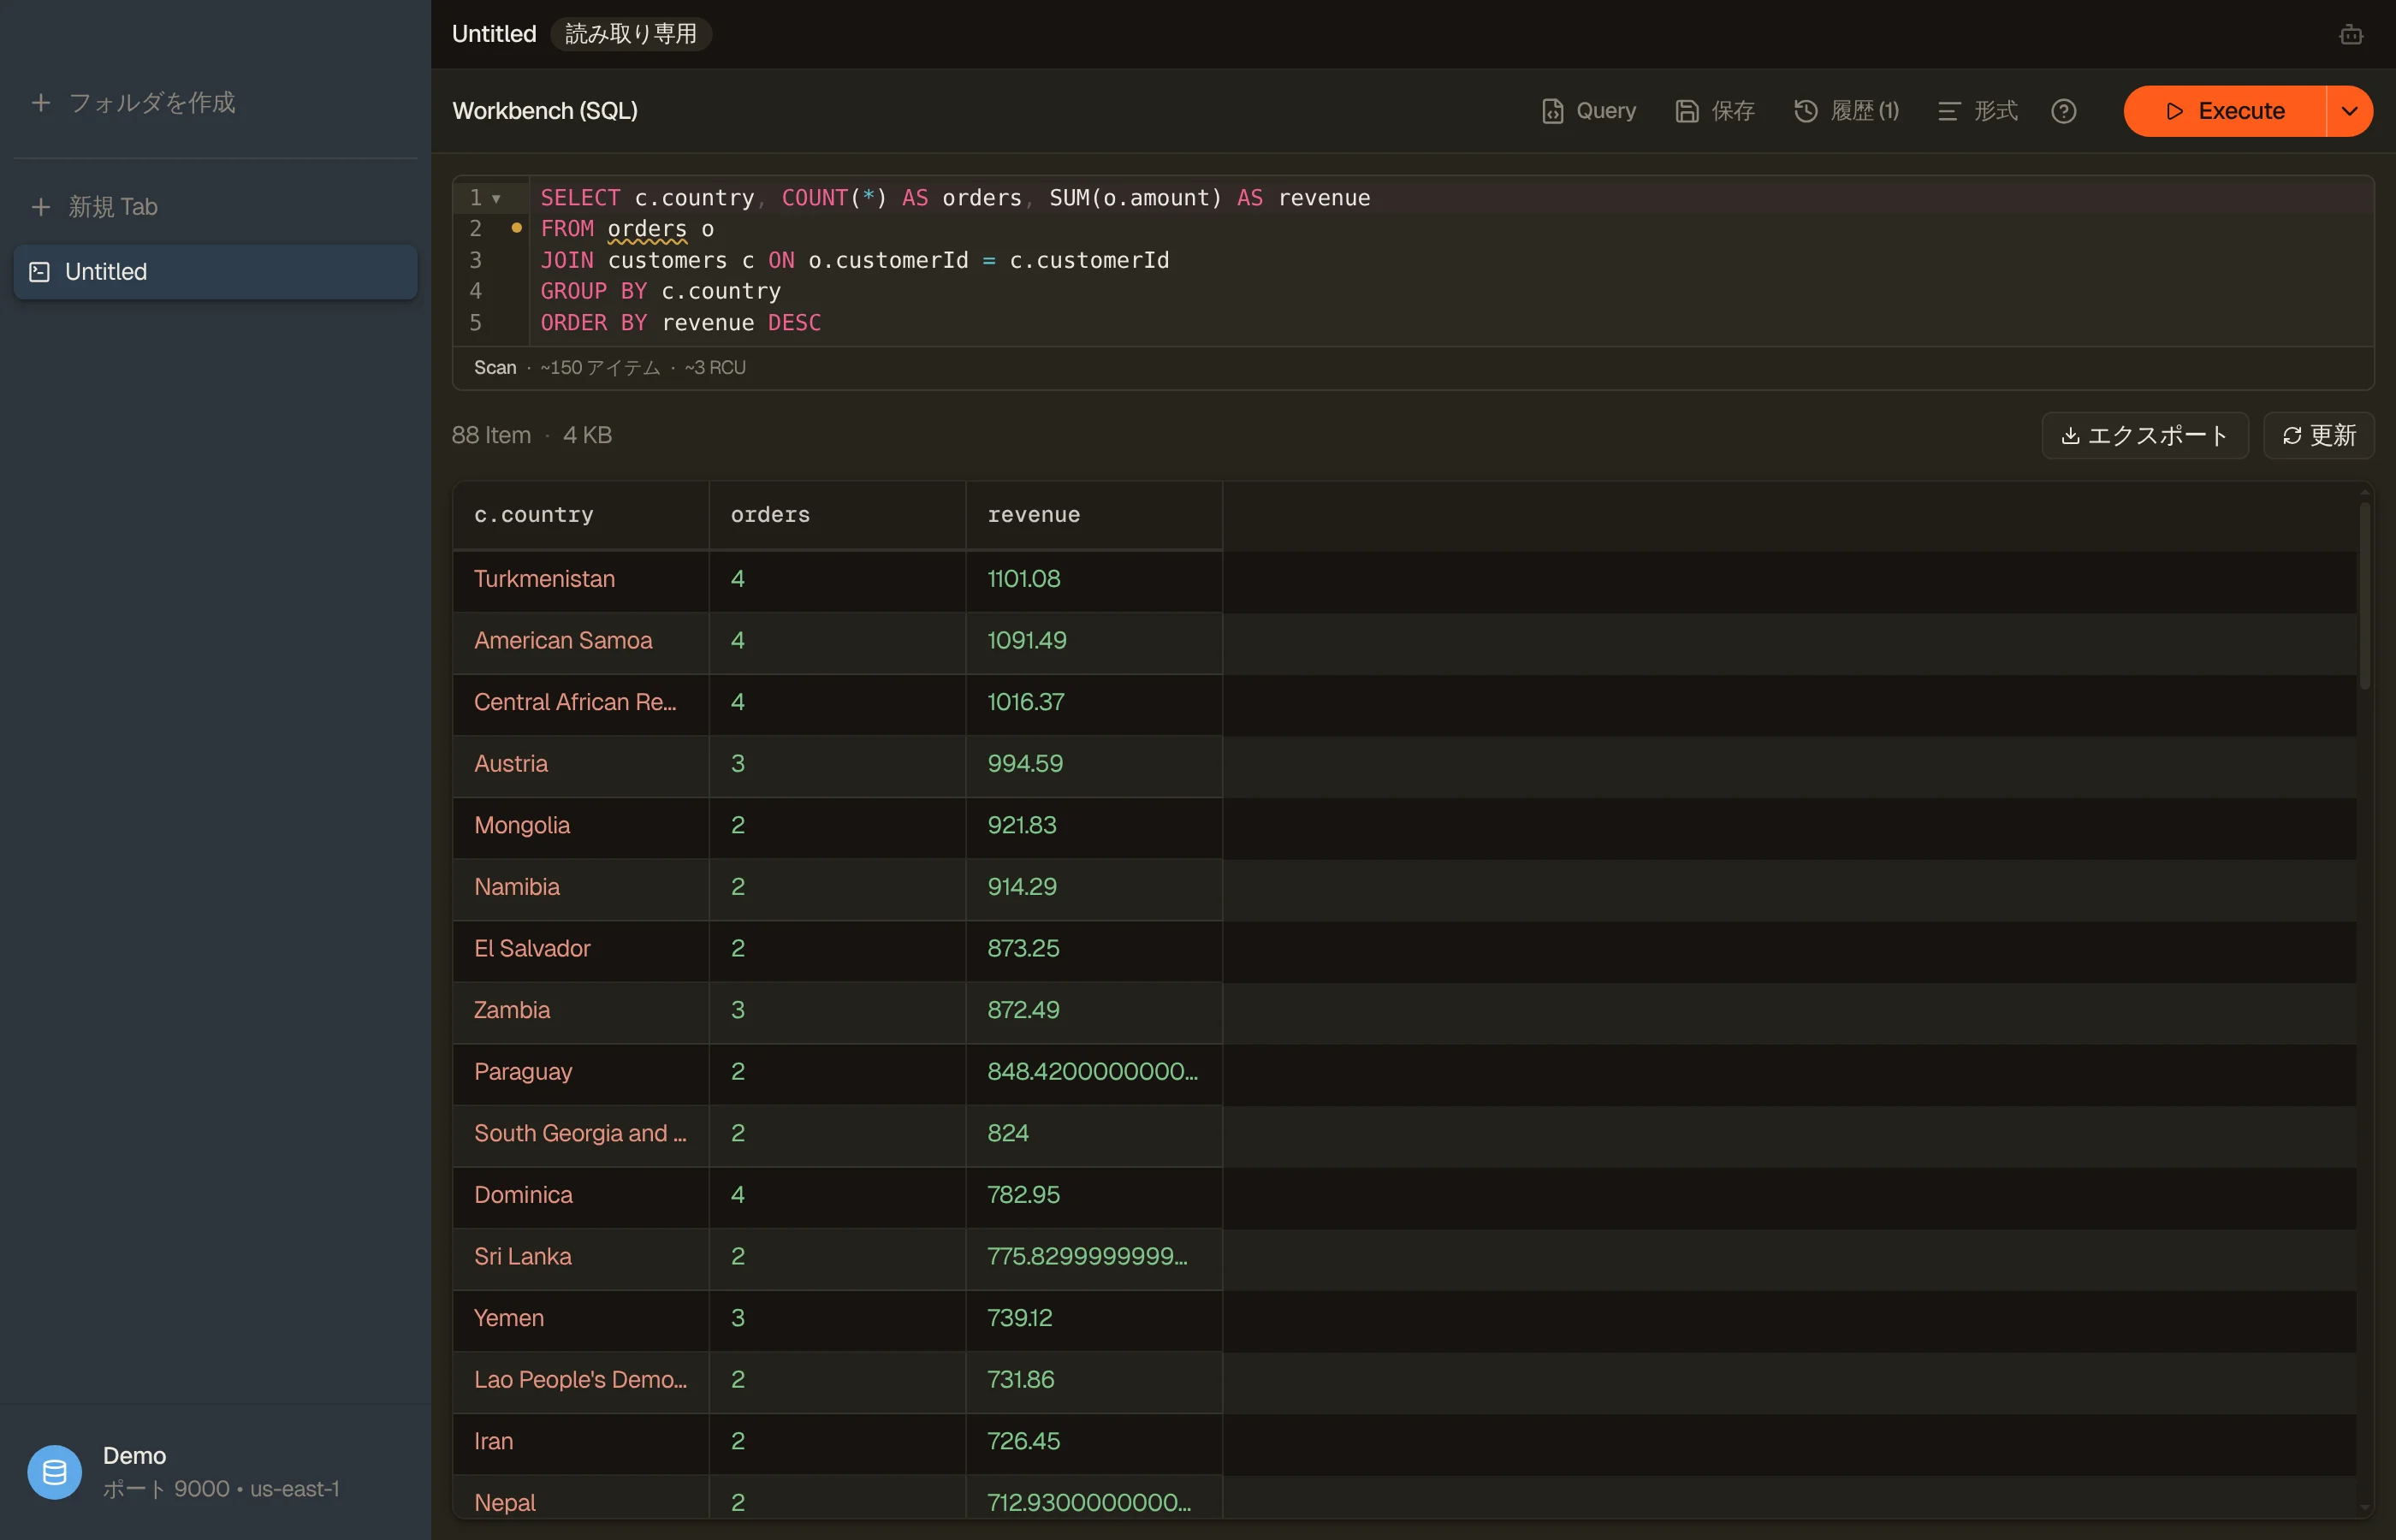
サポートする内容
次を含む単一の SELECT ステートメント:
JOIN ... ON ...— テーブルをまたぐINNERおよびLEFT結合。- 集計 —
COUNT、SUM、AVG、MIN、MAX、加えてGROUP BYとHAVING。 WHERE、DISTINCT、CASE、CAST、ORDER BY。
集計クエリがまだストリーミング中の間、partial バッジが該当する列に印を付けます — より多くのページが届くにつれて数値が精緻化されます。
アクセスパターンの規則
DynamoDB にはサーバーサイドの結合がありません。Workbench コンパイラは、
DynamoDB ができることを強制します: テーブルへの JOIN は、そのテーブルのパーティションキーまたは GSI パーティションキーに結合しなければならず、すべての検索が実際のクエリになり、行ごとの隠れたテーブル全体スキャンにはなりません。
OpenSearch インデックスへの JOIN は、ドキュメントの _id、または任意の
keyword・数値・日付・ブール値・IP フィールドに結合できます。テキストフィールドは
keyword サブフィールドを通してのみ結合できます。インデックスの指定方法とインデックスでの集計はOpenSearch SQL
で説明しています。
結合がキーでない属性を指している場合、エディタはそれに下線を引いて理由を説明します。コンパイラが拒否する他の構文も、同じく正確な検証の波線として現れます。 Workbench はクイックフィックスを提供しません:
RIGHT/FULL OUTER/CROSS結合とカンマ結合(INNER/LEFTのみ)。- サブクエリ、CTE(
WITH)、UNION/INTERSECT/EXCEPT。 - ウィンドウ関数(
OVER)、複数のステートメント、SELECT以外のすべて。
自己結合も同じルールで動きます。FROM employees e JOIN employees m ON e.managerId = m.employeeId
は、employees が employeeId でキー付けされていれば、各社員の上司を読み取ります。どの JOIN も、
ON は FROM テーブルの列の比較から始める必要があり、列をそれ自身と結合する(e.managerId = m.managerId)とフラグされます。
読み取り専用
Workbench は常に読み取り専用です。編集、ステージング、一括削除はありません — 分析用の画面です。クエリの実行がテーブルに書き込むことは決してありません。
識別子は標準 SQL の大文字小文字の扱いに従います: クォートされていない名前は大文字小文字を区別せずに一致します(WHERE PLATFORM は platform を見つけます)。大文字小文字を正確に一致させるには、名前をクォートまたはバッククォートで囲みます。
Preview the query cost
プランが得られる場合、プレビューは Scan と Query のどちらかと、使用するインデックスを示します。RCU の見積もりは、テーブルのメタデータが対応している場合にのみ表示されます。
このステータスバーは Workbench と PartiQL に表示され、ビジュアルなフィルタ行には表示されません。SQL が空、コンパイル失敗、DML、あるいは解析できない PartiQL にはプランがないため、コストバーは出ません。
通常のパーティション Query は「コストは一致したアイテム数に依存します」と表示し、
RCU は示しません。ポイントリードとサイズの分かる Scan も、裏付けとなる
DescribeTable のメタデータがなければ RCU は出ません。
ポイントリードでは「≈1 アイテム」は表示されます。アイテム数のある Scan はテーブルの見積もりを表示できますが、その RCU を計算するにはバイト単位のテーブルサイズが必要です。どちらの値もない場合、Scan は「サイズ不明」と表示します。
Scan の見積もりは、ライブの値ではなく、DynamoDB が定期的に更新するテーブルの数値を使います。ポイントリードの分岐は強力な整合性のある読み込みで、Scan の分岐は結果整合性のある読み込みで価格を計算します。
Workbench も PartiQL も、実行するのは結果整合性のある読み込みです。そのためポイントリードの見積もりは、実際のリクエストコストの 2 倍になることがあります。どの数値も、請求額ではなく実行前のヒントとして扱ってください。ざっと確かめるだけなら、料金計算ツールが us-east-1 のオンデマンド RCU の価格を出してくれます — パーティションクエリにファンアウトする結合でも、読み取る 4 KB のアイテムあたりおよそ 1 RCU が課金されます。
実行、テンプレート、履歴
- Execute — エディタで ⌘↩、Execute ボタン(最後まで実行を選んでいる間は すべて実行)、または再実行には ⌘R。 Workbench タブは開いたときに自動実行することはありません。実行は常に意図的です。
- 最後まで実行 — ⌘⇧↩、または Execute ボタンのメニューから 最後まで実行 を選び、表示が変わった すべて実行 をクリックします。1 ページではなく、結合された結果全体をストリーミングします。ページ上限が解除され、クエリが尽きるまでページが届き続けます。Stop だけが唯一のブレーキです。1 回のパスで完了させたい大きな集計に便利です。
- テンプレートと保存済みクエリ — Query メニューには、スターターテンプレート(全選択、キーでフィルター、グループで集計、Tab で移動できる箇所付き)に加え、保存 で保存したクエリ — 任意のテーブルで再利用できる、自分で名前を付けたクエリ — が並びます。選ぶとエディタの内容が置き換わるので、保存したままの状態で実行されます。
- 履歴 — すべての実行が保存され(PartiQLの履歴とは別に)、検索でき、復元できます — 失敗した実行も含まれるので、修正して再試行できます。
Workbench タブは保存された仕様です — 名前を付け、⌘K から再度開けば、再読み込みを経ても残ります。結合された結果をエクスポートすることもできます。
Workbench と Smart Table
どちらも同じ結合エンジンを実行します。同じものをオーサリングする 2 つの方法です:
- Workbench は SQL の経路 — クエリを入力し、集計と解決された属性を得ます。
- Smart Table は ビジュアルの経路 — キャンバスに結合を描画し、結合された行を通常のテーブルのように閲覧します。