テーブルの概要とインデックス作成
開いているすべてのテーブルには、Visual モードでも PartiQL モードでも、タブツールバーに 設定 ボタンがあります。これはそのテーブルの テーブル設定ダイアログを開き、テーブルの形状をひと目で確認でき、テーブルをインデックス化してオートコンプリートにフィールドを教え、推論したスキーマを TypeScript、Zod、 JSON Schema としてエクスポートできます。
ダイアログの左側のレールには 6 つのセクションがあります:
- 概要 — テーブルの構造と見積もり。下で説明します。
- インデックス — オートコンプリートを支えるローカルのフィールドインデックスと、スキーマのエクスポート。
- テーブルのインデックス — テーブルのグローバルおよびローカルセカンダリインデックス。ここで GSI を追加・削除できます。
- レプリカ — グローバルテーブルのリージョン。ここでレプリカを追加・削除できます。 DynamoDB Local のプロファイルでは表示されません。
- 設定 — TTL、キャパシティモード、削除保護。
- AI コンテキスト — AI がこのテーブルを扱うときに読むノート。
これらのうち 2 つのセクションは、どちらも「インデックス」と呼ばれる別々のものを管理しており、その違いは重要です。インデックス はフィールド名と値のローカルインデックスを構築し、これは Team Workspace への公開をあなたが選ばない限りマシンに留まります。一方テーブルのインデックス は、あなたのアカウントに実際の DynamoDB GSI を作成・削除します。

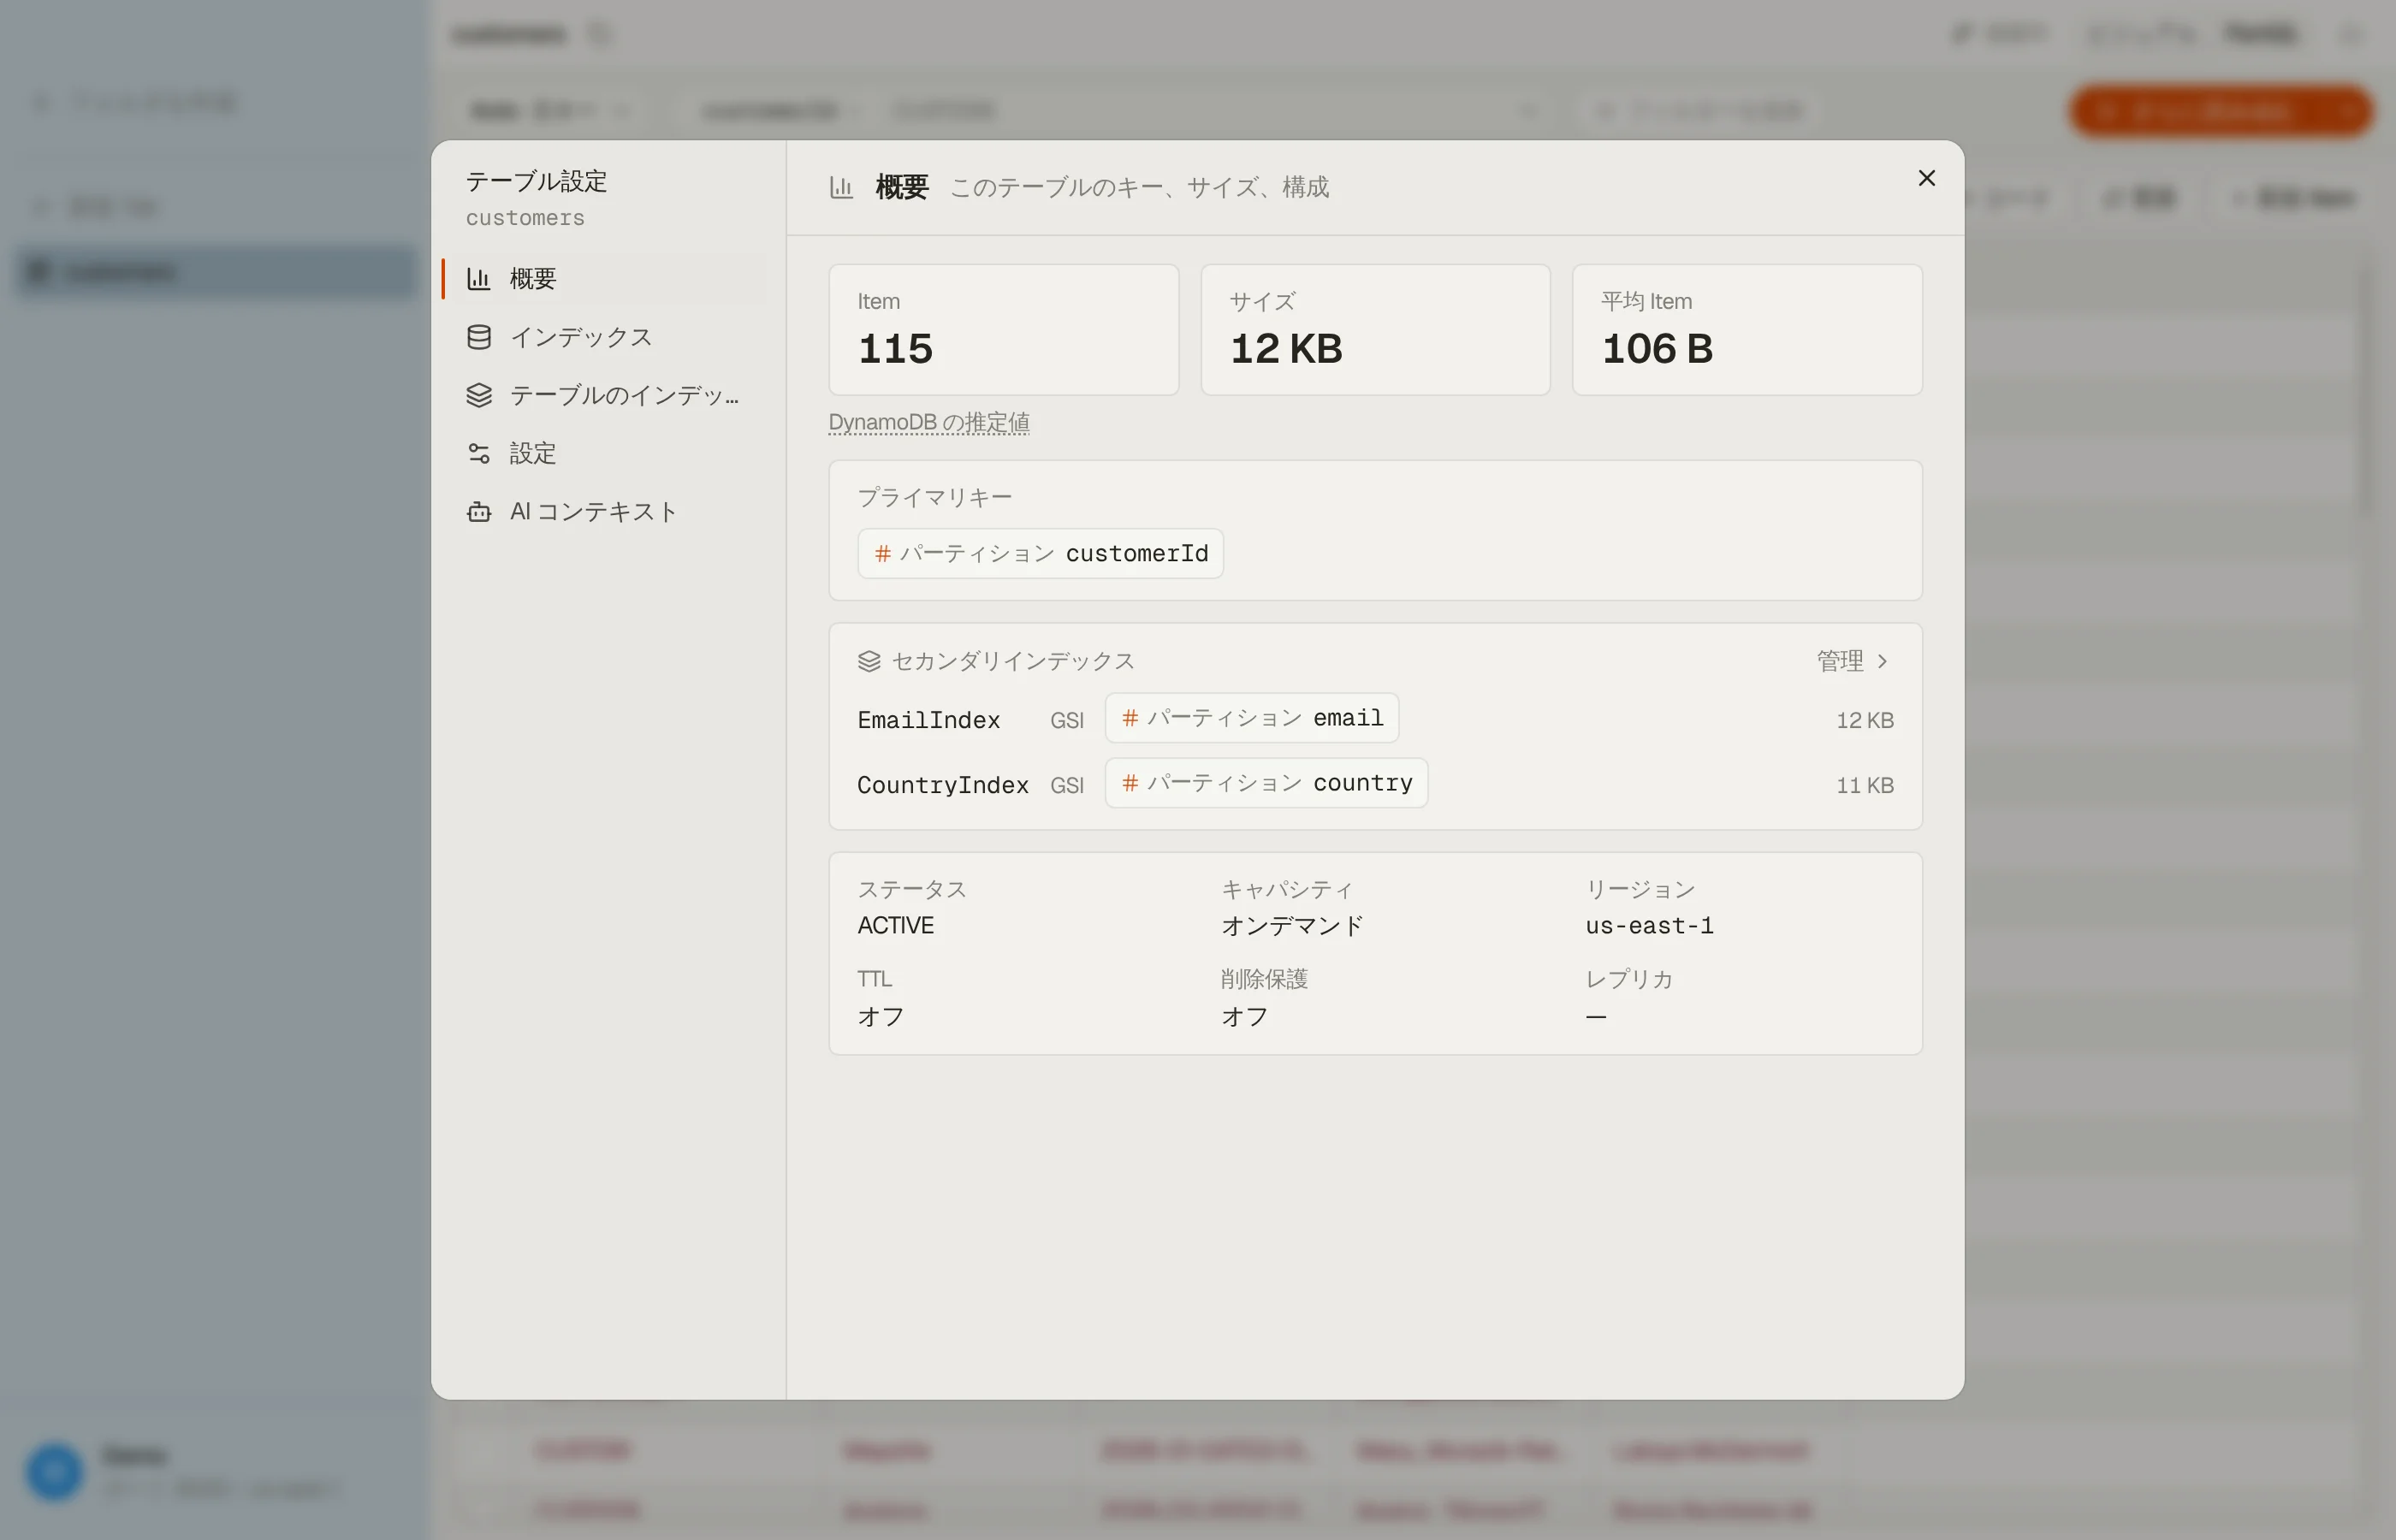

概要
概要セクションにはテーブルの構造がレイアウトされています:
- プライマリキー — パーティションキー、そしてテーブルにソートキーがあればそれも表示されます。
- セカンダリインデックス — 各グローバルまたはローカルセカンダリインデックスとそのキー。多くのインデックスを持つテーブルでもコンパクトなまま — 一覧はその場でスクロールします。管理 をクリックするとテーブルのインデックスセクションが開きます。
- Status · Capacity · Region · TTL · Deletion protection · Replicas — テーブルの現在の構成です。グローバルテーブルでは、レプリカ にすべてのレプリカのリージョンがホームリージョンから順に表示されます。キャパシティ、TTL、削除保護の変更は設定セクションから行います。
- Items · Size · Avg item — DynamoDB 自身の見積もりです。おおよそ 6 時間ごとに更新されるため、正確な数ではなく概算値として扱ってください。DynamoDB の推定値にホバーすると注意書きが表示されます。サンプルのアイテムをアイテムサイズ計算ツールに貼り付ければ、正確なバイト数と、us-east-1 のオンデマンドで読み取りが何 RCU を消費するかが分かります。
Indexing your table
これはダイアログの インデックス セクションです — ローカルのフィールドインデックスであって、DynamoDB のセカンダリインデックスではありません。
インデックス化されたフィールドがないと、Workbench と PartiQL のクエリエディタはフィールドや値の候補を出しません。キーワード、関数、演算子の補完は引き続き機能します。
インデックスは次の機能にデータを供給します:
- クエリエディタ: Workbench と PartiQL のフィールド・値の候補、および Workbench の未知の列のチェック。
- アイテムエディタ: キー以外のフィールド名の候補と、すべての値の候補はインデックスのデータから来ます。
PK、SK、GSI、LSIのキー名はテーブル定義に由来し、インデックスは不要です。 - ビジュアルなテーブルツール: 列セレクタ、ビジュアルなクエリ・スキャンのフィルター、Smart Table のノード、リレーションシップの属性ピッカー。
- AI: アクティブなテーブルの
@columnの候補、スキーマツール、両方のクエリエディタでのゴーストテキストとインライン編集へのスキーマヒント、そして結合された Smart Table の列の正規化。 - 統計と共有: インデックス済みフィールド の一覧、推論スキーマのエクスポート、そして Team Workspace へのインデックスの公開。
インデックスによる補完と AI のゴーストテキストは別物です。Workbench と PartiQL のインデックス候補にゲートはありません。AI のゴーストテキストは既定でオフで、有効なライセンスが必要です。
アイテムエディタでは、DynamoDB JSON モードのときインデックスによる値の補完は抑制されます。フィールド名の補完はそこでも機能します。
インデックスができる、または大きくなる経路は 5 つあります:
- 手動スキャン: テーブルを Index 化 は既定で最大 10,000 アイテムをスキャンします。再インデックス は現在のインデックスをクリアしてから、同じ上限までスキャンします。幅の広いテーブルやロングテールのテーブルでは、上限を超えて初めて現れる属性は欠けたままになります。
- 取得したページ: テーブルのページを取得すると、DynoTable はインデックスをクリアせずにそれらのアイテムを追加します。
- Smart Table: 最初に取得したページがインデックスの起点になります。
- Team Workspace: チームメイトが公開したインデックスは、ローカルでのスキャンなしにインポートできます。インポートが何を置き換えるかは Team Workspaceを参照してください。
- AI による起動: スキーマが見つからないとき、AI は回答の前にベストエフォートで約 100 アイテムのインデックスを作ります。既存のインデックスには追加されます。
手動スキャンは進捗をライブで表示し、DynamoDB の読み取りを消費します。インデックス化の後、インデックス済みフィールド には見つかった属性が、commonData.status のようなドット区切りのネストしたパスも含めて一覧表示されます。
各フィールドには、観測された型と、サンプリングしたアイテム全体で 必須 だったか任意 だったかが表示されます。フィールドがいくつかを超えると、素早く見つけられるようフィルターボックスが表示されます。Index を消去 はローカルのインデックスを削除します。
スキーマのエクスポート
インデックス化されたテーブルから、エクスポート を開いて形式を選ぶと、アイテムを型付きのスキーマに変換できます:
- TypeScript —
interface。 - Zod —
z.object(...)スキーマ(Standard-Schema 互換)。 - JSON Schema — draft 2020-12。
クリップボードにコピーするか、ファイルに保存します。すべてのエクスポートは、それが サンプリングしたアイテムから推論された ものだという注記とともに開始されます — 有力な出発点であって、権威ある契約ではありません。任意かどうかは、インデックス化の際に各属性がどれくらいの頻度で出現したかを反映します。プライマリキー属性は常に必須としてマークされます。
これはあなたのデータの 形状 のスキーマであり — データそのもののエクスポートとは別物です。