ドキュメントの一括編集、エクスポート、インポート
テーブル向けの機能はインデックスでも使えます: 一括編集と一括削除、比較、エクスポート、インポート。このページでは、インデックスで変わる点を扱います。ダイアログそのものは DynamoDB のページで説明しています。
一括編集と一括削除
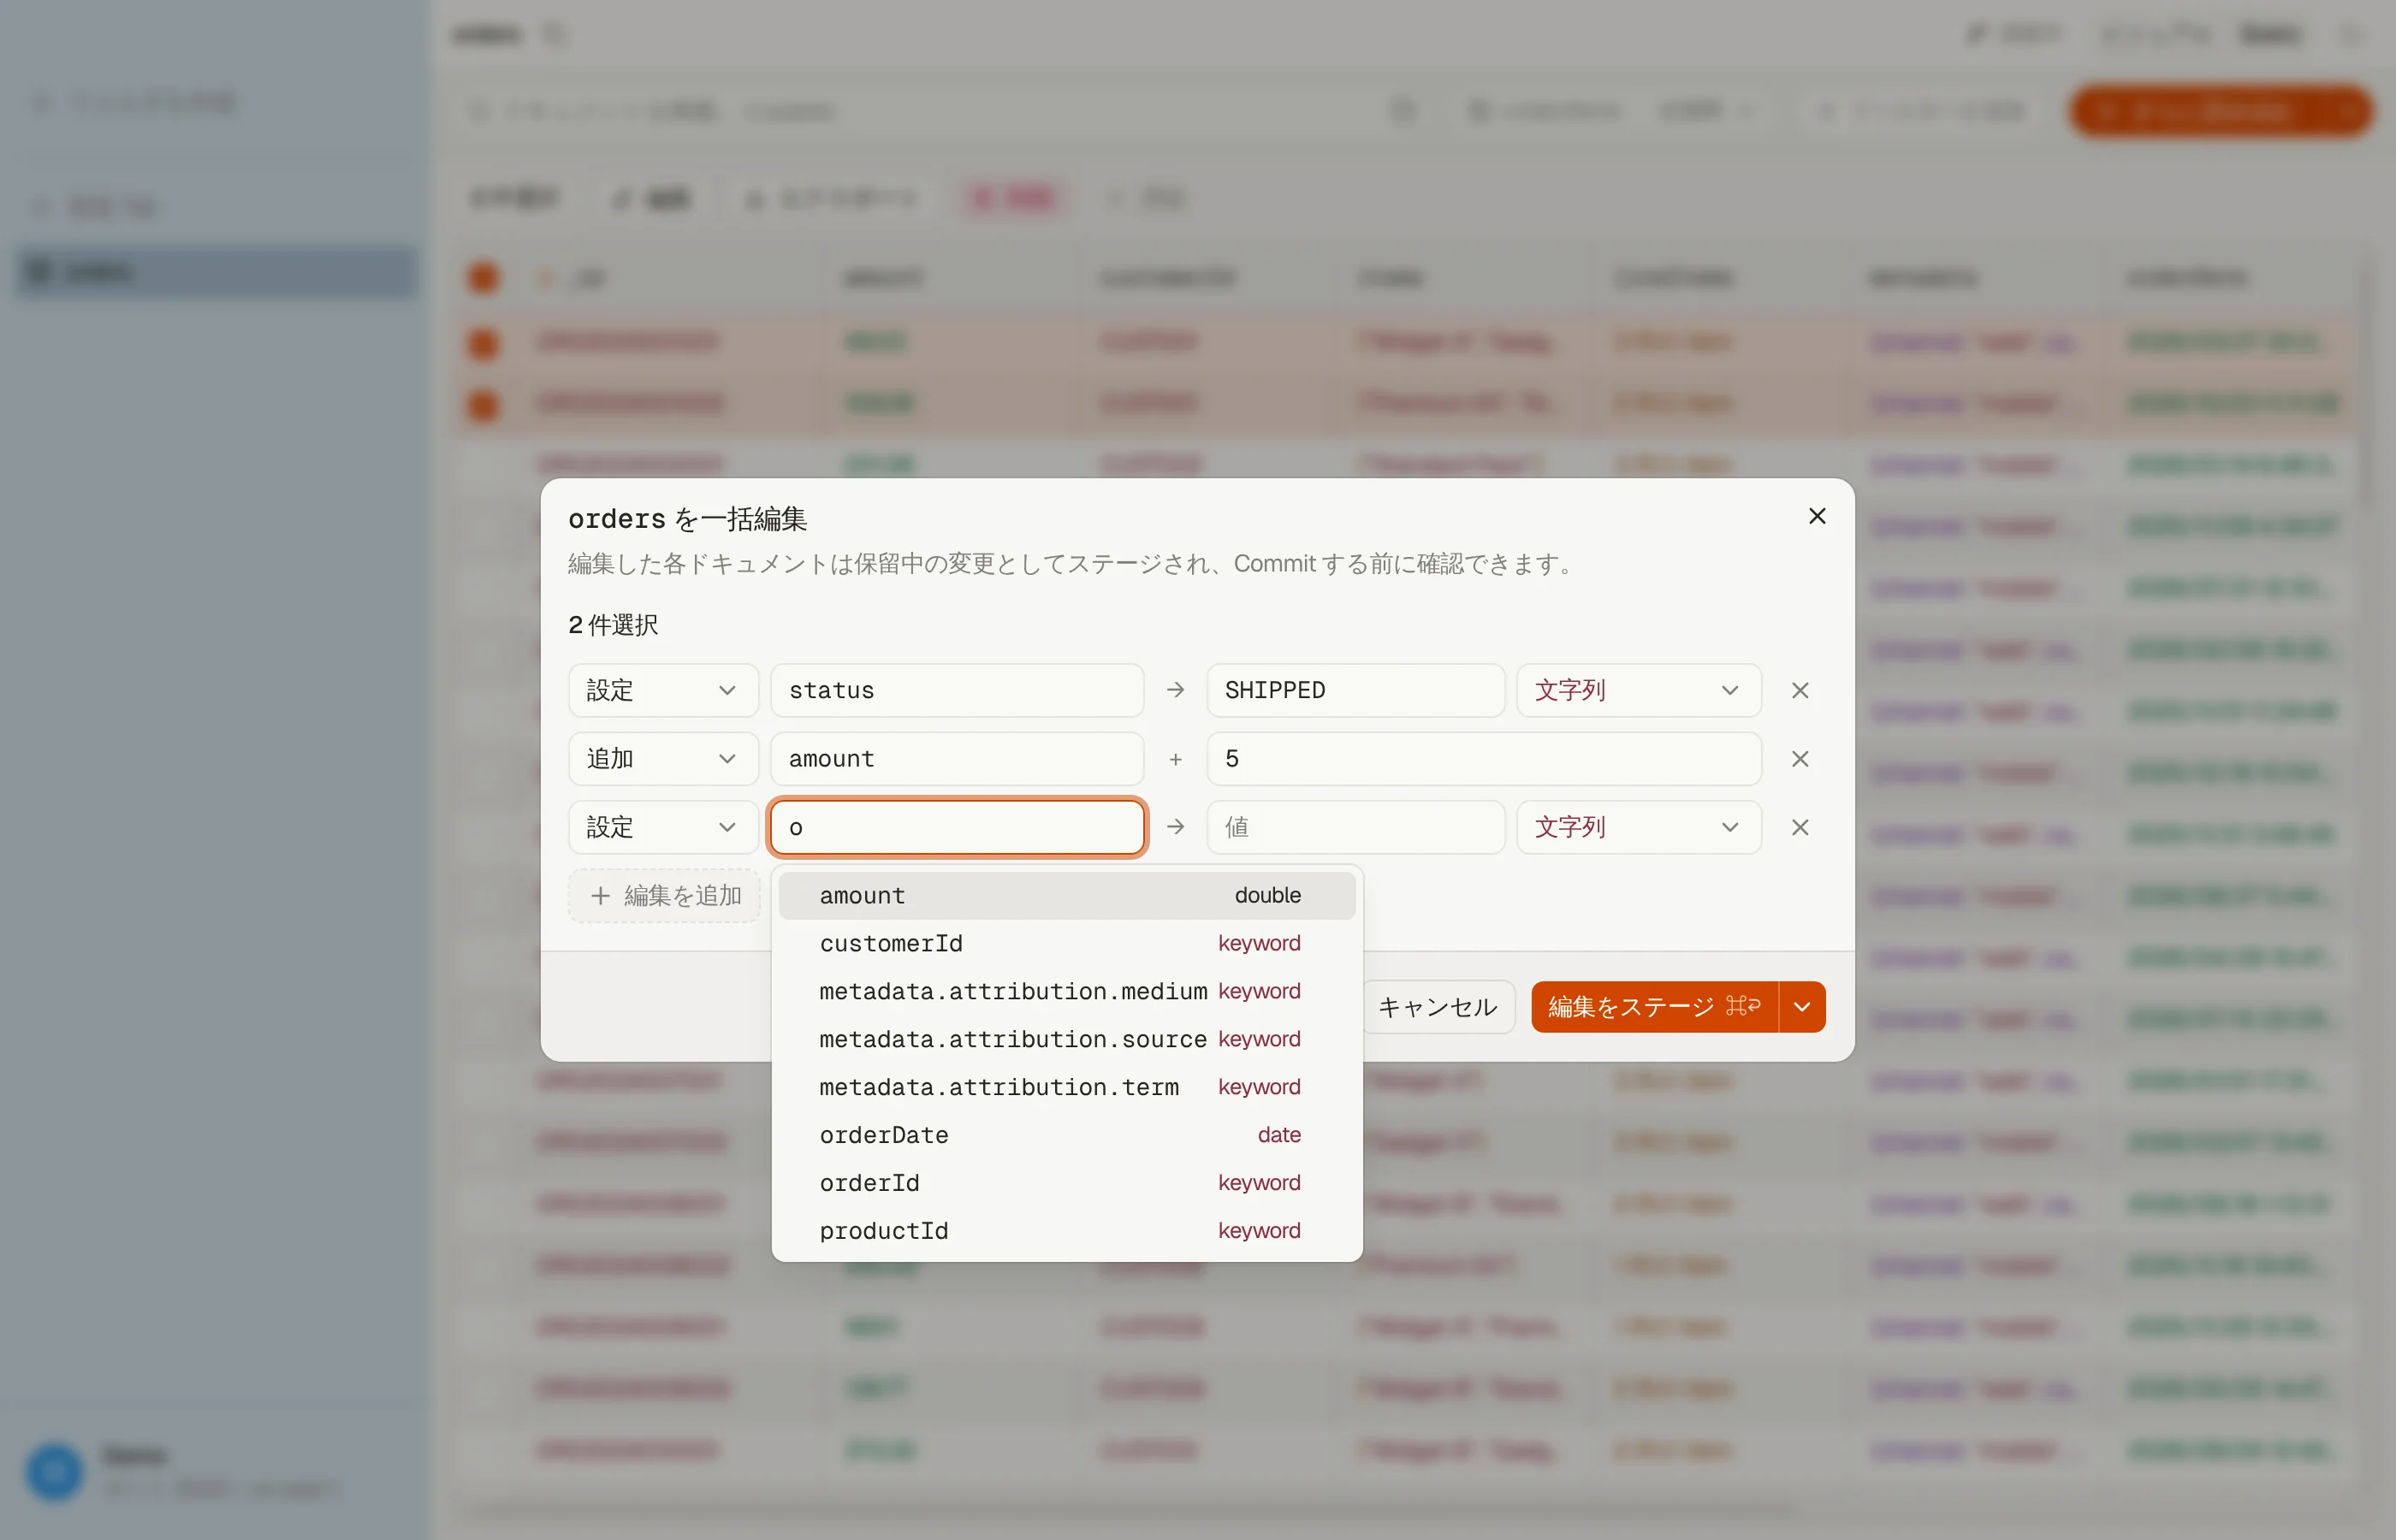
行を選ぶか、⌘A で検索に一致するすべてのドキュメントを選び、 ⌘E で編集、⌘⌫ で削除します。編集のダイアログには設定、削除、追加があり、フィールドのピッカーはどれもインデックスのマッピングを読み取ります:
- 追加には数値フィールドだけが表示されます。
- 値は、何かを実行する前にフィールドのマッピング型と照合されます。
integerには大きすぎる数値、longへの小数、形式の違う日付は、理由とともにダイアログを止めます。 _sourceが無効またはフィルターされたインデックスは、書き直したドキュメントがフィールドを失うため、編集を拒否します。削除は実行できます。
ステージと Commit はテーブルと同じように動きます: 最大 10,000 件のドキュメントを、保留中の変更で確認し、履歴から元に戻せます。各ドキュメントは読み直されて丸ごとステージされ、マネージドドメインでは読み取ったときのバージョンが付きます。
一括編集はインデックス自体に対して実行します。エイリアスのタブや、* を含むインデックスパターンは一括編集できません。


直接実行
一致するすべての選択では、編集を直接書き込むと直接削除も選べます: 上限なし、保留中の変更なし、元に戻す手段なしです。書き込み方はターゲットによって異なり、DynoTable が自動で選びます:
- マネージドドメインまたはセルフホストのエンドポイントでは、サーバーが実行します。 DynoTable は update-by-query または delete-by-query のタスクを開始し、その進行を追います。最大書き込み数/秒はタスクの流量制限になります。 DynoTable を終了してもタスクは動き続け、次に起動したときに再開でまた見つかります。停止はタスクをキャンセルします。プロファイルにはタスクを読み取ってキャンセルする権限が必要で、それがなければ実行は開始前に拒否されます。
- Serverless コレクションでは、DynoTable が各ドキュメントを書き込みます。コレクションには update-by-query がないため、DynoTable は一致するドキュメントを読み取り、バッチで書き戻します。この書き込みは最終書き込み優先です。その間に行われた変更は失われ、削除は実行中に一致しなくなったドキュメントも削除します。確認のステップでそう伝えます。
インデックスには Safe と Fast の選択はありません。1 つのインデックスで動ける直接実行は、このマシン上のどのプロファイルからでも同時に 1 つだけです。
2 つのドキュメントを比較する
2 行を選んで ⌘⇧C を押します。DynoTable は両方のドキュメントを読み直し、異なるフィールドを一覧します。A にコピーまたは B にコピーで相手側の値を取り込み、N 件の変更を A にステージ(または B)でそれらを 1 つの保留中の変更としてステージします。
エクスポート
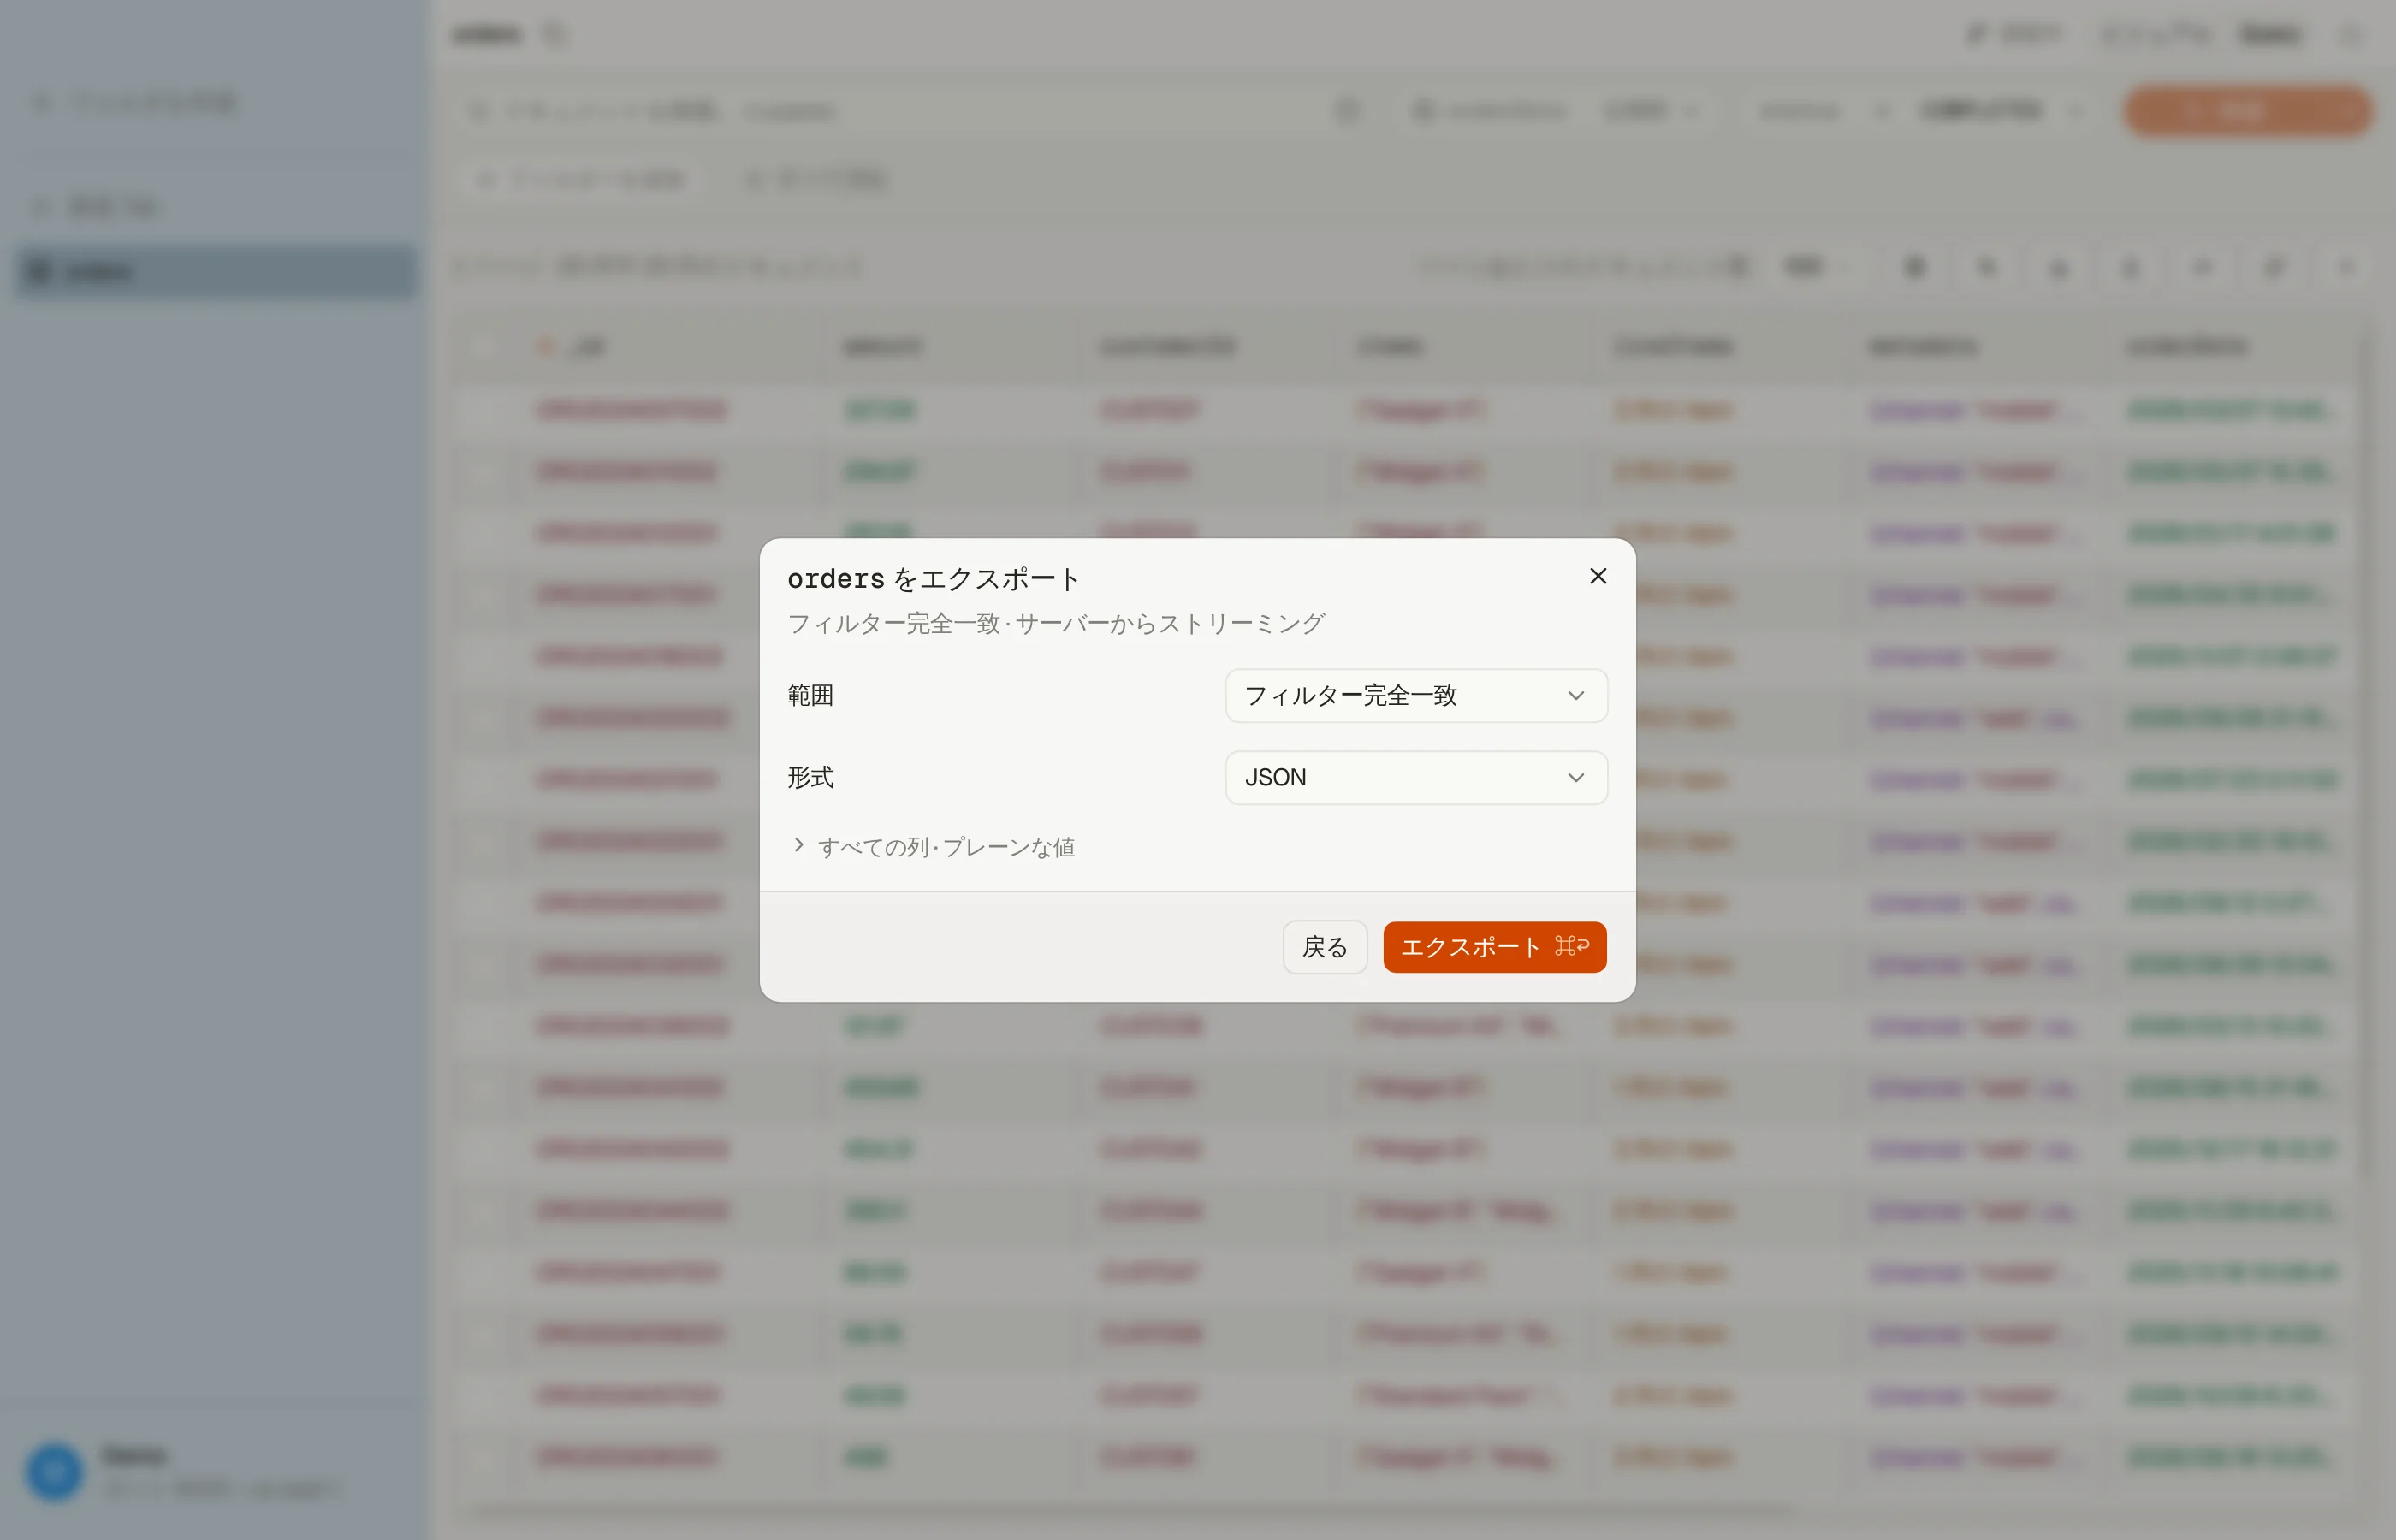
エクスポート(⌘⇧E)は CSV、JSON、NDJSON をファイルまたはクリップボードに書き出します。範囲は同じく現在読み込み済み、選択範囲、フィルター完全一致です:
- 各ドキュメントは
_id付きで書き出されるので、エクスポートしたファイルは同じドキュメントの上にインポートし直せます。 - フィルター完全一致は、実行した検索に一致するすべてのドキュメントを読み取り、総数が先にわかるため N of M の進捗を表示します。
- ドキュメントはグリッドの並び順ではなく、インデックスの順で出力されます。
インデックスでエクスポートできないもの: S3(エクスポート先がグレー表示になります)と、DynamoDB-JSON の値です。ドキュメントには型のラッパーがないからです。


インポート
インデックスのツールバーのインポートは、CSV、JSON、NDJSON のファイルをインデックスに読み込みます。プレビュー、ファイル全体の確認、アクティビティの行はテーブルへのインポートと同じです:
_id列がドキュメントの id です。 その id のドキュメントは上書きされます。_id列がなければ、OpenSearch が id を生成します。- 型はマッピングが決めます。 数値やブール値のフィールドに入るテキストは、数値やブール値になります。マッピングが拒否する値は確認の段階で報告され、ファイル全体が通るまで何も書き込まれません。
_routing列は、各ドキュメントのルーティングとして使われます。
インポートは直接書き込み、履歴に記録されないため、元に戻せません。エイリアスは対象にできないので、インデックス自体を開いてください。Serverless の時系列またはベクトル検索コレクションは _id 列を含むファイルを拒否し、どのコレクションでもダイアログが、書き込みは最終書き込み優先だと警告します。