AWS DynamoDB コンソールの代替
日々のクエリと編集では、DynoTable のようなデスクトップクライアントが AWS DynamoDB コンソールの主な代替です。テーブルの復元、ストリームの設定、単発の確認はコンソールで行います。コンソールが提供するのは、テーブル一覧、アイテムブラウザ、そして PartiQL エディタです。
DynoTable が加えるのは、DynamoDB のアクセスパターンのルール内で JOIN、GROUP BY、集計を実行する SQL Workbench、あなた自身の AWS Bedrock キーで動く AI エージェント、そして Claude Code や Cursor のようなコーディングエージェントのための MCP アクセスです。
さらに、コンソールがついに備えなかったワークフローもあります。タブ、フォルダ、保存クエリ、キー 1 つのプロファイル切り替え、そして結果全体の CSV、JSON、NDJSON エクスポートです。 DynoTable は標準の AWS 認証情報チェーンを読み、アカウント内の同じテーブルと通信するので、移行するものはありません。
AWS コンソールを使う場面と DynoTable を使う場面
| あなたのワークフロー | 選ぶもの |
|---|---|
| テーブルの復元、ストリームの設定 | AWS コンソール |
アイテムを数件のぞく、単発の GetItem を実行する | AWS コンソール |
| テーブルの作成、GSI やレプリカの追加、キャパシティの調整、TTL の切り替え | どちらでも |
| オンデマンドバックアップの作成・削除、PITR のリカバリ期間の設定 | どちらでも |
稼働中のテーブルに対する JOIN、GROUP BY、集計を日常的に行う | DynoTable |
| 絞り込んだ結果セット全体を CSV、JSON、NDJSON にエクスポートする | DynoTable |
| ステージングされた書き込み、保存済みクエリ、Claude Code / Cursor 向け MCP | DynoTable |
DynoTable はオンデマンドバックアップの作成・削除とポイントインタイムリカバリの管理ができますが、復元、ストリーム、CloudWatch のアラームはコンソールに残ります。
Free プランでできることと、シートで加わること
まず、無料のままの部分から始めましょう。DynoTable の Free プランには期限がなく、必要なのは無料の DynoTable アカウントだけです。テーブルの閲覧とフィルタ、PartiQL の
SELECT、アプリからのデータ・コード・スキーマのエクスポート、そして MCP 経由でのコーディングエージェントへのスキーマとアイテムの読み取りの提供ができます。読み取りとアプリ内のエクスポートに関しては、どちらのツールも費用はかかりません。
サブスクリプションで加わるのは、SQL Workbench(JOIN、GROUP BY、
COUNT/SUM/AVG。PartiQL はどれもサポートしません)、Smart Table、テーブルを対象に動く AI エージェント、そしてステージかコミットかを選べる編集です。
そして、あなたの時間があります。コンソールには保存クエリのライブラリがないので、昨日のフィルタは手で作り直すことになります。DynoTable は結果セット全体をエクスポートし、ページ送りを肩代わりし、クエリを保存したままにします。DynamoDB が日々の仕事の一部なら、その雑用はサブスクリプションより高くつきます。たまに値を確認するためだけにコンソールを開くのなら、コンソールのままでいてください。
コンソールで SQL を使って DynamoDB をクエリできる?
PartiQL が公開する SQL 風のサブセットだけです。コンソールには PartiQL 文を実行する組み込みの PartiQL エディタ(左のナビゲーションペイン内)があり(AWS ドキュメント)、
PartiQL の SELECT 文法は意図的に狭くなっています。
SELECT expression [, ...]
FROM table[.index]
[ WHERE condition ]
[ ORDER BY key [DESC|ASC], ... ](AWS ドキュメント。)
1 つのテーブル、任意の WHERE、任意の順序付けで、JOIN も GROUP BY もありません。
AWS が集計関数の欄に挙げる唯一の関数 SIZE は、行をまたいだ値ではなく 1 つの属性のバイト単位のサイズを返します。一覧には "any SQL functions that are not included in
this list are not currently supported"(このリストに含まれない SQL 関数は現在サポートされていない)と注記されています(AWS ドキュメント)。それは DynamoDB の単一テーブルのアクセスモデルを忠実に表面化しますが、分析的な質問はコンソールでは論外だということを意味します。
PartiQL vs SQL ガイドが文法がどこで止まるかを正確に説明し、
PartiQL の例ガイドには、できる ことのコピペ文があります。
DynoTable の SQL Workbench は、INNER/LEFT JOIN、GROUP BY、COUNT、SUM
などの集計を、クライアント上で DynamoDB 自身の Query と Scan 操作にコンパイルします。あなたはリレーショナルな形の SQL を書き、DynoTable がそれをあなたのキーと
GSI に対してプランニングするので、DynamoDB のアクセスパターンのルール内に 留まります。

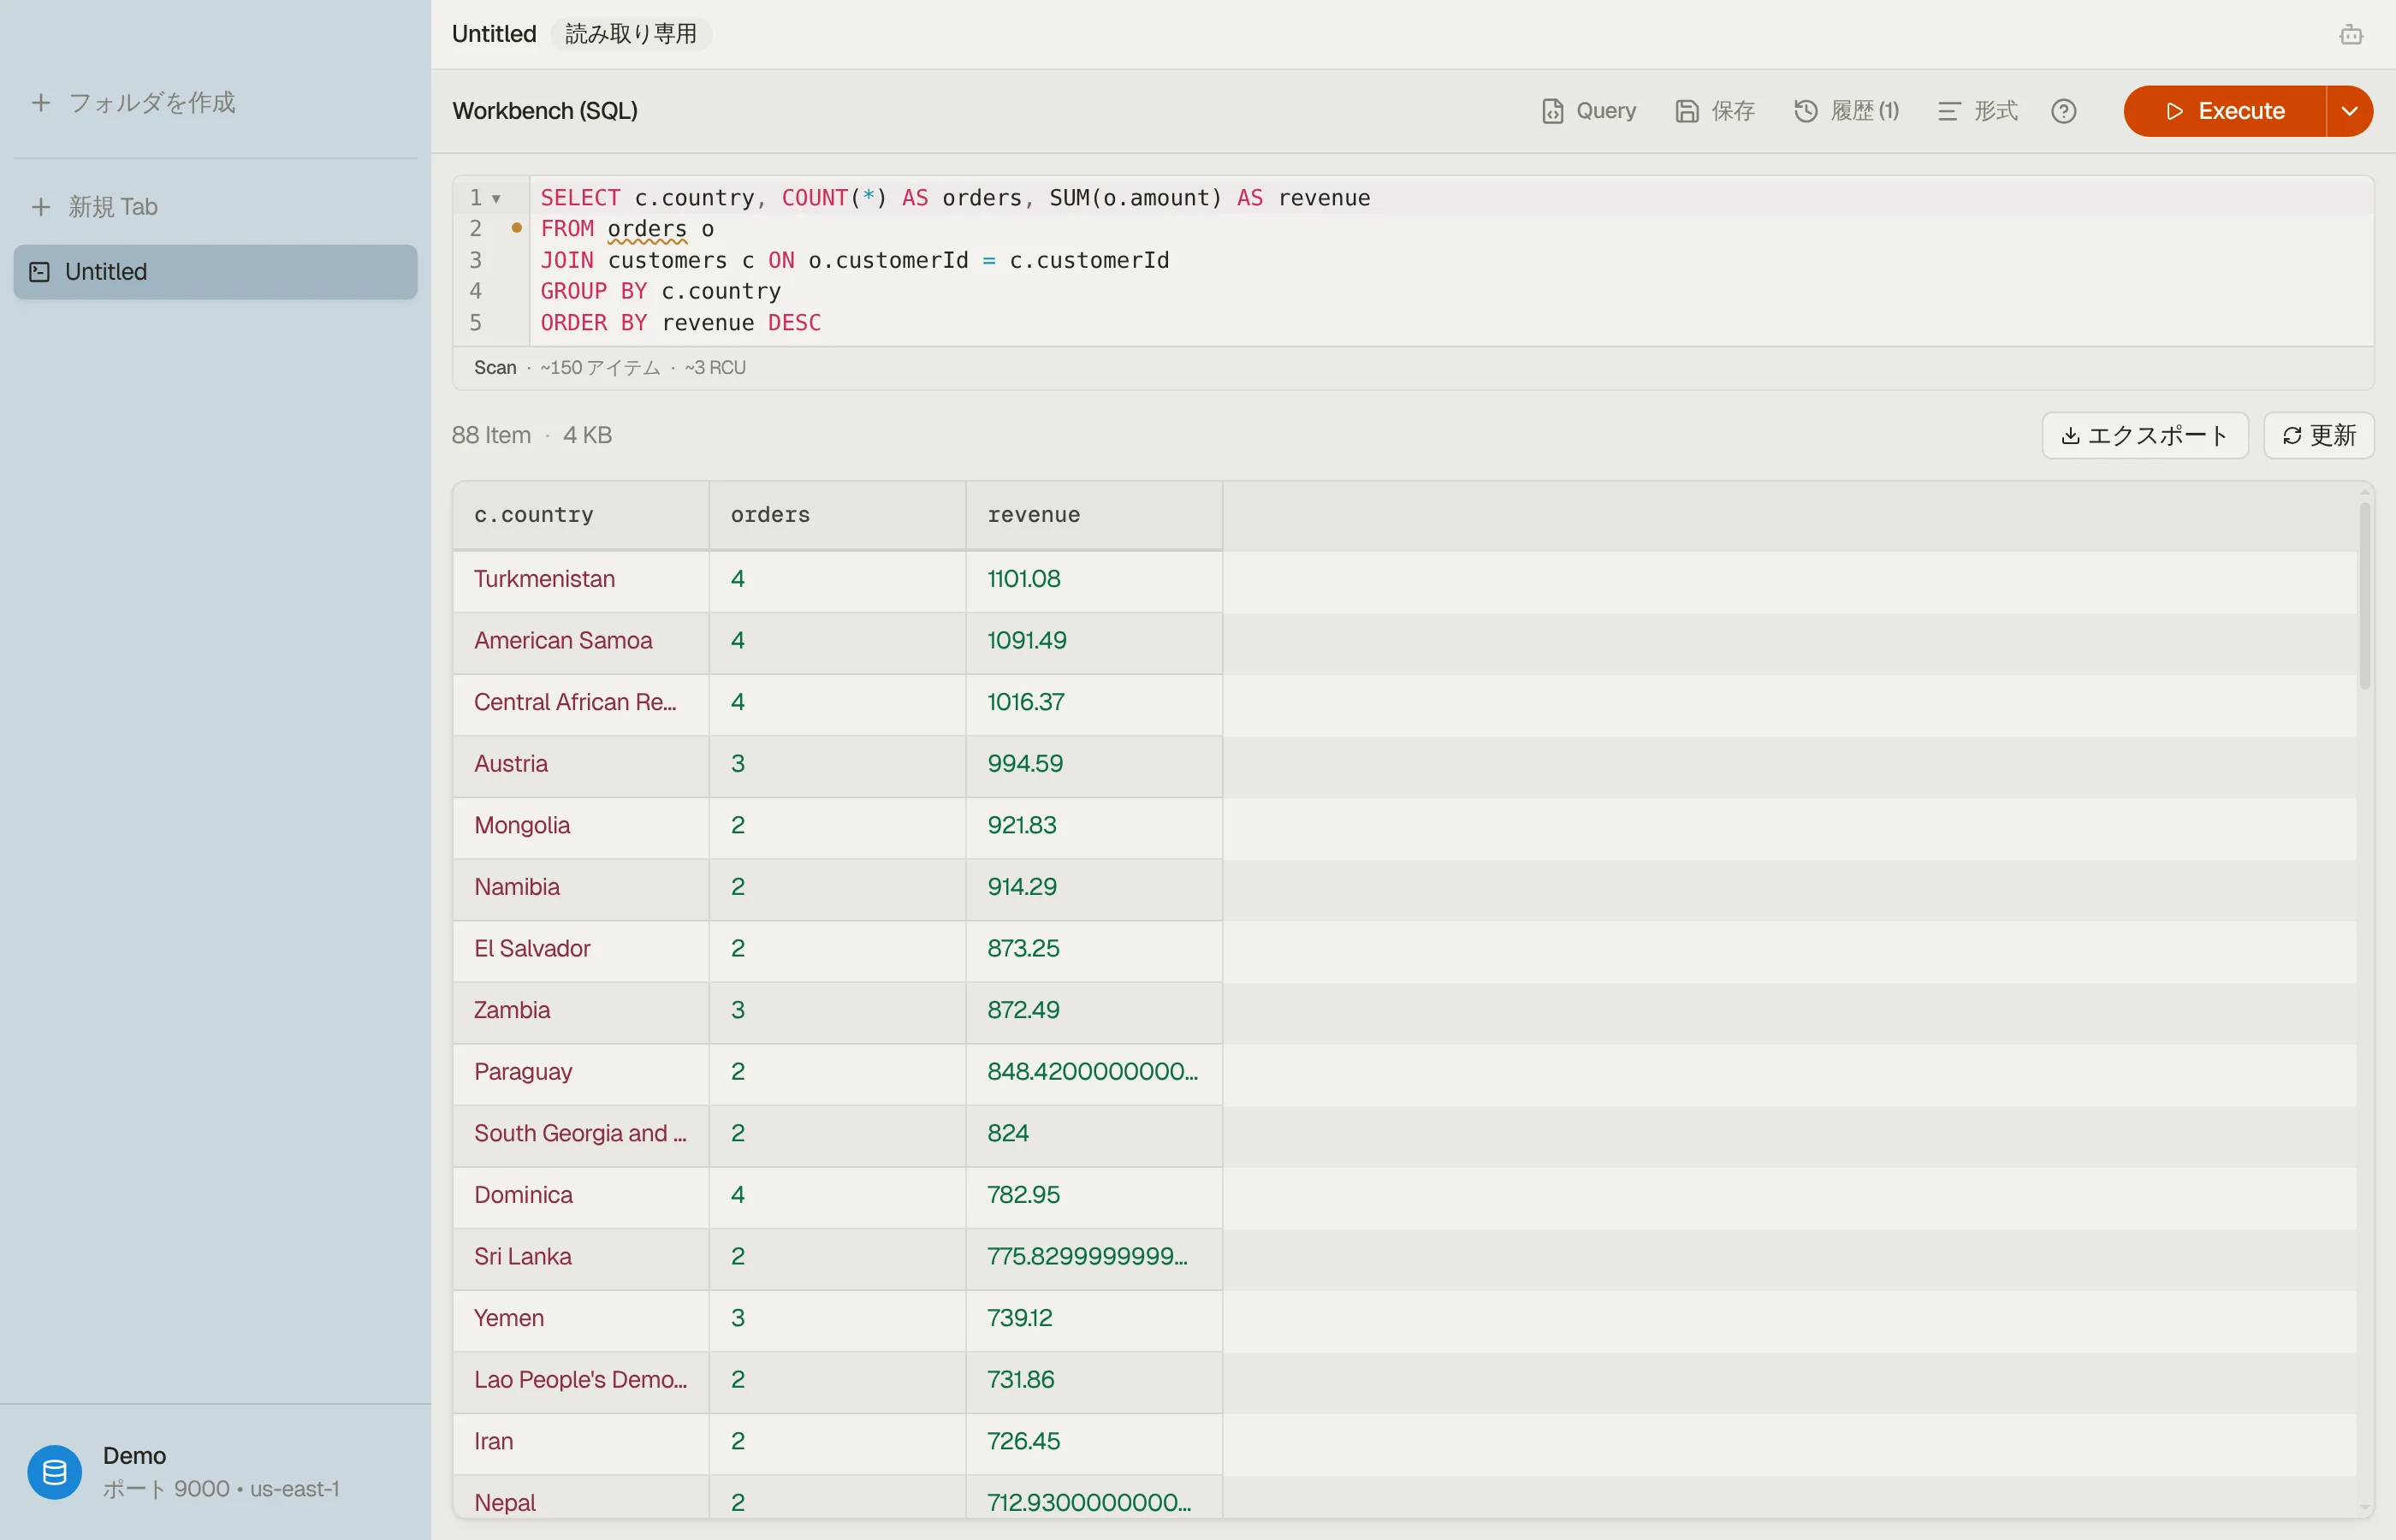

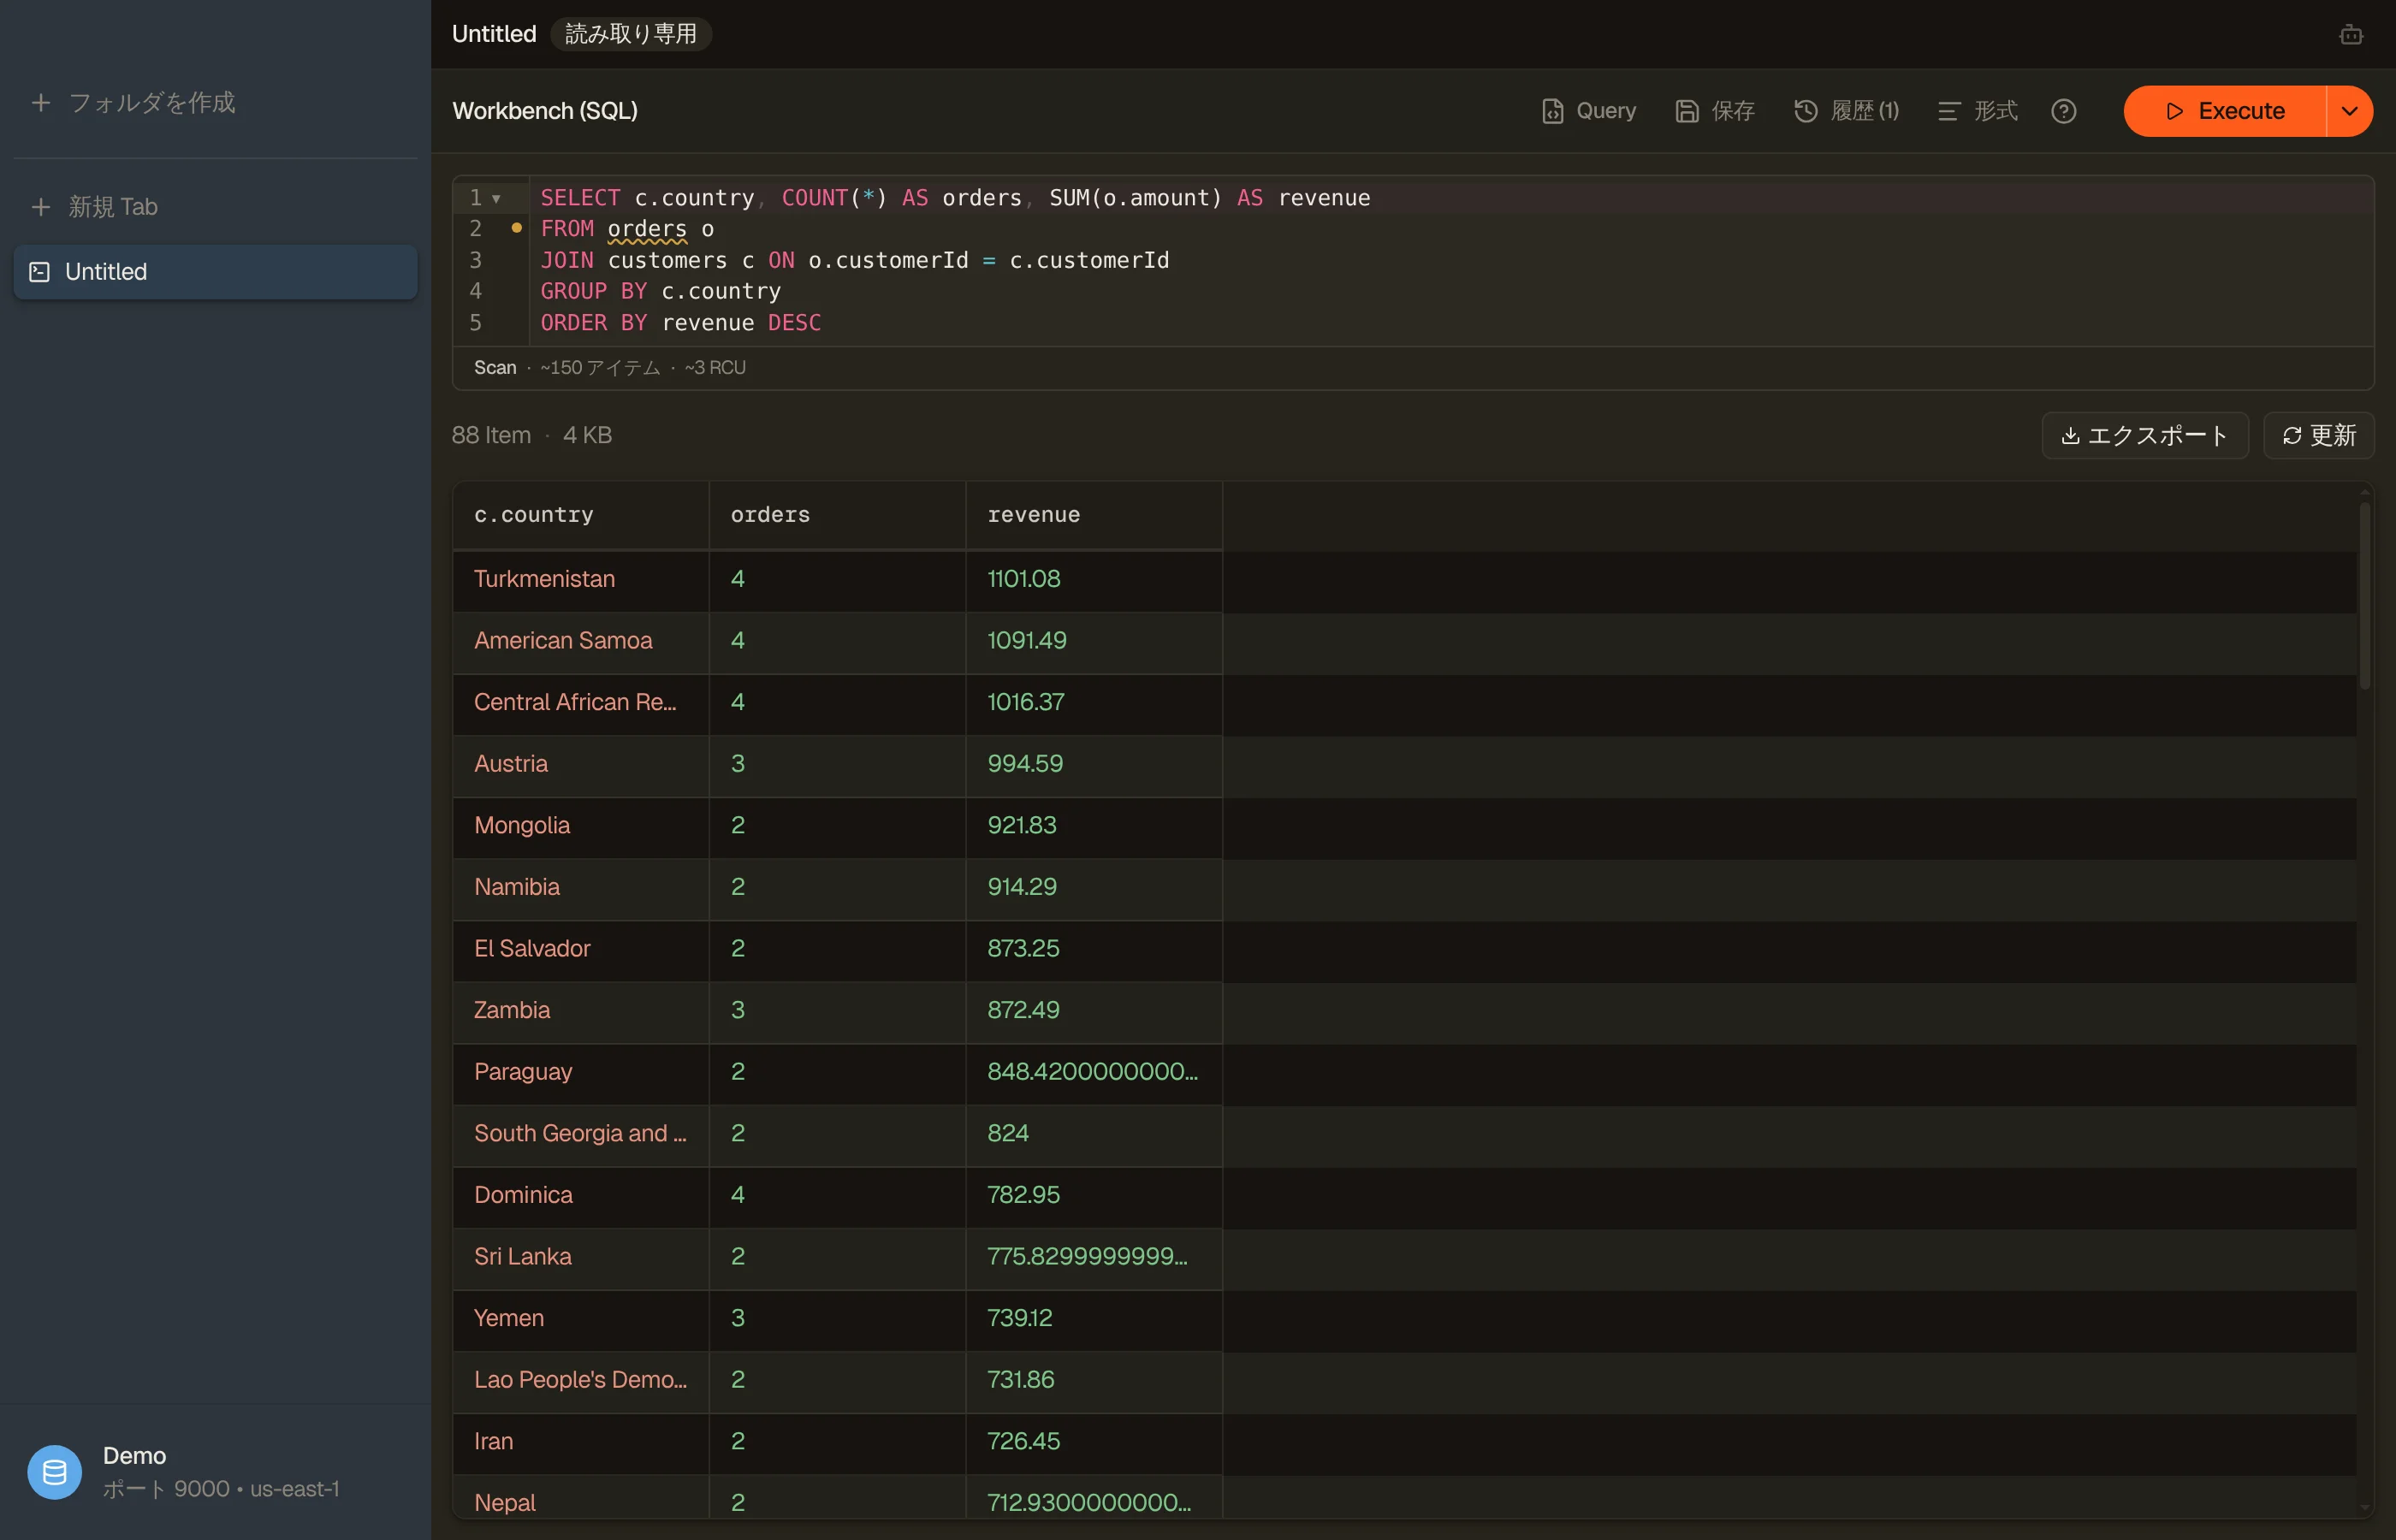


プランニングで読み取りが安くなるわけではありません。パーティションキーの等価条件を持たない WHERE や GROUP BY はフル Scan として実行され、読み取ったすべてのアイテムが課金されます。JOIN ごとに結合先テーブルへのキー検索(重複を除いた
BatchGetItem)が加わり、結合先テーブルは結合属性でキー付けされている必要があります。つまり、ソートキーのないテーブルのパーティションキーか、ちょうど 1 つの GSI のパーティションキーです。自己結合も同じルールに従います。サブクエリ、CTE、UNION、ウィンドウ関数は使えません。
実行前に、Workbench のプレビューは Scan か Query かと、使用するインデックスを示します。RCU の見積もりはベースの読み取りを対象とし、テーブルのメタデータが対応している場合にのみ表示されます。結合先テーブルの読み取りはインラインで示されますが、見積もりには含まれません。通常のパーティション Query では RCU は表示されません。
コンソールの PartiQL エディタが止まる壁にぶつかったなら、
SQL for DynamoDB ガイドが何が動き何が動かないかを説明し、DynamoDB JOIN ガイドが Workbench がどう
2 つのテーブルを結合するかを示し、GROUP BY ガイドが
GROUP BY 句なしの集計を扱います。
あなたのキーで動く AI エージェントと、既に使っているエージェントのための MCP
コンソールには Amazon Q が付属します。コンソールの画面から AWS の質問に答える、ホスト型のアシスタントです(aws.amazon.com/q/developer)。DynoTable のエージェントは別の種類のツールです。推論はあなた自身の AWS アカウントの Amazon Bedrock
上で実行され、DynoTable のサーバーがプロンプトや行データを見ることはなく、AWS には上乗せなしの原価で支払います。エージェントはクエリの前にあなたのキースキーマと GSI を読み取り、キーが許すなら Scan より Query を優先し、書き込みはレビューする差分としてステージすることしかできません。あなたの了承なしにコミットされることはありません。セットアップ、モデル、権限は AI チャットのドキュメントが扱います。
すでに Claude Code、Cursor、Codex と仕事をしているなら、代わりにそのエージェントをあなたのテーブルに向けてください。DynoTable はテーブルを MCP 経由で公開し、スコープは接続ごとに選べます(読み取り専用、読み取り + ステージング、フル)。外部エージェントが直接書き込むことは決してありません。その変更は同じステージングエリアにレビュー可能な差分として着地し、コミットするのはあなたです。詳細は MCP セットアップガイドにあります。
日々の DynamoDB の作業のために作られている
日々のスピードの大半は、何百回も繰り返される小さなことでできています。そしてここが、デスクトップクライアントがブラウザのタブと分かれるところです。
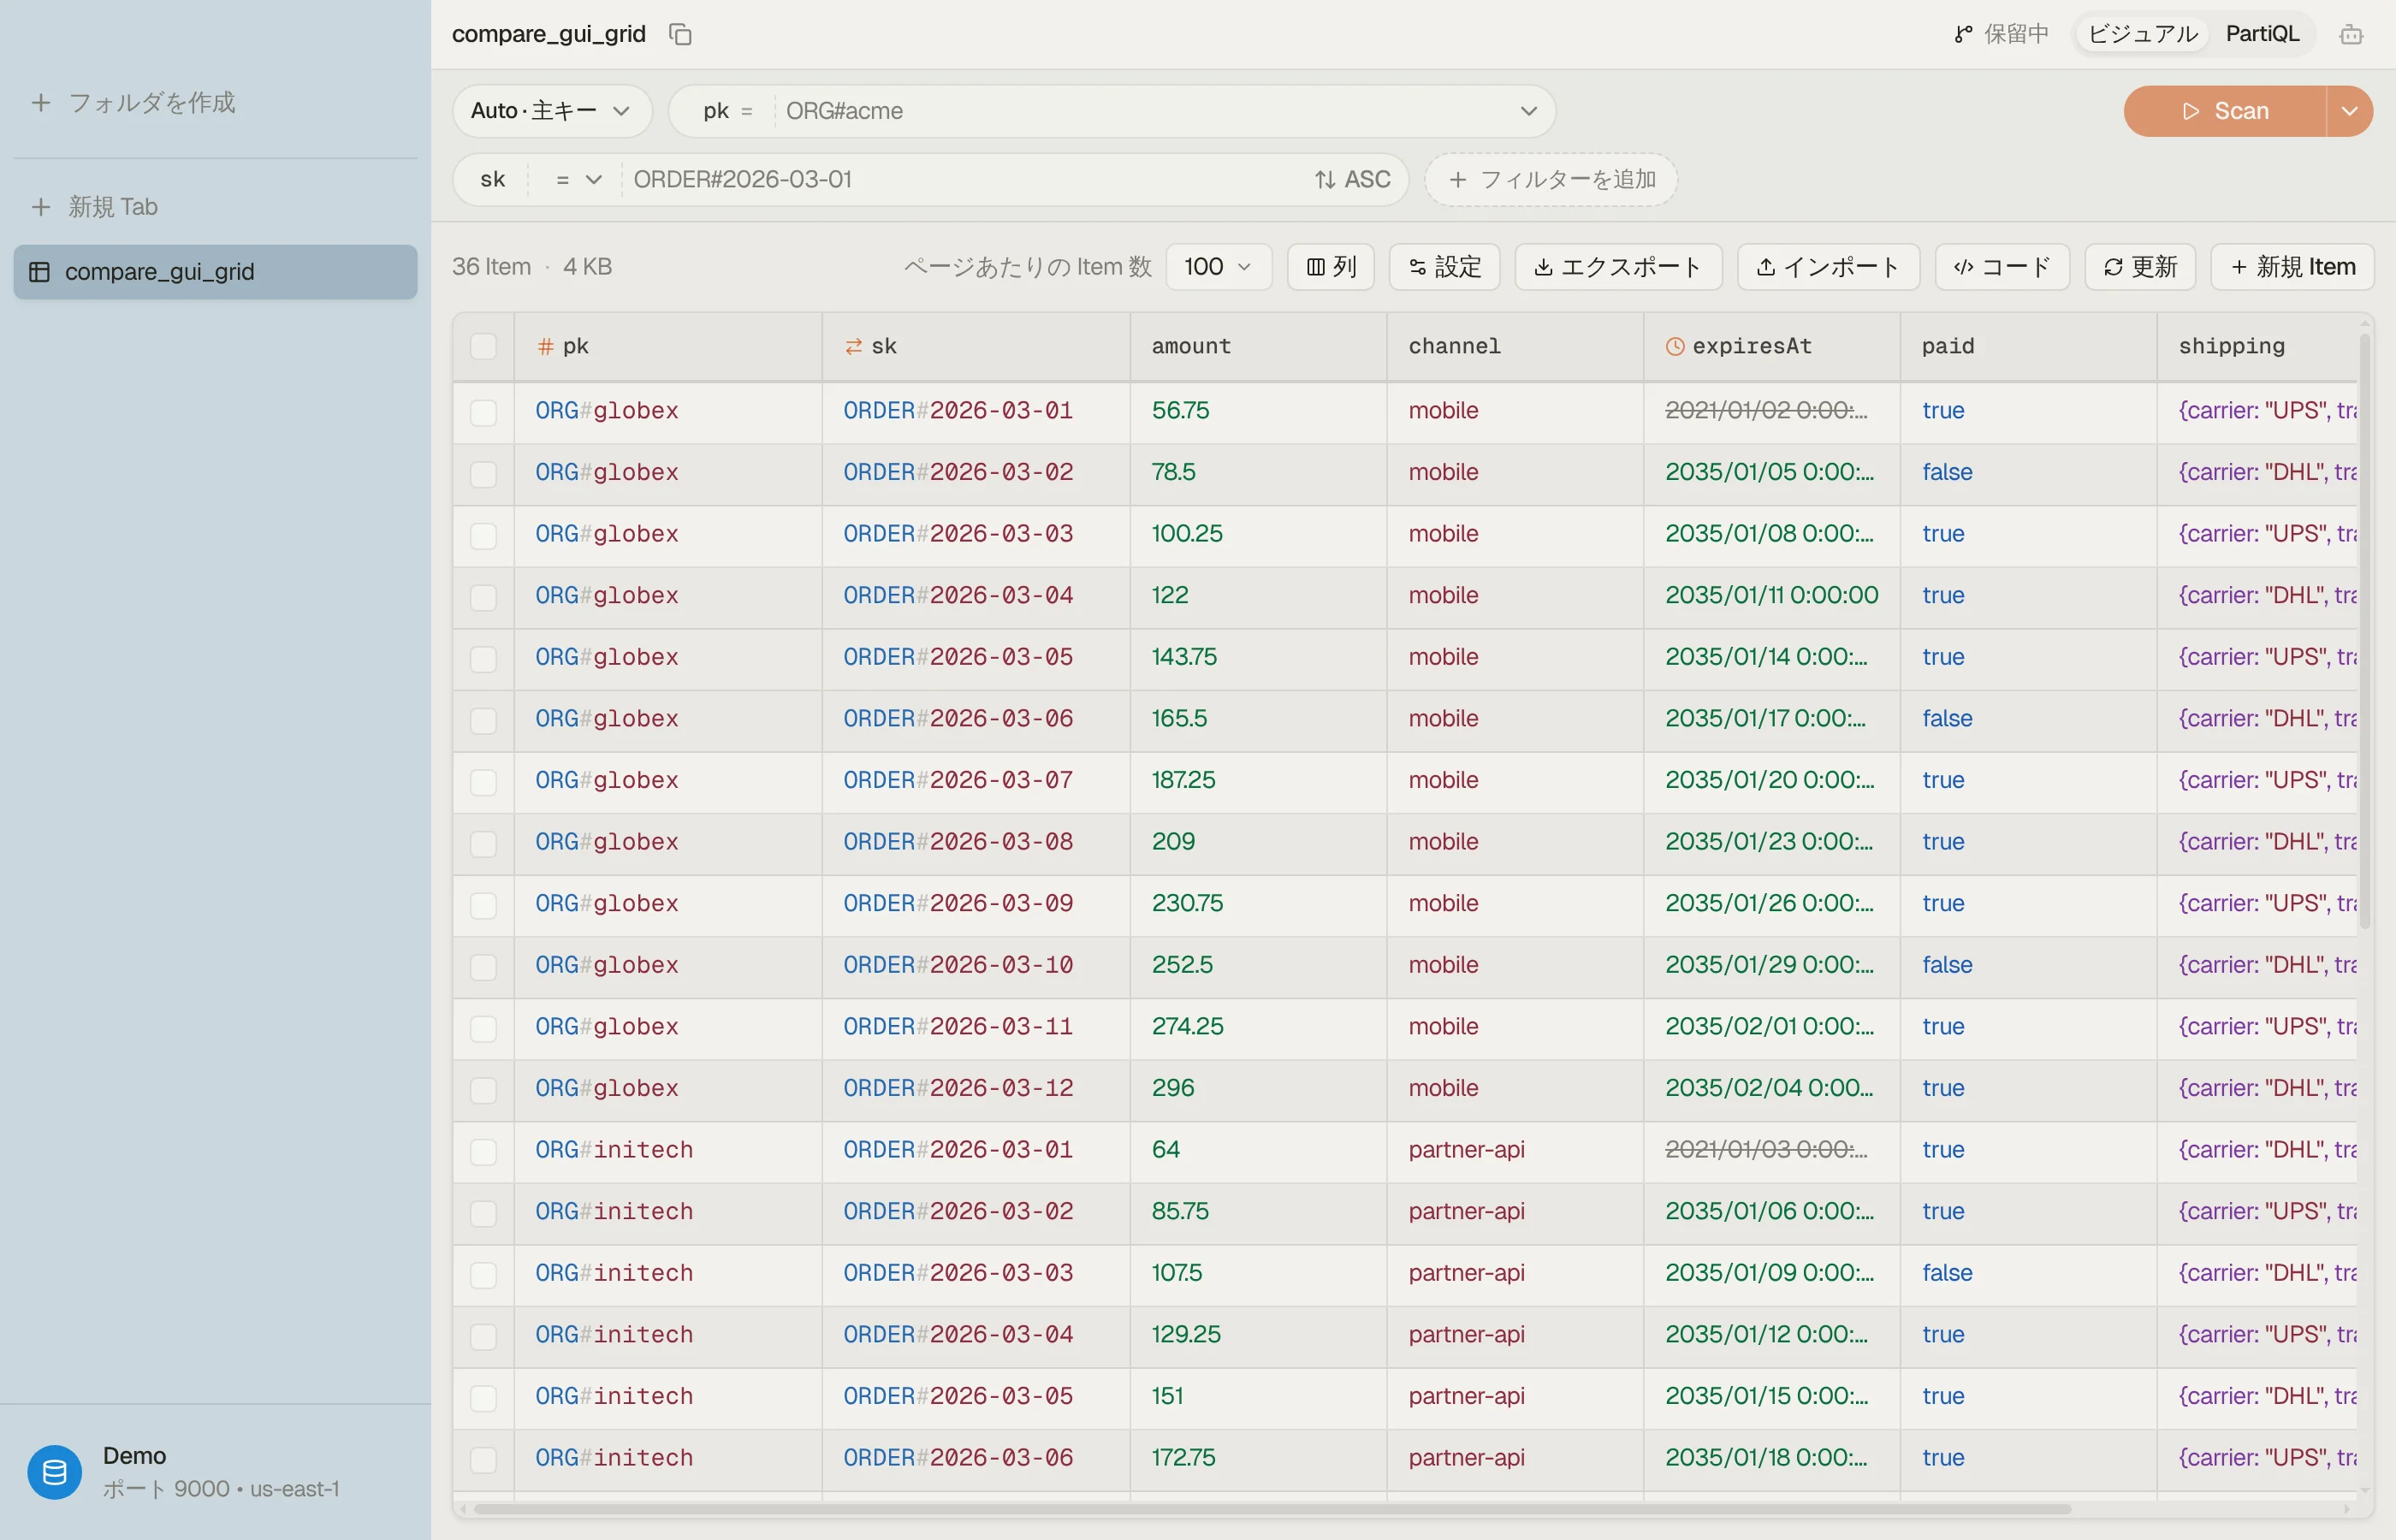
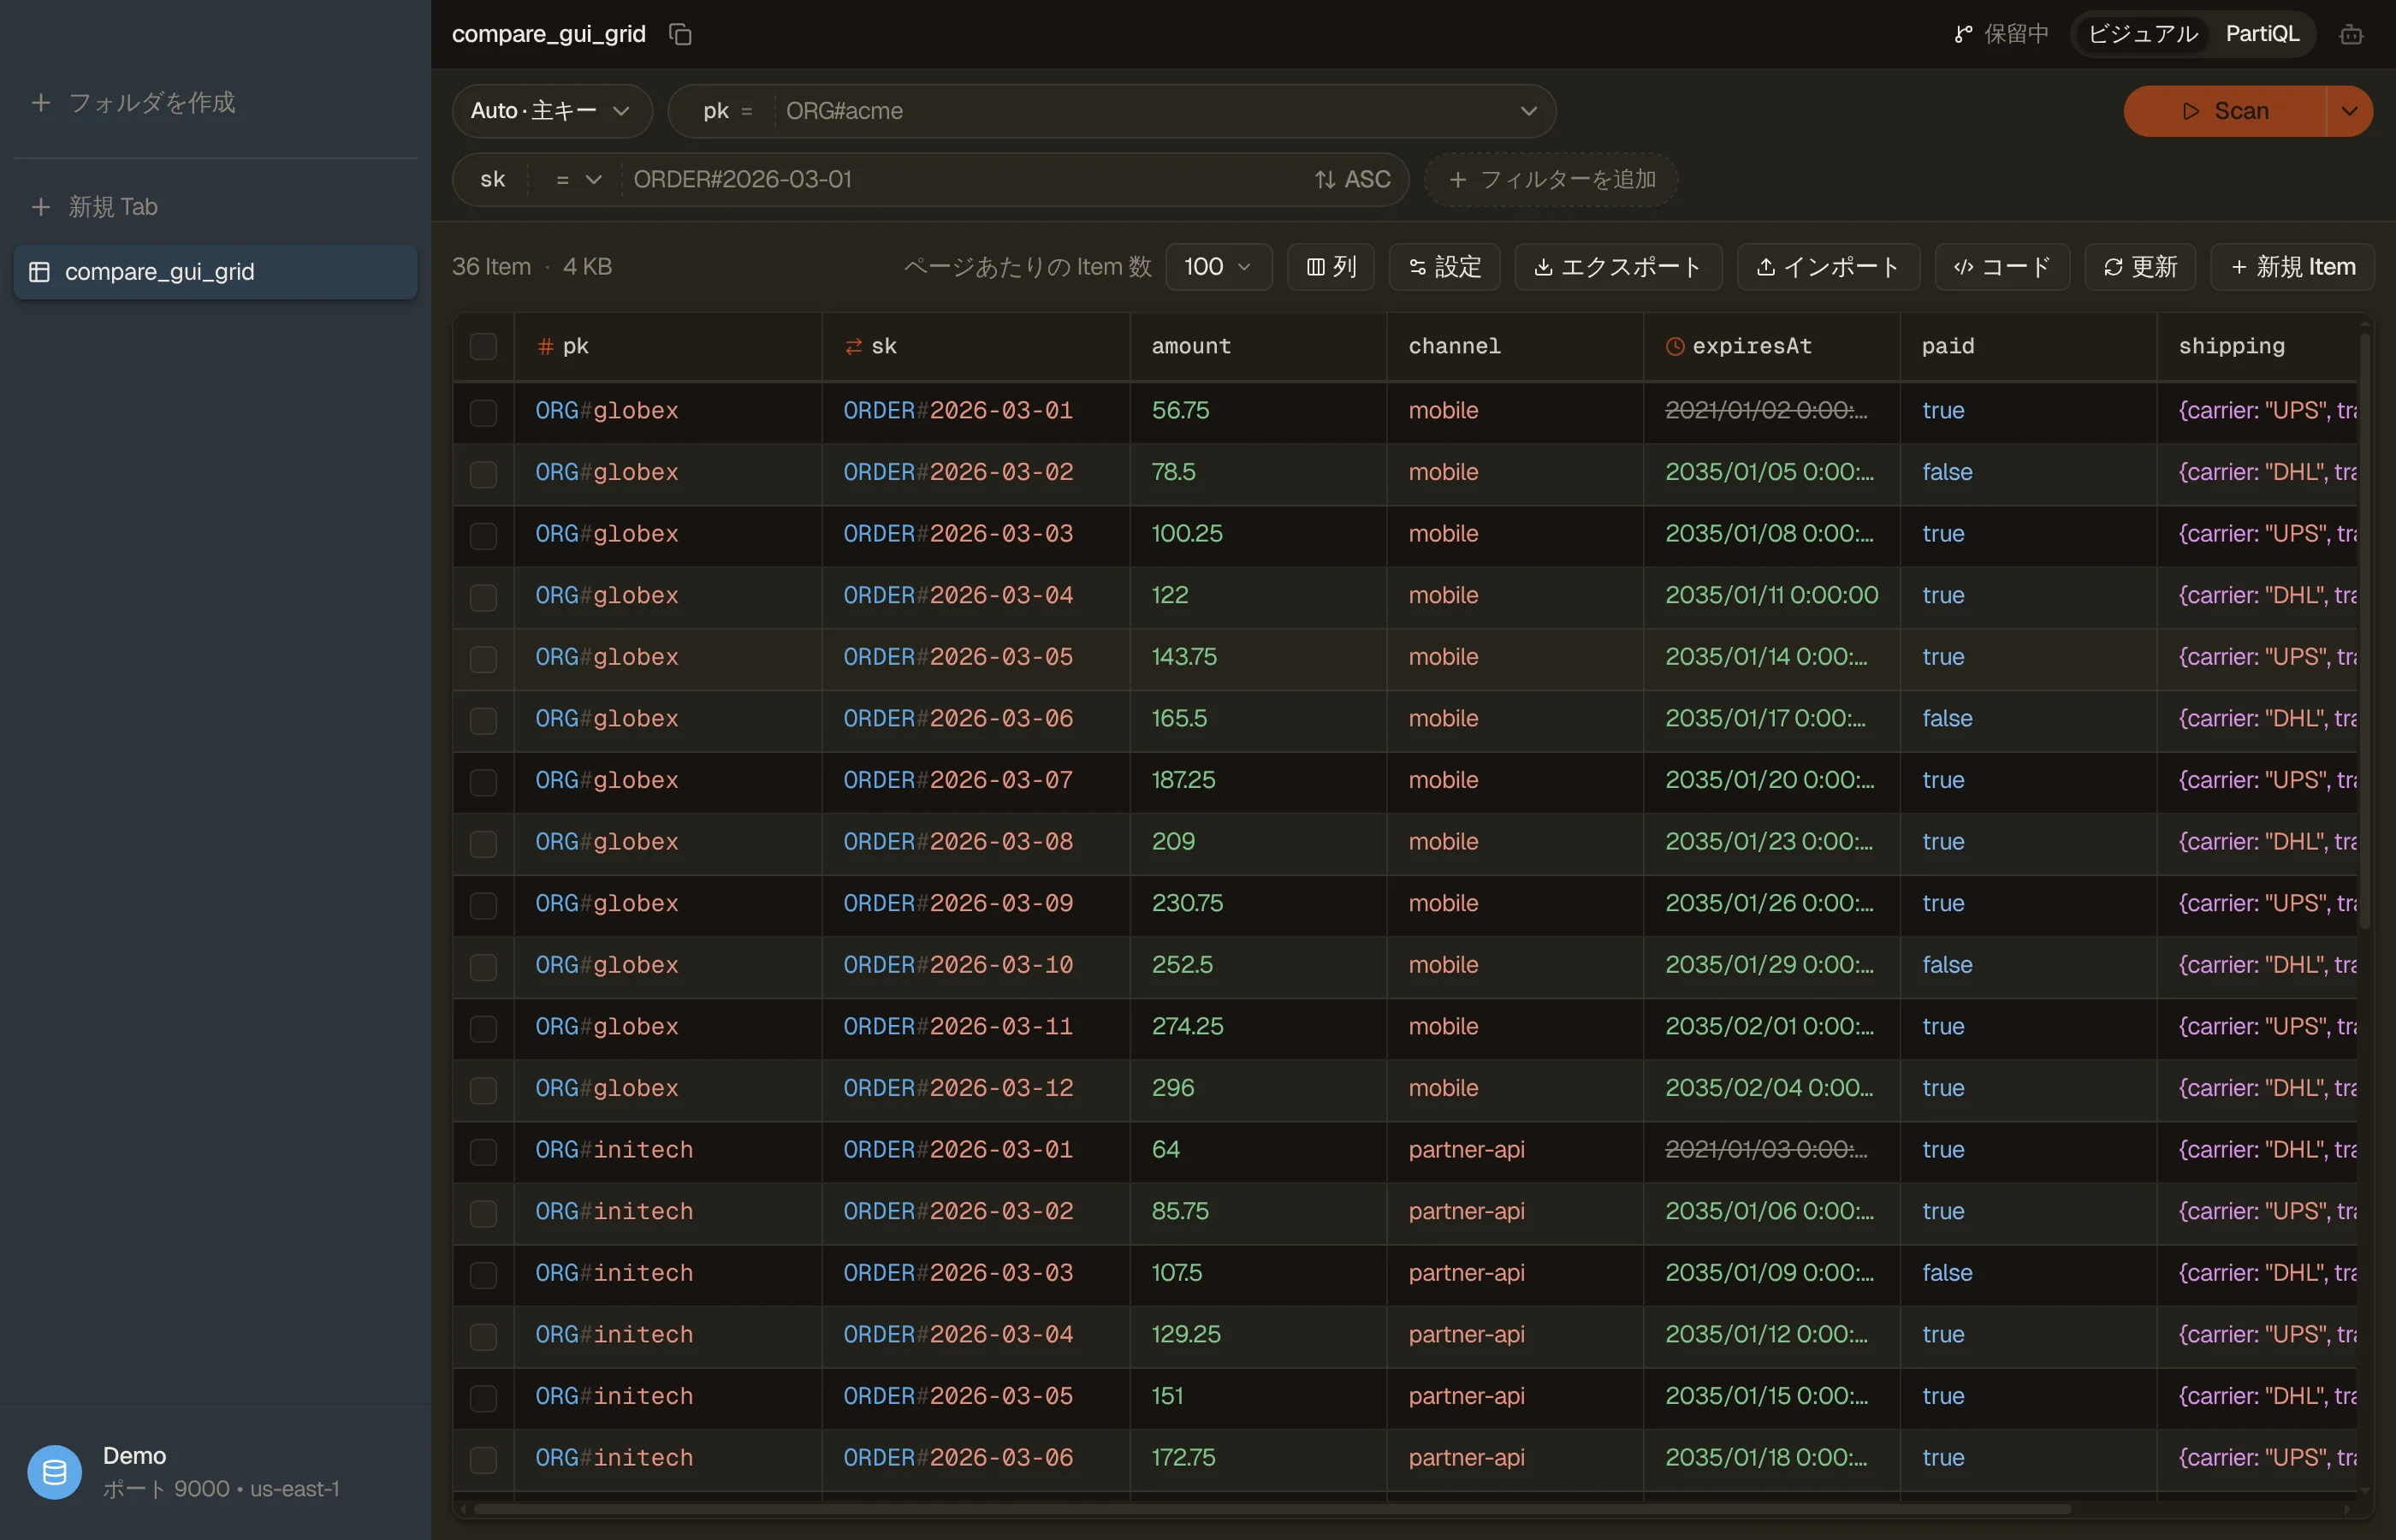
- タブとフォルダ: テーブル、クエリ、アイテムエディタをタブで開いたままにし、フォルダにまとめられます。再起動すればワークスペース全体が戻ってきます。
- 保存クエリ: PartiQL と SQL にまたがる 1 つのクエリライブラリ。前のスプリントでチューニングした文は、記憶から作り直す代わりにキー 1 つで呼び出せます。
- プロファイルの切り替え:
~/.awsの設定にあるすべてのプロファイルを、それぞれのリージョンに固定したまま ⌘P(または ⌘1–⌘9。 Windows と Linux では Ctrl)で切り替えられます。再サインインも、ロール切り替えのダンスもありません。 - オートコンプリート: フィルタはあなたのアイテムから属性名を提案し、クエリエディタは入力に合わせてテーブル名と SQL を補完します。
- キーボードファースト: ⌘K でテーブル、Smart Table、ワークベンチ、チャットを開いたり、作成アクションを始めたりできます。
- ステージングした書き込み: アイテムを保存するたびに Stage か Commit を選べます。ステージした変更は、AI エージェントがドラフトしたすべての変更と同じく、テーブルごとのステージングエリアで属性ごとの差分として、あなたのレビューとコミットを待ちます。コミットした編集は History から元に戻せます。コンソールの編集はクリックした瞬間に保存されます。
- DynamoDB Local: プロファイルを localhost に向ければ、ローカルのテーブルを他のリージョンと同じように閲覧できます。ダウンロード版の DynamoDB は "without accessing the DynamoDB web service"(DynamoDB ウェブサービスにアクセスせずに)動作し(AWS ドキュメント)、 Web コンソールはウェブサービスしか表示しないので、ローカルのテーブルはコンソールからは見えません。
コンソールのベクトル検索が止まるところ
コンソールはベクトル検索の一部を扱えます。テーブルの Indexes タブからベクトルインデックスを作成でき、Explore items にはインデックスの選択と Top K を備えた Search モードがあり、検索も実行できます。ベクトルを作ることはしません。AWS 自身のローンチ解説はクエリの埋め込みをコンソールの外で生成してから「paste[s] the query vector into the Search vector field(クエリベクトルを Search vector フィールドに貼り付ける)」と書いており、保存済みの側についてはドキュメントが率直です。「DynamoDB does not recompute embeddings for you. If you change the source content that produced an embedding … the stored vector does not update automatically(DynamoDB は埋め込みを再計算しません。埋め込みの元になったコンテンツを変更しても、保存されたベクトルは自動的には更新されません)」(ベクトル検索の操作)。 PartiQL でも回避できません。「Vector indexes are not accessible through PartiQL (ベクトルインデックスには PartiQL からアクセスできません)」だからです(要件)。
コンソールだけでは、スクリプトが埋め込みモデルを呼び、各ベクトルを書き戻し、テキストが変わるたびに再実行する必要があります。DynoTable は、その中で行う編集についてはそれを引き受けます。埋め込みモデルとその読み取り元の属性を一度インデックスに結び付ければ、浮動小数点数の配列ではなく文章を打ち込み、行を右クリックして Find similar を選べ、元のテキストを変えるアイテムエディタでの保存のたびに、そのアイテムの埋め込みが書き直されます。一括編集、PartiQL での書き込み、あなたのアプリケーションからの書き込みは再埋め込みされないので、アプリには独自の埋め込みステップが引き続き必要です。
ベクトルインデックスにはオンデマンドのテーブルが必要で、DynamoDB Local では動かず、構築には数分かかり、作成には有料シートが必要です。文章での検索と保存時の埋め込みには AI の設定が必要で、あなた自身のアカウントの Bedrock トークンを消費します。一方、貼り付けたベクトルでの検索と Find similar は AI の設定が不要で、Bedrock トークンも消費しません。セットアップは ベクトル検索が扱います。
コンソールが押しつけてくる雑用
コンソールのアイテムブラウザは DynamoDB API の薄いラッパーで、API のルールのうち 2 つをそのままあなたに渡します。
- フィルタは支払う量を減らさない。 フィルタ式は "is applied after a
Scanfinishes but before the results are returned,"(Scanが終了した後、結果が返される前に適用される)ので、Scanは "consumes the same amount of read capacity, regardless of whether a filter expression is present"(フィルタ式の有無に関わらず、同じ量の読み取りキャパシティを消費する)のです(AWS ドキュメント)。これは DynoTable を含め、どのクライアントでも真であり、コンソールは実行前に読み取りの見積もりを示しません。これがなぜ重要かは query vs scan ガイドが扱います。 - ページネーションは手動。 "A single
Scanrequest can retrieve a maximum of 1 MB of data,"(1 回のScanリクエストは最大 1 MB のデータを取得できる)そして "the absence ofLastEvaluatedKeyis the only way to know that you have reached the end of the result set"(LastEvaluatedKeyがないことが、結果セットの末尾に達したことを知る唯一の方法だ)(AWS ドキュメント)。コンソールは結果をページごとに表示するので、テーブルを歩くにはページまたページとクリックすることになります。DynoTable のグリッドはカーソルを代わりに追いかけ、クエリを結果セットの末尾まで実行できます。カーソルが内部でどう動くかはページネーションガイドが説明します。
DynamoDB テーブルを CSV にエクスポートする方法
コンソール自身の一括エクスポートは Export to S3 です。テーブルのポイントインタイムリカバリ(PITR)の期間から、フルまたはフィルタしたエクスポートを DynamoDB JSON か Amazon Ion としてバケットに書き出します。PITR を有効にする必要があり、読み取りキャパシティは消費しません。フルエクスポートはテーブルのサイズで課金され、フィルタは単一のパーティションキー値を選択する場合を除いてその額を下げません(AWS ドキュメント)。 Athena や Glue には向いていますが、スプレッドシート用の CSV には変換の手順がもう 1 つ必要です。
DynoTable はクエリやスキャンの結果セット全体を、フィルタされたビューも含めて、CSV、 JSON 配列、または NDJSON として、プレーンな値でも生の DynamoDB JSON でも、ファイルにエクスポートします(クリップボードに送れるのは読み込み済みの行か選択範囲です)。エクスポートはバックグラウンドで実行され、進捗は Activity パネルに表示されます。 v1.16.2 以降は、テーブルタブのビジュアルクエリから S3 へのフィルタ付きエクスポートも開始できます(同じ AWS のエクスポートで、PITR が必要、形式は DynamoDB JSON か Ion)。より長い選択肢(AWS CLI、S3 エクスポート、スクリプト)は DynamoDB を CSV にエクスポートするガイドで扱います。
DynamoDB の低レベル API は、各属性をどう解釈するかを DynamoDB に伝えるトークンとして型記述子(S、N、B、BOOL、…)を使うので(AWS ドキュメント)、ツールがそれらをフラット化しない限り、DynamoDB JSON の素朴な CSV ダンプは {"S": "..."} のラッパーを漏らします(データ型ガイドが型タグを説明します)。
同じテーブルで DynoTable を試す
macOS(Apple Silicon または Intel)、Windows、Linux 向けに DynoTable をダウンロードし、コンソールで使っているのと同じプロファイルとリージョンに向け、以前は表現できなかった
JOIN や GROUP BY を実行してください。トライアルは30日間無料で、クレジットカードは不要です。Individual の有料シートは 年払いで月額 $9(年 $108)からで、月払いと
Team の料金は料金を参照してください。トライアル後も Free プランでは、閲覧、
PartiQL SELECT、アプリ内のエクスポート、MCP でのスキーマ/アイテムの読み取りを期限なしで使えます。
よくある質問
AWS DynamoDB コンソールのより良い代替はありますか?
はい。DynoTable は、コンソールが一度も持たなかったものを追加するデスクトップ DynamoDB クライアントです。JOIN、GROUP BY、集計のための SQL Workbench、あなた自身の Bedrock キーで動く AI エージェント、コーディングエージェントのための MCP アクセス、ステージングした書き込み、結果全体の CSV/JSON/NDJSON エクスポート、そしてタブ、フォルダ、保存クエリです。
AWS コンソールが無料なのに、なぜ DynamoDB アプリにお金を払うのですか?
DynoTable の Free プランも無料で、期限はありません。Free に含まれるのは、閲覧、PartiQL の SELECT、OpenSearch インデックスの検索、データ・コード・スキーマのエクスポート、そして MCP でのスキーマ/アイテムの読み取りです。有料シートでは SQL Workbench、Smart Tables、書き込み、AI が加わります。
なぜ DynamoDB コンソールは JOIN や GROUP BY を実行できないのですか?
コンソールは PartiQL でクエリし、その SELECT 文法は任意の WHERE と ORDER BY を伴う単一テーブルで、行をまたぐ集計もありません。AWS が集計関数の欄に挙げる唯一の関数
SIZE は、1 つの属性のバイト単位のサイズを返します(AWS ドキュメント)。
DynoTable の SQL Workbench はそれらのクエリをクライアント上でプランニングし、DynamoDB
の Query/Scan 操作にコンパイルします。
コンソールの代替を使うにはデータを移行する必要がありますか?
いいえ。DynoTable は標準の AWS 認証情報チェーンを読み、同じリージョンとテーブルを指します。データは DynamoDB に留まるので、移行するものはありません。
関連ページ
- すべての DynoTable の代替については、完全な比較ハブを閲覧してください。
- DynamoDB GUI としての DynoTableと NoSQL Workbench の比較も参照してください。
- 無料の DynamoDB 式ビルダーでクエリを素早く構築してください。
最終確認 2026-10-09。AWS、DynamoDB、Amazon Q、AWS コンソールは Amazon Web Services の商標であり、ここでは識別目的でのみ言及しています。