Dynomate の代替:DynoTable と Dynomate の比較
Dynomate は、Git で管理し、アプリや CLI から実行するリクエストファイルを中心に作られた、高速で活発にメンテナンスされている DynamoDB クライアントです。
ライブのテーブルに対する JOIN と GROUP BY、あるいはクライアントの中で働く AI エージェントが必要なら、DynoTable が Dynomate の代替になります。その SQL Workbench は、DynamoDB のアクセスパターンのルール内でそうしたクエリを計画します(SQL for DynamoDB を参照)。
Dynomate が得意なこと
Dynomate はリリースが頻繁です。バージョン 2.0(2026 年 9 月 24 日)で、リクエストは DNML ファイルになりました。これはデスクトップアプリと新しいコマンドラインツールの両方が実行する TOML 形式です。リクエストの各ステップには、DynamoDB と Athena の 23 種類の操作のどれでも使えます。1.19 では 4 種類でした。
バージョン 2.1(2026 年 10 月 6 日)では Amazon Aurora DSQL が加わりました。SQL コンソール、行の編集、そしてリクエストと CLI での DSQL 操作です。テーブル操作は、作成(キー、GSI、キャパシティを含む)、削除、truncate、TTL の切り替えをカバーします。AWS SSO と aws login のプロファイル、DynamoDB Local、JSON/CSV/S3/他テーブルからのインポートにも対応しています。
料金はサブスクリプションです。Community は無料で、有料ティアは年払いで月額 10 ドル、18 ドル、29 ドル、14 日間のトライアル付きです。リクエストコレクション(Beta 表記)と AWS SSO プロファイルは 18 ドルの Professional ティアからです。
Dynomate にあって DynoTable にないもの
- Intel Mac 向けビルド: Dynomate 2.0 でネイティブ版が加わりました。DynoTable の macOS ビルドは Apple Silicon 専用です。
- 1 つのセッションで複数のアカウントとリージョン: Dynomate は接続済みのアカウントとリージョンをまたいでテーブルを見つけ、タブごとに独自のプロファイルとリージョンを保持します。DynoTable のプロファイルは 1 つのリージョンに固定され、⌘P でプロファイルを切り替えます。
- Athena と Aurora DSQL: Dynomate は DynamoDB のタブの隣で両方にクエリできます。DynoTable が扱うのは DynamoDB だけです。
- CI 向けの CLI:
dynomate-cli requests runが同じリクエストファイルをパイプラインで実行します。CLI は npm から@dynomate/cli(2.1 以降は 0.1.0)としてインストールでき、ライセンスは不要です。DynoTable には CLI がありません。 - Git で共有するリクエストファイル: コレクションは DNML ファイルのフォルダーなので、プルリクエストで差分を確認できます。DynoTable の保存クエリはユーザーごとで、アプリの中にとどまります。
- サインイン不要の無料ティア: Community は Dynomate アカウントなしで動き、作業タブは 2 つまでです。DynoTable の Free プランには無料アカウントでのサインインが必要です。
JOIN の代わりに Dynomate のリクエストがやること
複数テーブルにまたがる質問に対する Dynomate の答えはリクエストです。これは操作のリストで、後の操作は ${…} テンプレートを通じて前の操作の結果を読みます。2.0 はステップになれるものを広げましたが、実行モデルはそのままです。ドキュメントには "A request runs its operations one at a time" とあり、実行順序を組み立てるときには "It adds each operation one time only" とあります(dynomate.io/docs/dnml/execution)。
各操作は 1 回だけ実行されるので、リクエストは呼び出しの固定された並びです。「このユーザーを引いて、それからその注文を書く」はうまく表現できます。「倉庫の地域ごとの平均輸送時間」の場合、batch get は前の結果からキーのリストを受け取れますが、テンプレートは値をそのまま写すだけなので、出荷のスキャンが返す倉庫 ID を射影したり重複を除いたりはできません。
前の結果のアイテムごとに 1 回ずつ実行されるステップも、集計するステップもないので、出荷への結合し直しと地域別の平均はスクリプトに回ります。Dynomate の SQL は 1 つのテーブルのスナップショットを集計できますが、別のテーブルとは結合できません。
Dynomate の SQL はスナップショットに対して動く
Dynomate の 2 つ目の答えは Local SQL です。"can scan a complete DynamoDB table, build a local Parquet snapshot, and query that snapshot with DuckDB SQL" とあり、"Local SQL requires a completed full-table export" です(dynomate.io/docs/local-sql)。DuckDB はそのスナップショットに対して GROUP BY と集計を処理します。
エディターが公開するビューは snapshot と history の 2 つで、どちらも開いているテーブルを読みます。そのためクエリが対象にするのは 1 つのテーブルの行だけで、2 つ目のライブのテーブルには届きません。
スナップショットのたびにテーブル全体を読みます。Dynomate の言葉では "A full-table export uses DynamoDB Scan. It consumes read capacity and can be throttled." です。
AWS も "A Scan operation in Amazon DynamoDB reads every item in a table or a secondary index" と述べ、読み取りキャパシティを "based on the number of items and the size of those items, not on the amount of data that is returned to an application" として課金します(AWS Scan リファレンス)。新しいスナップショットを取るたびに、テーブル全体の読み取り分を支払います。
結果はスナップショットと同じだけ古いものです。これは Dynomate が挙げるユースケース、つまりデプロイのデバッグ中に 2 つの時点でテーブルを比較する用途に合っています。今の本番についての質問には、まず新しいスナップショットが必要です。
ライブのテーブルに対する DynoTable の SQL Workbench
DynoTable の SQL Workbench は、エクスポートの手順なしに、ライブのテーブルに対して同じ質問に答えます。
SELECT w.region, AVG(s.transitHours) AS avgTransit, COUNT(*) AS shipments
FROM shipments s
JOIN warehouses w ON s.warehouseId = w.warehouseId
WHERE s.status = 'delivered'
GROUP BY w.region
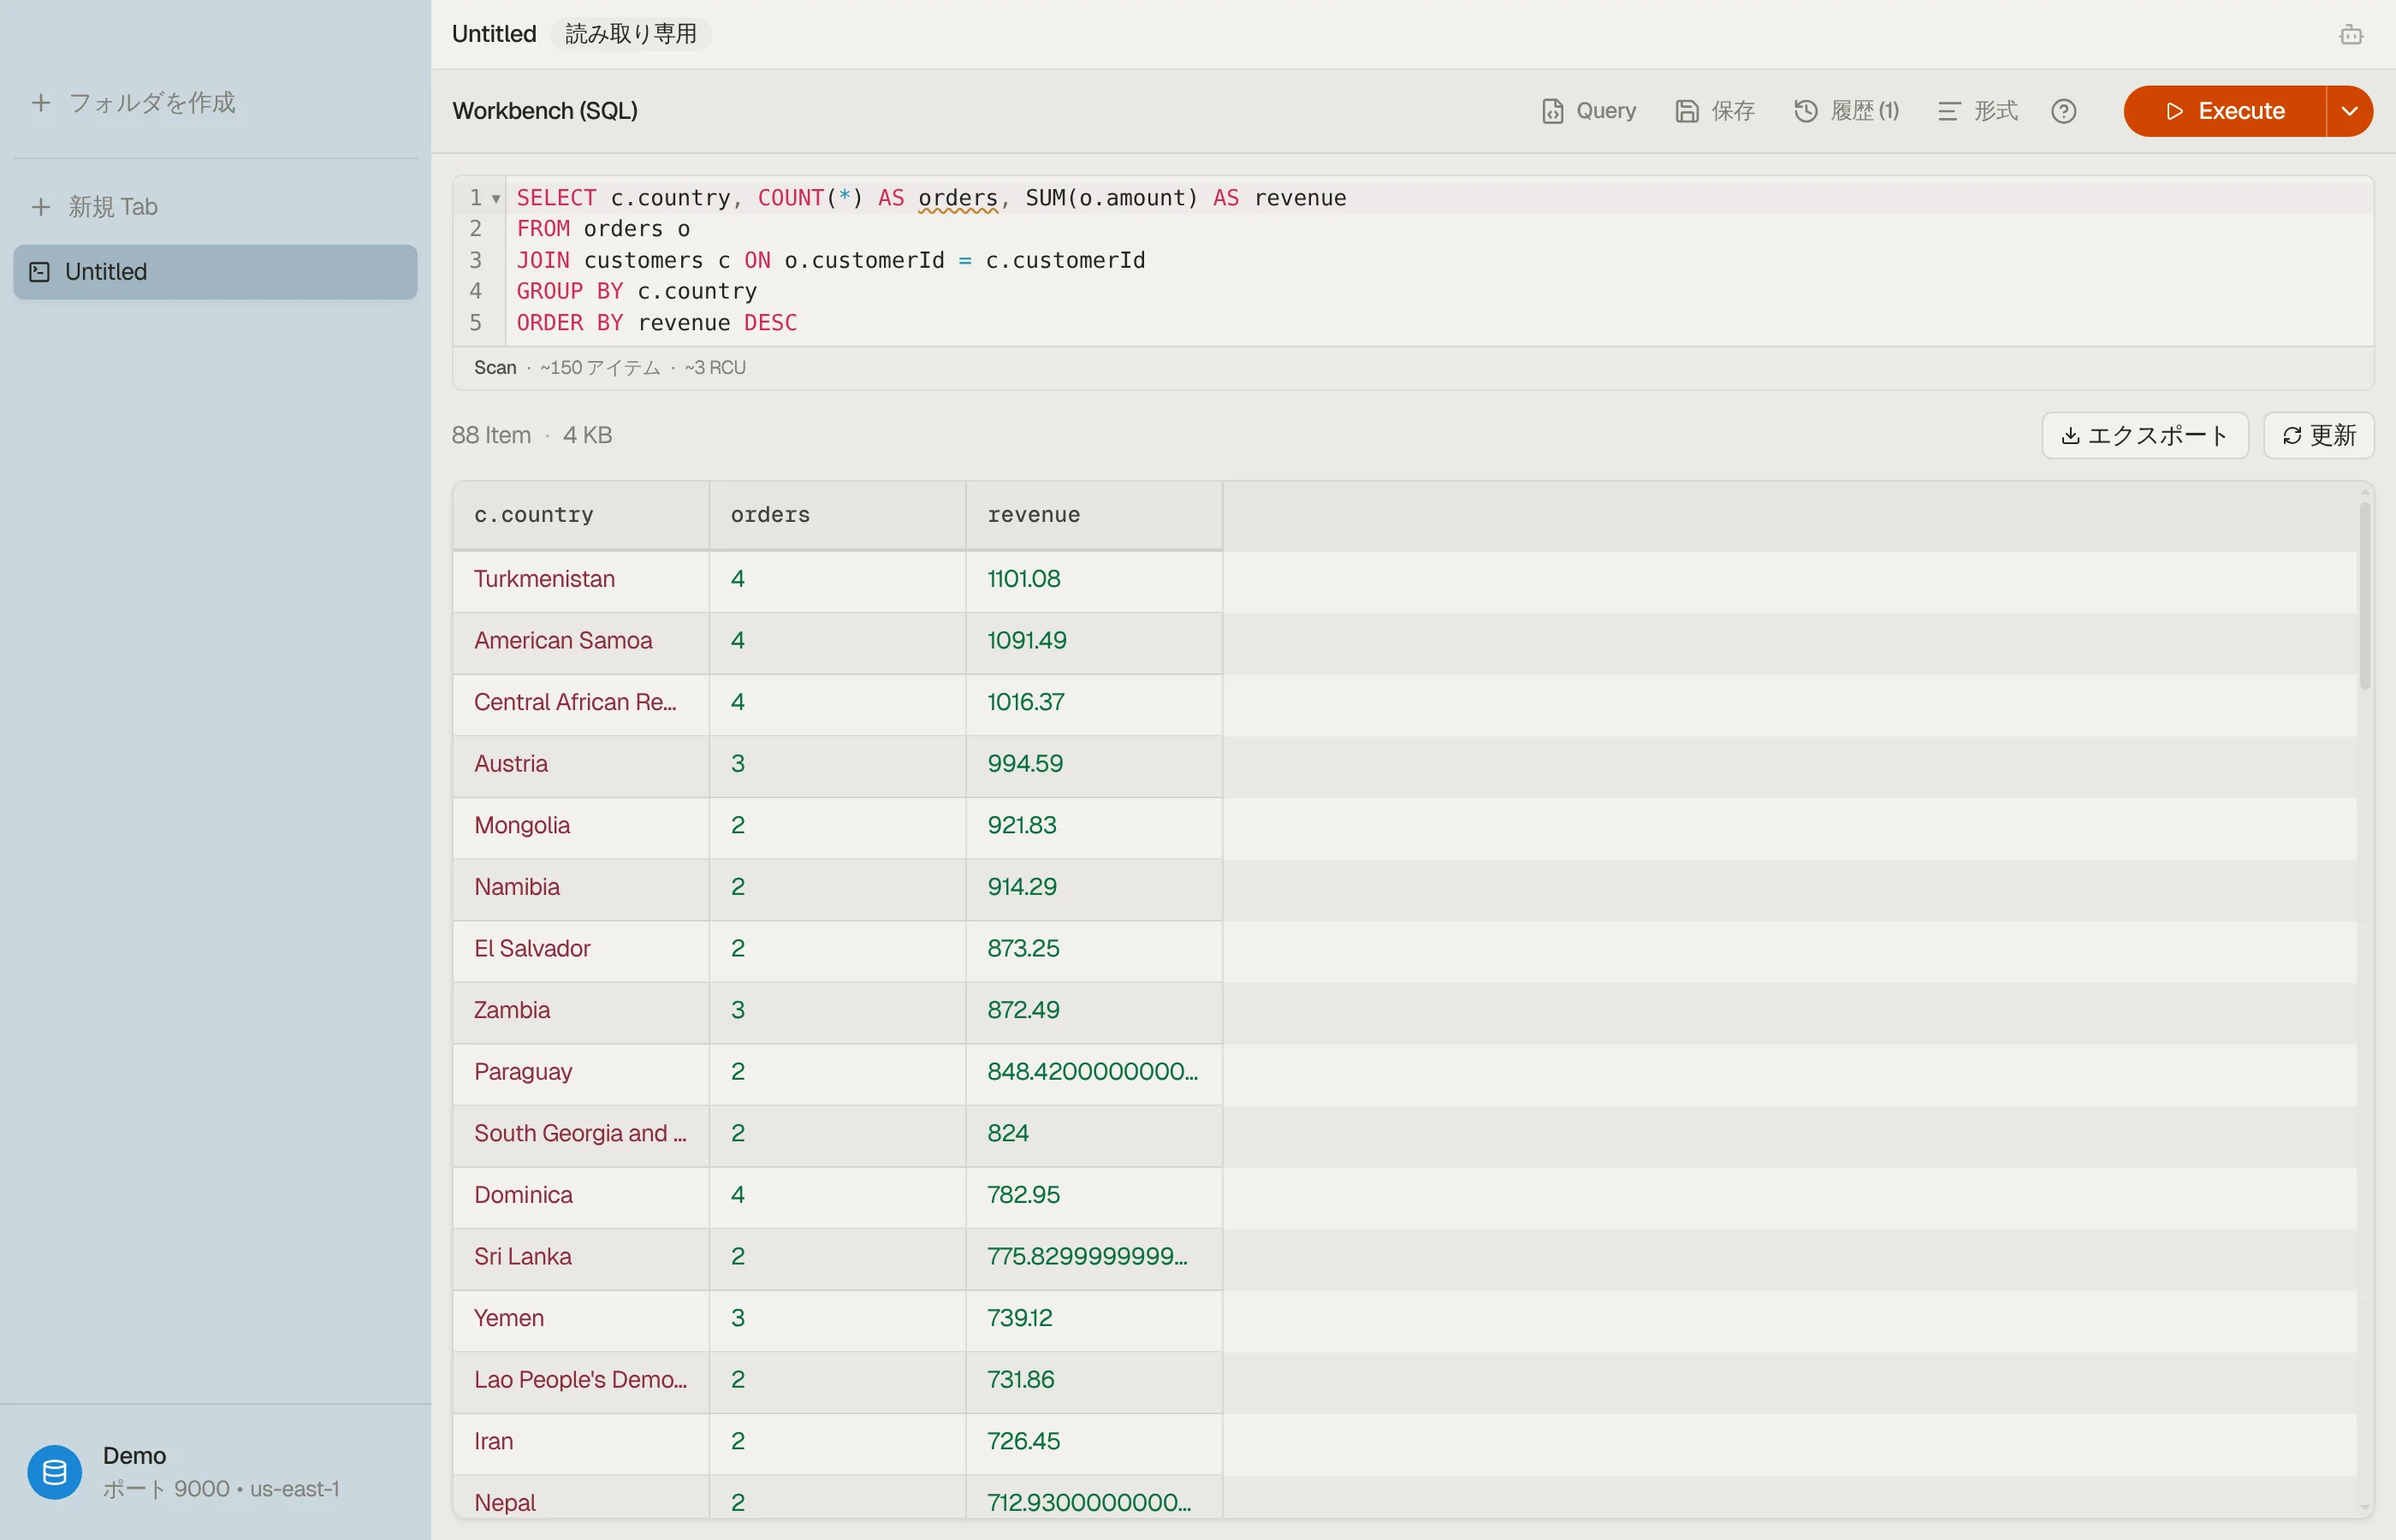

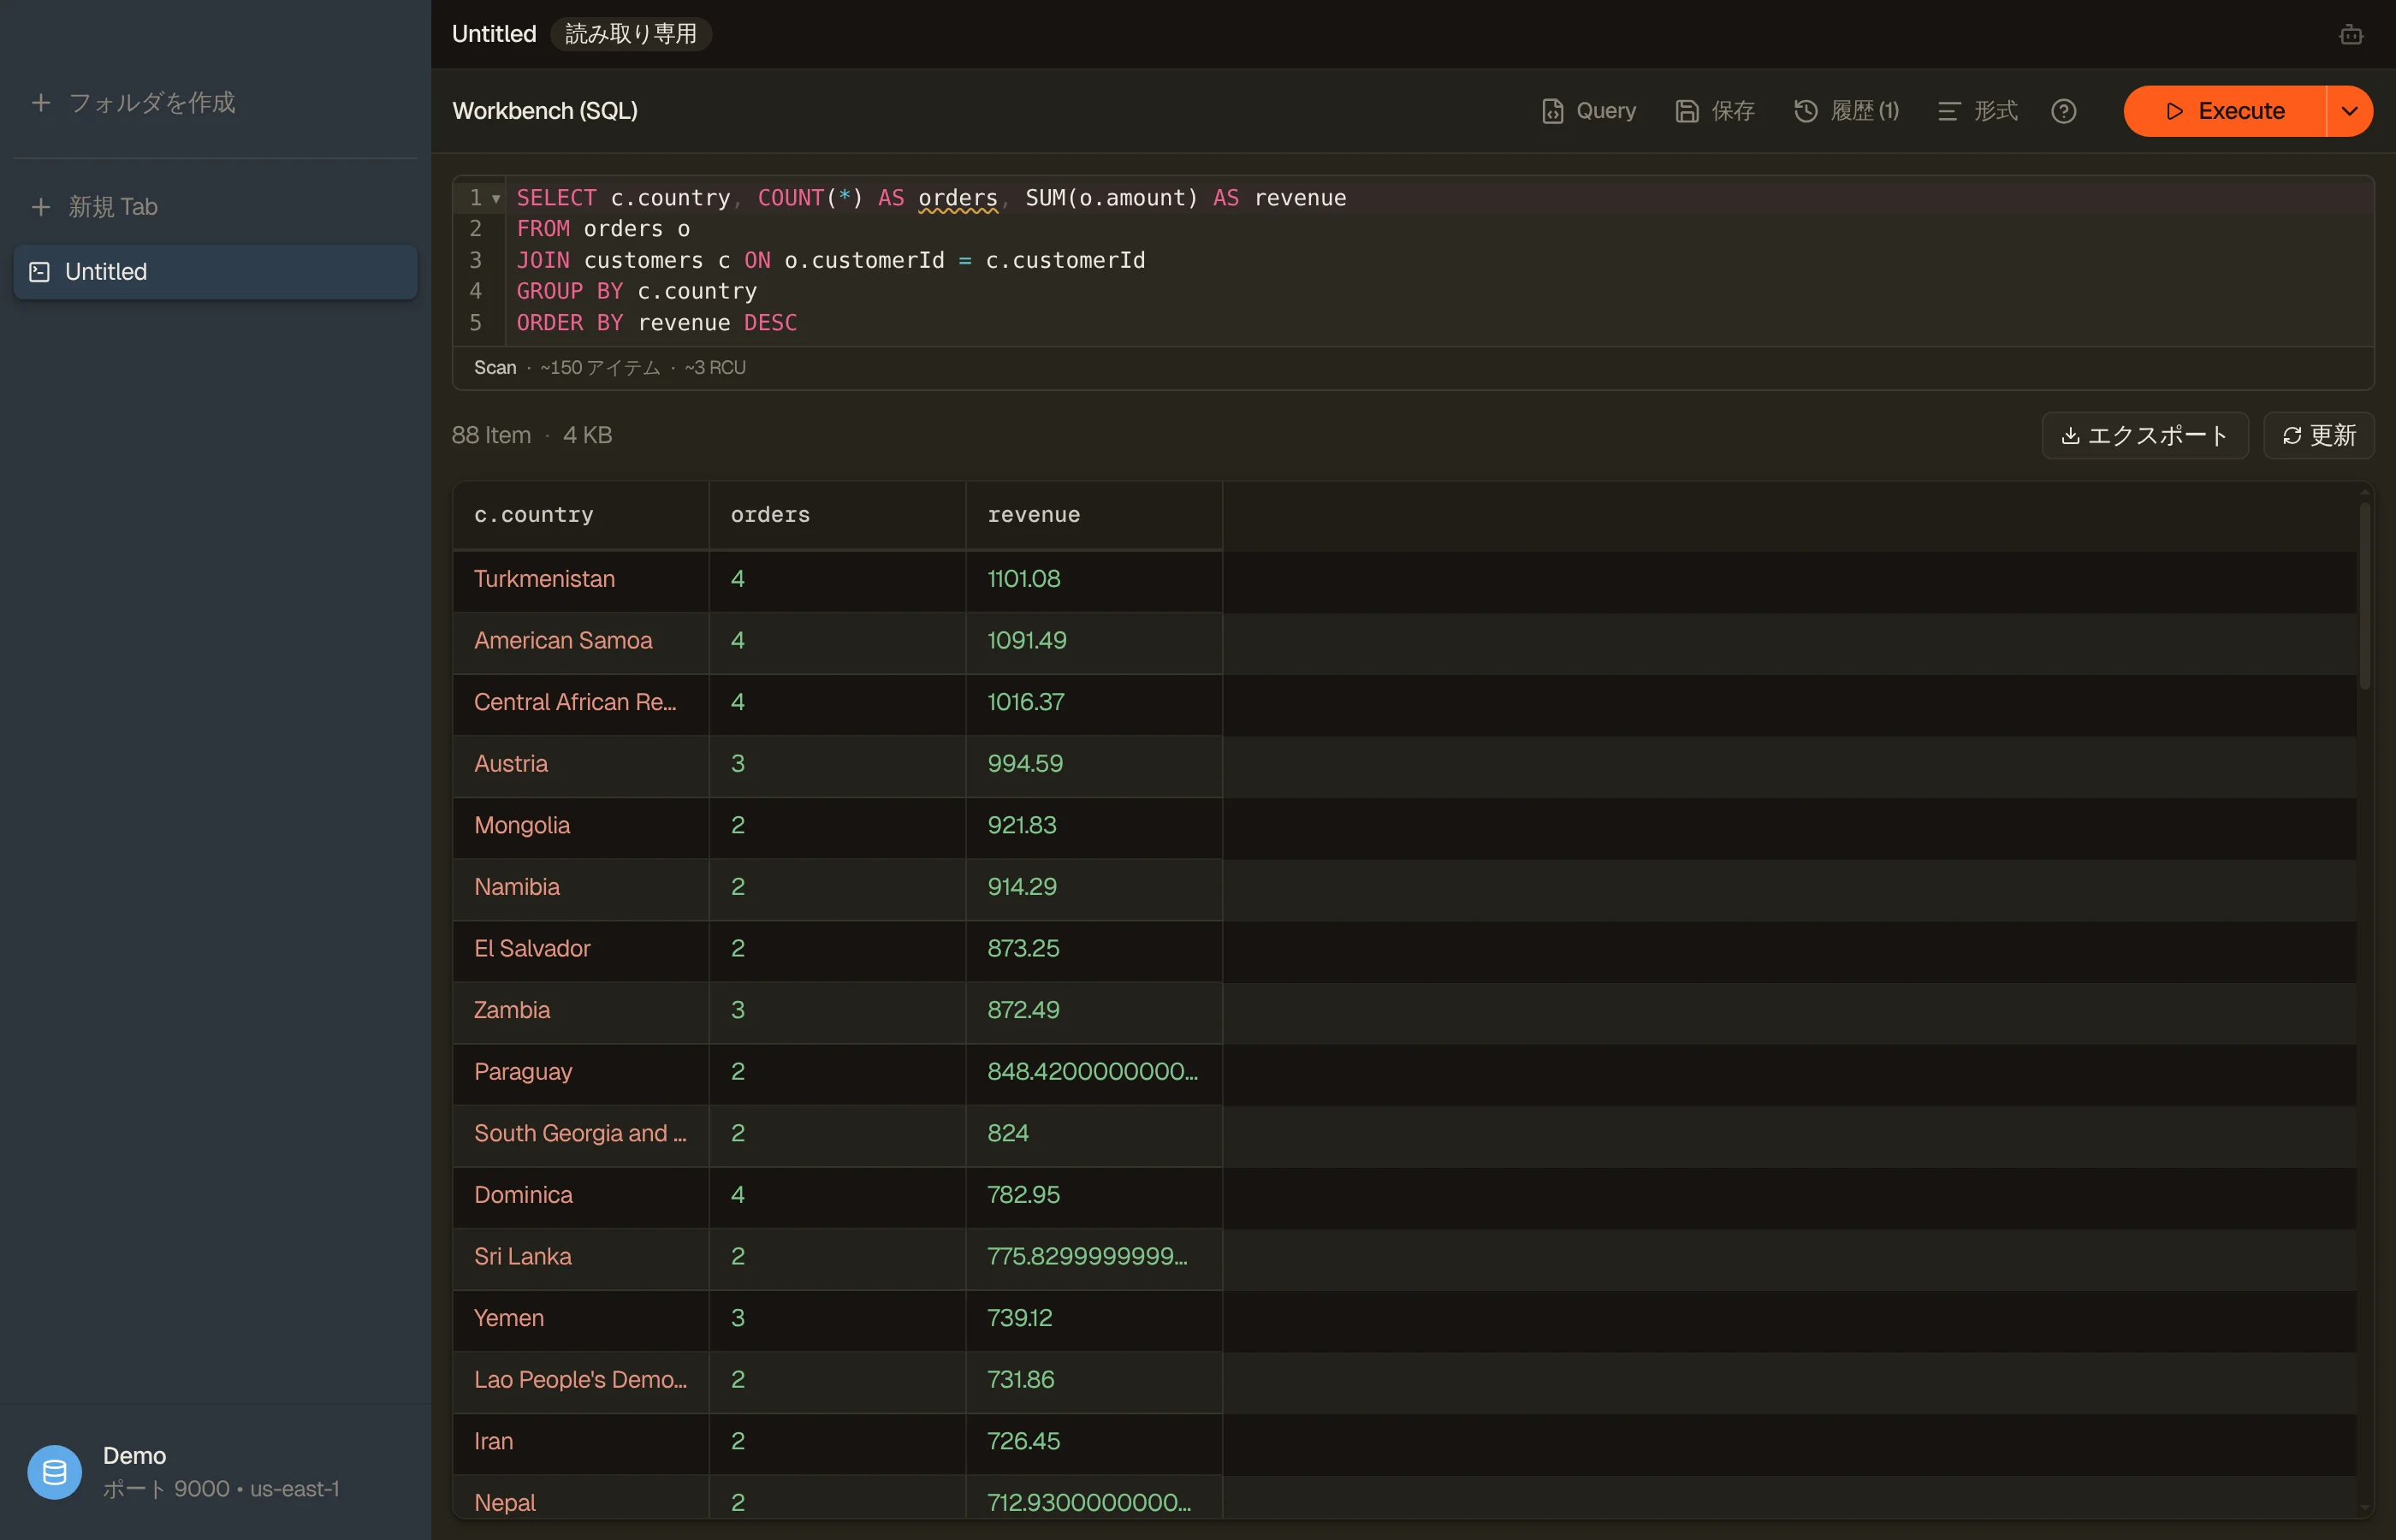
この文は、あなたのキーとインデックスに対して計画されたネイティブな Query と Scan の呼び出しにコンパイルされ、結合と AVG はクライアント側で走ります。結合が成り立つのは、warehouses が warehouseId をキーにしているからです。結合される側のテーブルは、結合する属性を、ソートキーのないテーブルのパーティションキーとして、またはちょうど 1 つの GSI のパーティションキーとして持っている必要があります。
エクスポートを省いても、読み取りのコストは省けません。status はキーではないので、この例は shipments の Scan を計画し、DynamoDB は実行のたびに読んだアイテムすべてに課金します。結合は warehouses へのキー検索を加え、それはバッチにまとめられ重複が除かれます。
プランが得られる場合、Workbench のプレビューは実行前に Scan と Query のどちらかと、使用するインデックスを示します。RCU の見積もりは、テーブルのメタデータが対応している場合にのみ表示され、JOIN ではベーステーブルの読み取り分だけを見積もります。結合される側のテーブルの読み取りはインラインで示されますが、価格は付きません。通常のパーティション Query では RCU は表示されません。
Workbench が対応するのは INNER JOIN と LEFT JOIN だけで(自己結合を含む)、サブクエリ、CTE、UNION、ウィンドウ関数はありません。集計列には、すべてのページを読み終えるまで (partial) と表示されます。これによって DynamoDB にサーバーサイドの結合が加わるわけではありません。DynamoDB GROUP BY がそのプランを順に説明します。
Dynomate には AI エージェント、MCP サーバー、ベクトル検索がない
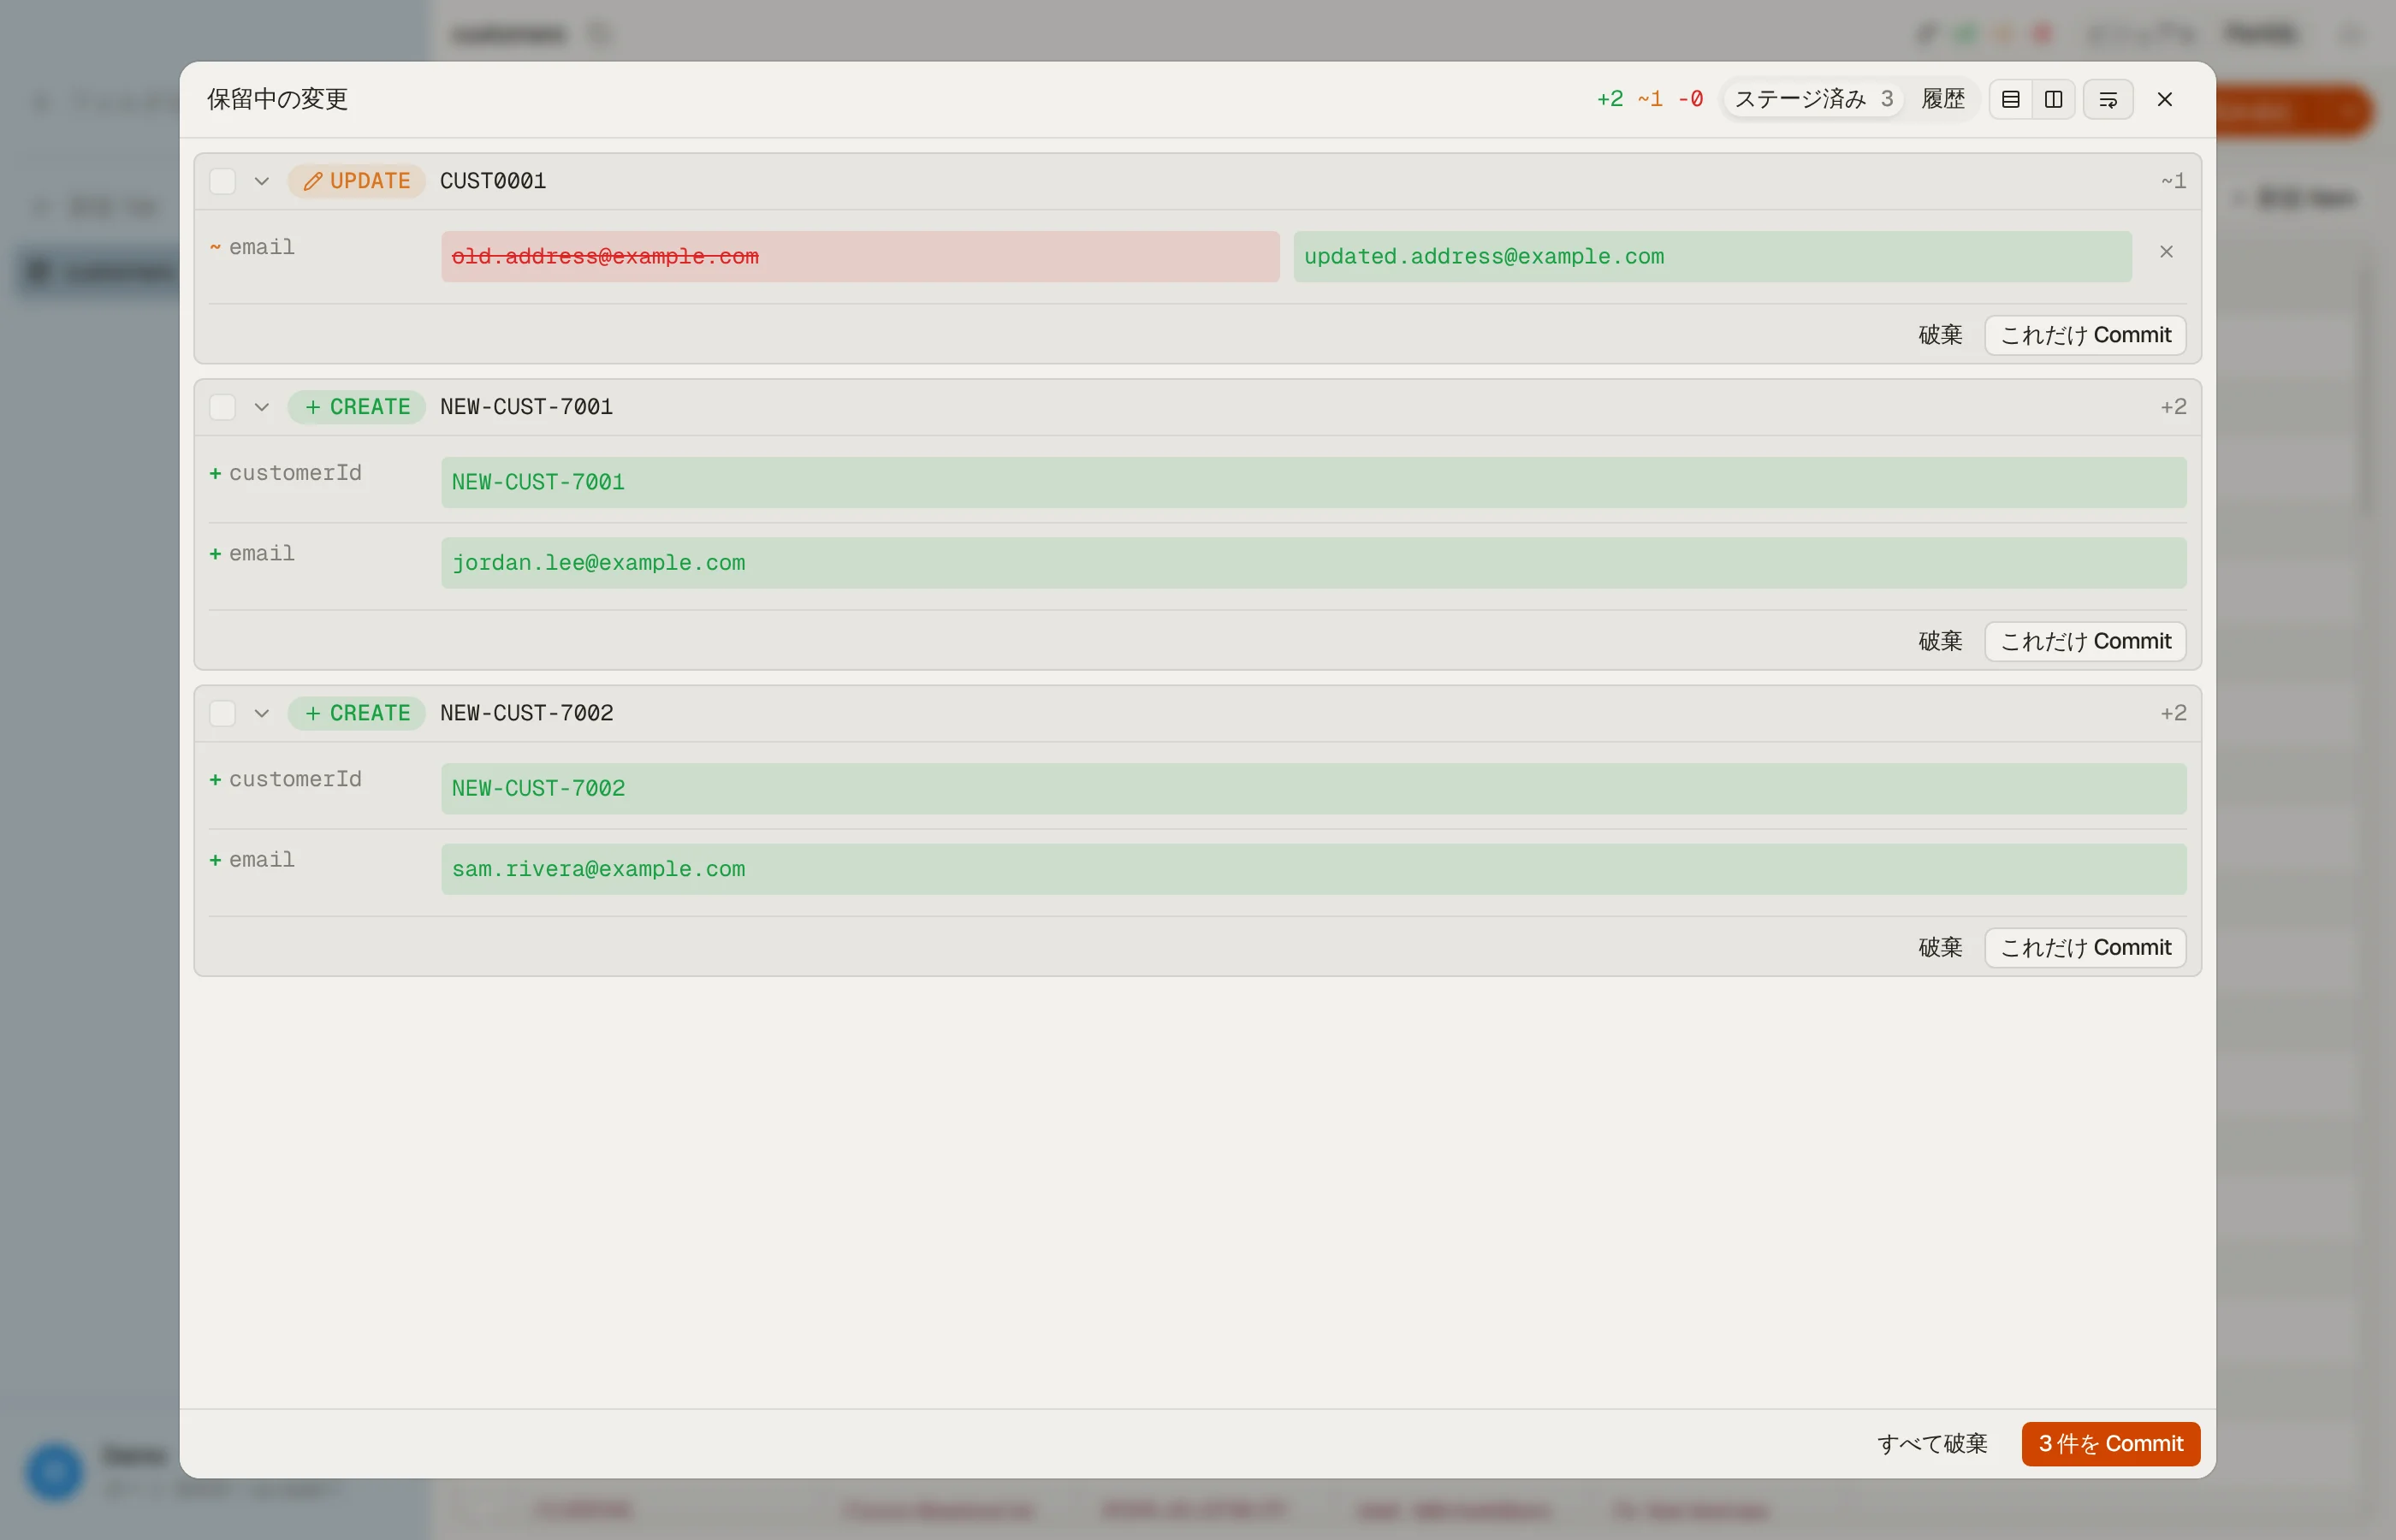
Dynomate のサイトにもドキュメントにも、AI アシスタントもエージェントも MCP サーバーも記載されていません。DynoTable には、アプリそのものを操作する AI エージェントがあります。キースキーマを読み、クエリを実行し、テーブルを絞り込み、アイテムの編集を下書きします。推論はあなた自身の AWS アカウントの Amazon Bedrock 上で動き、DynoTable のサーバーがあなたのプロンプトや行を見ることはありません。
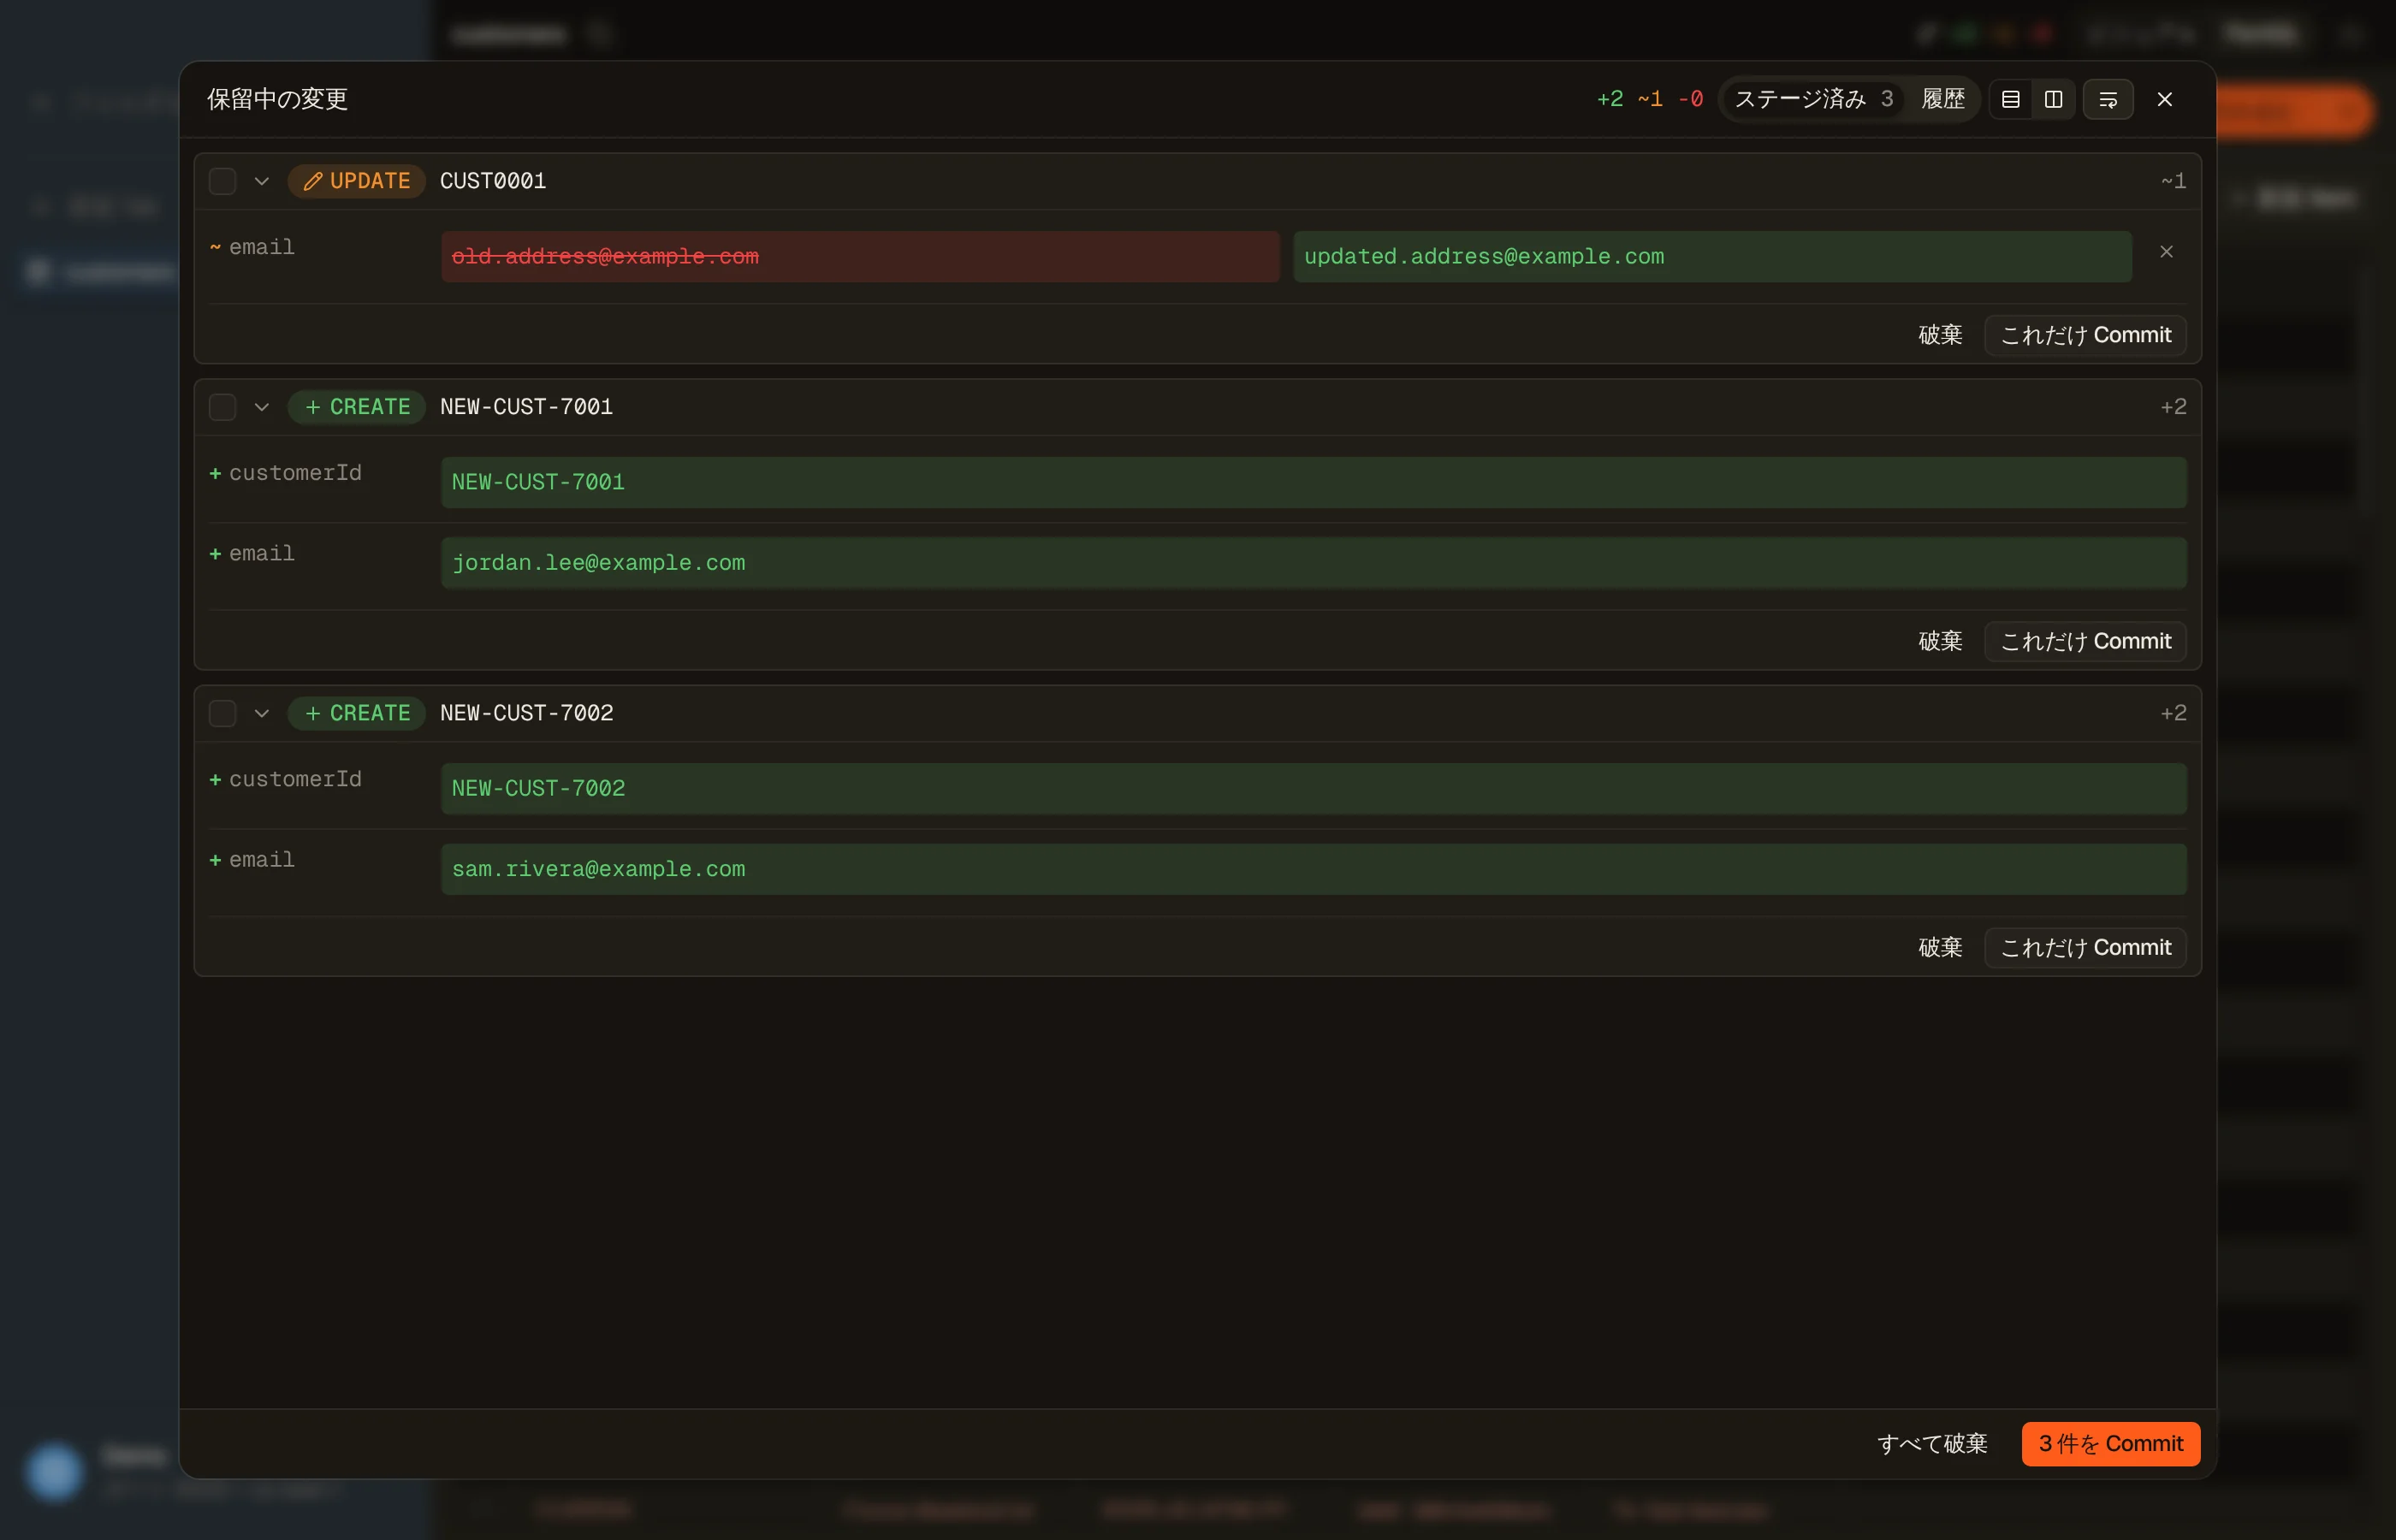
エージェントは DynamoDB に直接書き込めません。その編集はステージすることしかできず、属性ごとの diff としてあなたがレビューしてコミットします。セットアップは AI チャットのドキュメントで説明しています。すでに Claude Code、Cursor、Codex で作業しているなら、DynoTable は MCP サーバーも動かすので、それらのツールからテーブルを読めます。その書き込みも同じようにステージされます。


Dynomate の操作には、ベクトル検索は 1 つもありません。DynoTable はテーブルの Table indexes ペインからベクトルインデックスを作成・削除し、Bedrock の埋め込みモデルと読み取り元の属性をそこに結び付けます。打ち込んだ文章、貼り付けたベクトル、行の Find similar で検索でき、スキャンならテーブルをページ送りするところを、どれも 1 回のリクエストで返します。
ベクトルインデックスにはオンデマンドのテーブルが必要で、DynamoDB Local では動かず、作成には有料シートが必要で、構築には数分かかります。文章による検索と保存時の埋め込みには AI の設定(ライセンスと Bedrock プロファイル)が必要で、あなたのアカウントで Bedrock のトークンを消費します。貼り付けたベクトルと Find similar にはどちらも不要です。
アイテムエディターでの保存で元のテキストが変わると、そのアイテムは埋め込み直されます。一括編集、PartiQL での書き込み、DynoTable の外での書き込みでは埋め込み直されないので、アプリケーション側に独自の埋め込み処理が必要です。詳しくはベクトル検索をご覧ください。
どちらを選ぶべき?
- Dynomate を選びましょう: 保存され連鎖したリクエストの Git ネイティブなライブラリが、あなたとチームの DynamoDB との付き合い方の中心である場合、それらのリクエストを CI でも実行したい場合、あるいは Athena、Aurora DSQL、DynamoDB を同じウィンドウに置きたい場合。Intel Mac を使う場合や、複数のアカウントとリージョンを並べて閲覧したい場合も Dynomate です。
- DynoTable を選びましょう: 尋ねられずにいる質問がリレーショナルなもの、つまりテーブルをまたぐ
JOIN、GROUP BY、集計であり、それをエクスポートではなくライブのデータに対して答えたい場合。自分の AWS アカウント上でクライアントの中で働く AI エージェントや、インデックスと埋め込みまでカバーするベクトル検索が欲しい場合も、DynoTable を選びましょう。
どちらもメンテナンスされており、どちらも AWS の認証情報チェーンを読みます。決め手となる問いは、あなたのボトルネックがクエリの共有なのか、リレーショナルな質問なのかです。
DynoTable を試すには
DynoTable を試しても、Dynomate のセットアップは何ひとつ乱れません。コレクションはディスク上のそのままの場所に残り、どちらのアプリも同じ ~/.aws のプロファイルを読みます。macOS(Apple Silicon)、Windows、Linux 向けに DynoTable をダウンロードし、すでに使っているプロファイルに接続して、上のクエリをあなたのライブのテーブル 2 つに対して実行してみてください。
トライアルは 30 日間無料で、クレジットカードは不要です。その後も DynoTable は期限なしの Free プランのままで、閲覧、PartiQL SELECT、アプリ内でのデータ・コード・スキーマのエクスポート、読み取り専用の MCP が含まれます。現在のプランは料金をご覧ください。
よくある質問
DynoTable は Dynomate の代替になりますか?
なります。Dynomate は、Git で共有し CLI から実行するリクエストファイルを中心に作られた、活発にメンテナンスされている DynamoDB クライアントです。DynoTable はそこに、ライブのテーブルをまたいで JOIN、GROUP BY、集計を実行する SQL Workbench と、推論があなた自身の AWS アカウントの Amazon Bedrock 上で動く AI エージェントを加えます。Dynomate には AI エージェントがありません。
DynoTable は DynamoDB に対して SQL を実行できますか?
できます。DynoTable の SQL Workbench は SQL を、INNER/LEFT JOIN、GROUP BY、集計を含めて、DynamoDB の Query/Scan 操作にコンパイルするので、DynamoDB のアクセスパターンのルール内にとどまります。
Dynomate の SQL コンソールはライブの DynamoDB テーブルにクエリしますか?
しません。Local SQL がクエリするのはスナップショットです。テーブル全体のスキャンでテーブルをエクスポートし、Dynomate がそこからローカルの Parquet ファイルを作り、そのファイルに対して DuckDB SQL を実行します(dynomate.io/docs/local-sql)。これは時点をまたいでテーブルを比較するのに適しています。新しいスナップショットのたびにテーブル全体を読んで課金され、結果は最後のスナップショットと同じ鮮度です。
関連ページ
- すべての DynoTable 代替については、完全な比較ハブをご覧ください。
- 定番の相手も検討中ですか? Dynobase との比較をご覧ください。
- DynamoDB GUI としての DynoTableと NoSQL Workbench との比較もあわせてどうぞ。
- 無料の DynamoDB Expression Builder でクエリを素早く組み立てましょう。
最終確認 2026-10-09。Dynomate はそれぞれの所有者の商標であり、ここでは識別目的でのみ言及しています。