安価な LLM を DynamoDB で確実に動かした方法
DynoTable の AI エージェントは、あなた自身の AWS Bedrock の認証情報で動作します。モデルはあなたが選び、多くの人は安価なものを選びます。
そこで私たちは、下限モデルである Amazon Nova 2 Lite に合わせてエージェントをチューニングしています。呼び出し 1 回あたりのコストは 1 セントにも満たず、フロンティアモデルにはない失敗の仕方をします。
2 つの Eval シナリオで、Nova 2 Lite は顧客とその注文の結合ビューを設定しなければなりません。このモデルは、DynamoDB が解決できない結合をバリデーターが拒否し始めるまでは合格していました。その後は、記録した 2 回の実行の両方で失敗しました。
私たちは 1 回の変更で、そのエラーを結合をどちらの方向で組むべきかを伝える内容に書き直し、エージェントの指示に対応するルールを追加しました。すると Nova 2 Lite は各シナリオで 3 回中 3 回合格し、それ以降もその結果を維持しています。
このような飛躍はまれでした。メッセージの書き直しのほとんどは何も変えず、私たち自身の eval が一部の誤った答えを正解として採点していたこともわかりました。
この記事では、すべてのツール呼び出しを取り囲むバリデーター、私たちが削除したチェック、そして各変更を判定する eval を紹介します。予算モデルの上でエージェントを構築しているなら、対象が DynamoDB であれそれ以外であれ、そのほとんどが応用できます。
安価なモデルは DynamoDB で決まったパターンで失敗する
DynamoDB は、クエリ言語が SQL に似ているため、小さなモデルにとって難しい対象です。PartiQL は SELECT を受け付けますが、DynamoDB は JOIN、GROUP BY、DISTINCT、LIKE を実行しません。
インターネットから SQL を学んだモデルは、それらをすべて書いてしまいます。そのため、エージェントには 2 つのクエリ経路があります。runPartiQL は PartiQL を DynamoDB に送ります。runWorkbenchSql は、結合や集計を含む完全な SQL を DynoTable の SQL Workbench で実行します。
以下の各失敗が、それぞれガードレールを生みました:
limit引数の欠落: 5 月、ある安価なモデルが、10,000 アイテムのテストテーブルに対して任意の行数上限を省きました。結果は約 200 KB になり、次のターンはprompt is too long: 206810 tokens > 200000 maximumで失敗しました。- サポートされない構文: 安価なモデルは PartiQL で
JOIN、GROUP BY、集計を書きます。これらは Postgres では正しいものの、DynamoDB は拒否します。 - 識別子の取り違え: SQL エディターの AI 書き換え機能であるインライン編集で、
SELECT * FROM customersを国で絞り込むよう頼まれた Nova 2 Lite は、ordersをクエリしました。パースは通るので、構文チェックでは捕まりませんでした。現在、インライン編集はテーブルが変わった場合に再試行します。 - 推測されたキー: 1 つの商品を頼まれた Nova 2 Lite は、スキーマを正しく読んだあと、でっち上げたキー値で
getItemを 13 回呼び出しました。どの空振りも、値の形式については何も示しませんでした。モデルはステップ上限に達し、答えは出ませんでした。
修正方法を示すエラーとプロンプトルールで、安価なモデルがより厳しい結合を通過した
冒頭の結合ビューには罠があります。customers はシンプルなキーを持ちます。orders は customerId と orderId からなる複合キーを持ち、customerId 単独のインデックスはありません。
そのため、customers から始めて customerId で注文を参照するビューは解決できません。修正方法は、orders をベーステーブルにし、代わりに各顧客を参照することです。
私たちのバリデーターは、この壊れた提案を拒否しました。最初のメッセージは、その結合はサポートされていないと述べ、GSI か別のクエリを提案していました。結合を反転すればうまくいくとは一度も言っていませんでした。
そのバリデーターが存在する前は何もこれを拒否せず、Nova 2 Lite は両方のシナリオに合格していました。バリデーターによってタスクが厳しくなったのです。
最初のメッセージに対して、Nova 2 Lite は記録した 2 回の実行の両方で失敗しました。どちらも 1 つのシナリオの単発試行です。
6 月、私たちは 1 つのコミットで 2 つのことを変えました。メッセージを指示的にし、うまくいく経路を示すようにしました。エージェントの指示には、同じ罠に対する汎用的なルールを加えました。複合キーのテーブルをベースにする、というものです。
そのコミットのあと、Nova 2 Lite はそのシナリオで 3 回中 3 回、2 つ目の結合シナリオでも 3 回中 3 回合格しました。メッセージとルールの効果を切り分けた実行記録はないため、功績は両者で分け合います。
現在、私たちのテストテーブルに対するメッセージは次のように終わります:
FIX: FLIP the join — make "orders" the baseTable and join → "customers" instead (swap fromTable/toTable AND fromAttr/toAttr), with toLookup:{kind:"pk"}. Do NOT retry the same direction.この結果は、後述する eval の監査のあとも維持されました。8 月 4 日、ハーネスを修正した状態で、Nova 2 Lite は両方のシナリオに 3 回中 3 回合格しました。
トレースを見ると、メッセージが何をしているかがわかります。8 月 5 日と 6 日に行った 2 つの結合シナリオの Nova 2 Lite の全 30 回の実行で、この拒否の直後の呼び出しは結合を反転させ、バリデーターはそれを受け入れました。
8 月には、2 つ目の修正が上述の推測されたキーに対して同じことをしました。現在、getItem の空振りは、DynamoDB がキーの形を受け入れたので値が間違っていると伝え、まず実際のキーを 1 つ読むようモデルに指示します。
そのシナリオで、Nova 2 Lite は修正前の 8 回中 0 回から、修正後の 9 回中 9 回の合格になりました。
2 つの成功には共通の形があります。モデルは正解まであと 1 アクションのところにいて、ツールの結果はそれがどのアクションかについて何のシグナルも与えていませんでした。ほとんどの失敗は、そういう形をしていません。
8 月 5 日、私たちはさらに 7 つの拒否メッセージを同じスタイルで書き直し、それぞれが何が届いたのか、何を送るべきかを示すようにしました。それらが関わる 33 のテストケースで各 3 回実行したところ、Nova 2 Lite は 91.9% から 89.9% になりました。
GPT-5.6 Luna は同じケースで 73.4% から 76.3% になりました。33 ケース中 28 ケースでは結果が変わらず、ケースあたり 3 回の実行では、この程度の小さな向上はノイズの範囲内です。
Nova 2 Lite では 33 ケース中 31 ケースが変わらず、2 つの低下はどちらも新しいメッセージ以外の原因によるものでした。
メッセージはより明確でコストもかからないため、そのまま残しました。また、効果がなかったという結果も記録したので、結合の修正のような飛躍を期待して誰かがその一連の実行をやり直すことはありません。
検証は、エラーが教えられるツールの内側に置く
私たちは、各ツールの実行ステップの内側で検証を行います。入力スキーマによる拒否は、型エラーとしてモデルに届きます。独自のチェックを実行するツールは平易な言葉でエラーを返すことができ、モデルは次のステップでそれを読みます。
これはエクスポートから学びました。6 月、私たちのエクスポートツールの入力スキーマは、モデルが推測する理由のない 3 つのフィールドを要求していました。実際のキャプチャでは、Claude Haiku 4.5 が代わりにクエリと形式を送っていました。
スキーマはその呼び出しを拒否しました。モデルは再試行せず、ユーザーにエクスポートボタンを使うよう伝えました。問題は私たちのスキーマにあったので、ツールを変更しました。
エクスポートツールは現在、開いているタブか SQL クエリのどちらかを受け付け、その入力を自ら検証します。そのエラーのうち 2 つを原文のまま示します:
startExport requires exactly one of {tabId} or {sql}. FIX: call listOpenTabs and pass {tabId} to export an open tab, or pass {sql} (a read-only SELECT) for a one-shot export.startExport {sql} must be a read-only single SELECT. FIX: remove any INSERT/UPDATE/DELETE/DDL and any second statement; only a single SELECT is allowed.現在、5 つのエクスポートシナリオのうち 4 つは、エージェントがユーザーにエクスポートボタンを使うよう伝えた実行をすべて失敗とします。
クエリの検証エラーも同じルールに従います。どれも validation: とコードで始まります。たとえば拒否された JOIN は validation: partiql-unsupported: JOIN is not supported by DynamoDB PartiQL. で始まります。
この接頭辞は、ツールを再び呼び出す前にステートメントを修正するようモデルに伝えます。
具体的な例をどこに置くかも重要です。バリデーターが実行時に間違いを捕まえる場合、エージェントの指示は汎用的なままにし、モデルが必要とするその瞬間に、エラーがユーザーの実際のテーブル名を届けます。
集計を Workbench に送るといった、どのバリデーターもチェックできない選択には、代わりに指示の中で具体的な例を与えます。
拒否するつもりの構文はパースする
JOIN キーワードを指し示すだけの汎用的な構文エラーは、何も教えません。そこで私たちの PartiQL パーサーは、DynamoDB がサポートしない構文を有効な構文木として読み込みます。そのあとの処理で、それぞれを名前で報告します。
モデル向けのメッセージの一部を原文のまま示します:
JOIN is not supported by DynamoDB PartiQL.GROUP BY is not supported by DynamoDB PartiQL.DISTINCT is not supported by DynamoDB PartiQL.TOP N is not supported. Use the API limit parameter.IN list has 120 items. DynamoDB PartiQL caps IN at 50 values (PK column) or 100 values (non-key column).
各メッセージは構文の名前を示します。DynamoDB に同等の機能がある場合は、それも示します。JOIN や GROUP BY には PartiQL の同等機能がないため、エージェントはそのクエリを Workbench の経路に移します。
私たちのリカバリーシナリオは、どちらの経路も受け入れます。モデルが最初から Workbench に回す場合も、PartiQL を試して拒否を読み、切り替える場合もです。パーサーはオープンソースです。どう構築したかはパーサーの記事で説明しています。
キーのみのスキーマチェックは、すべての非キーカラムにフラグを立てていた
DynamoDB の DescribeTable は、AttributeDefinitions にテーブルとそのインデックスのキー属性しか列挙しません。私たちの Workbench コンパイラーはカラムをそのリストと照合していたため、amount のような非キー属性をすべて未宣言としてフラグを立てていました。
エージェントの Workbench 経路で SQL を直接実行するように変えたとき、その経路からこのチェックを外しました。残していれば、SUM(amount) や非キー属性での結合といった普通のクエリを拒否していたはずです。
エージェントの経路にはパースチェックと読み取り専用チェックが残り、見つからないカラムは Workbench エンジン自身が報告します。
エディターでは、この警告がアプリですでに検出済みのフィールドパスも参照するようになったため、誤った警告の大半はなくなりました。
結果の上限によって、モデルは行を列挙せずにテーブルを渡す
limit 引数の欠落は、ツール側で修正しました。モデルが目にする各クエリ結果は、10 行または 5 KB のいずれか先に達したほうで上限がかかります。最初の 1 行だけでそれより大きい場合でも、モデルはその行を受け取ります。
切り詰めの通知は、次に何をすべきかをモデルに伝えます。4,200 行の結果に対する通知を原文のまま示します:
Showing 10 of 4200. To filter: re-run with WHERE. To view in UI: emit proposeOpenTable. To aggregate: use runWorkbenchSql GROUP BY.上限は、コンテキストが保持できる量よりも意図的にはるかに低くしてあります。モデルにはチャットに何百行も貼り付けるのではなく、本物のテーブルビューか正確な集計をユーザーに渡してほしいからです。通知は経路ごとにツールの名前を示します。
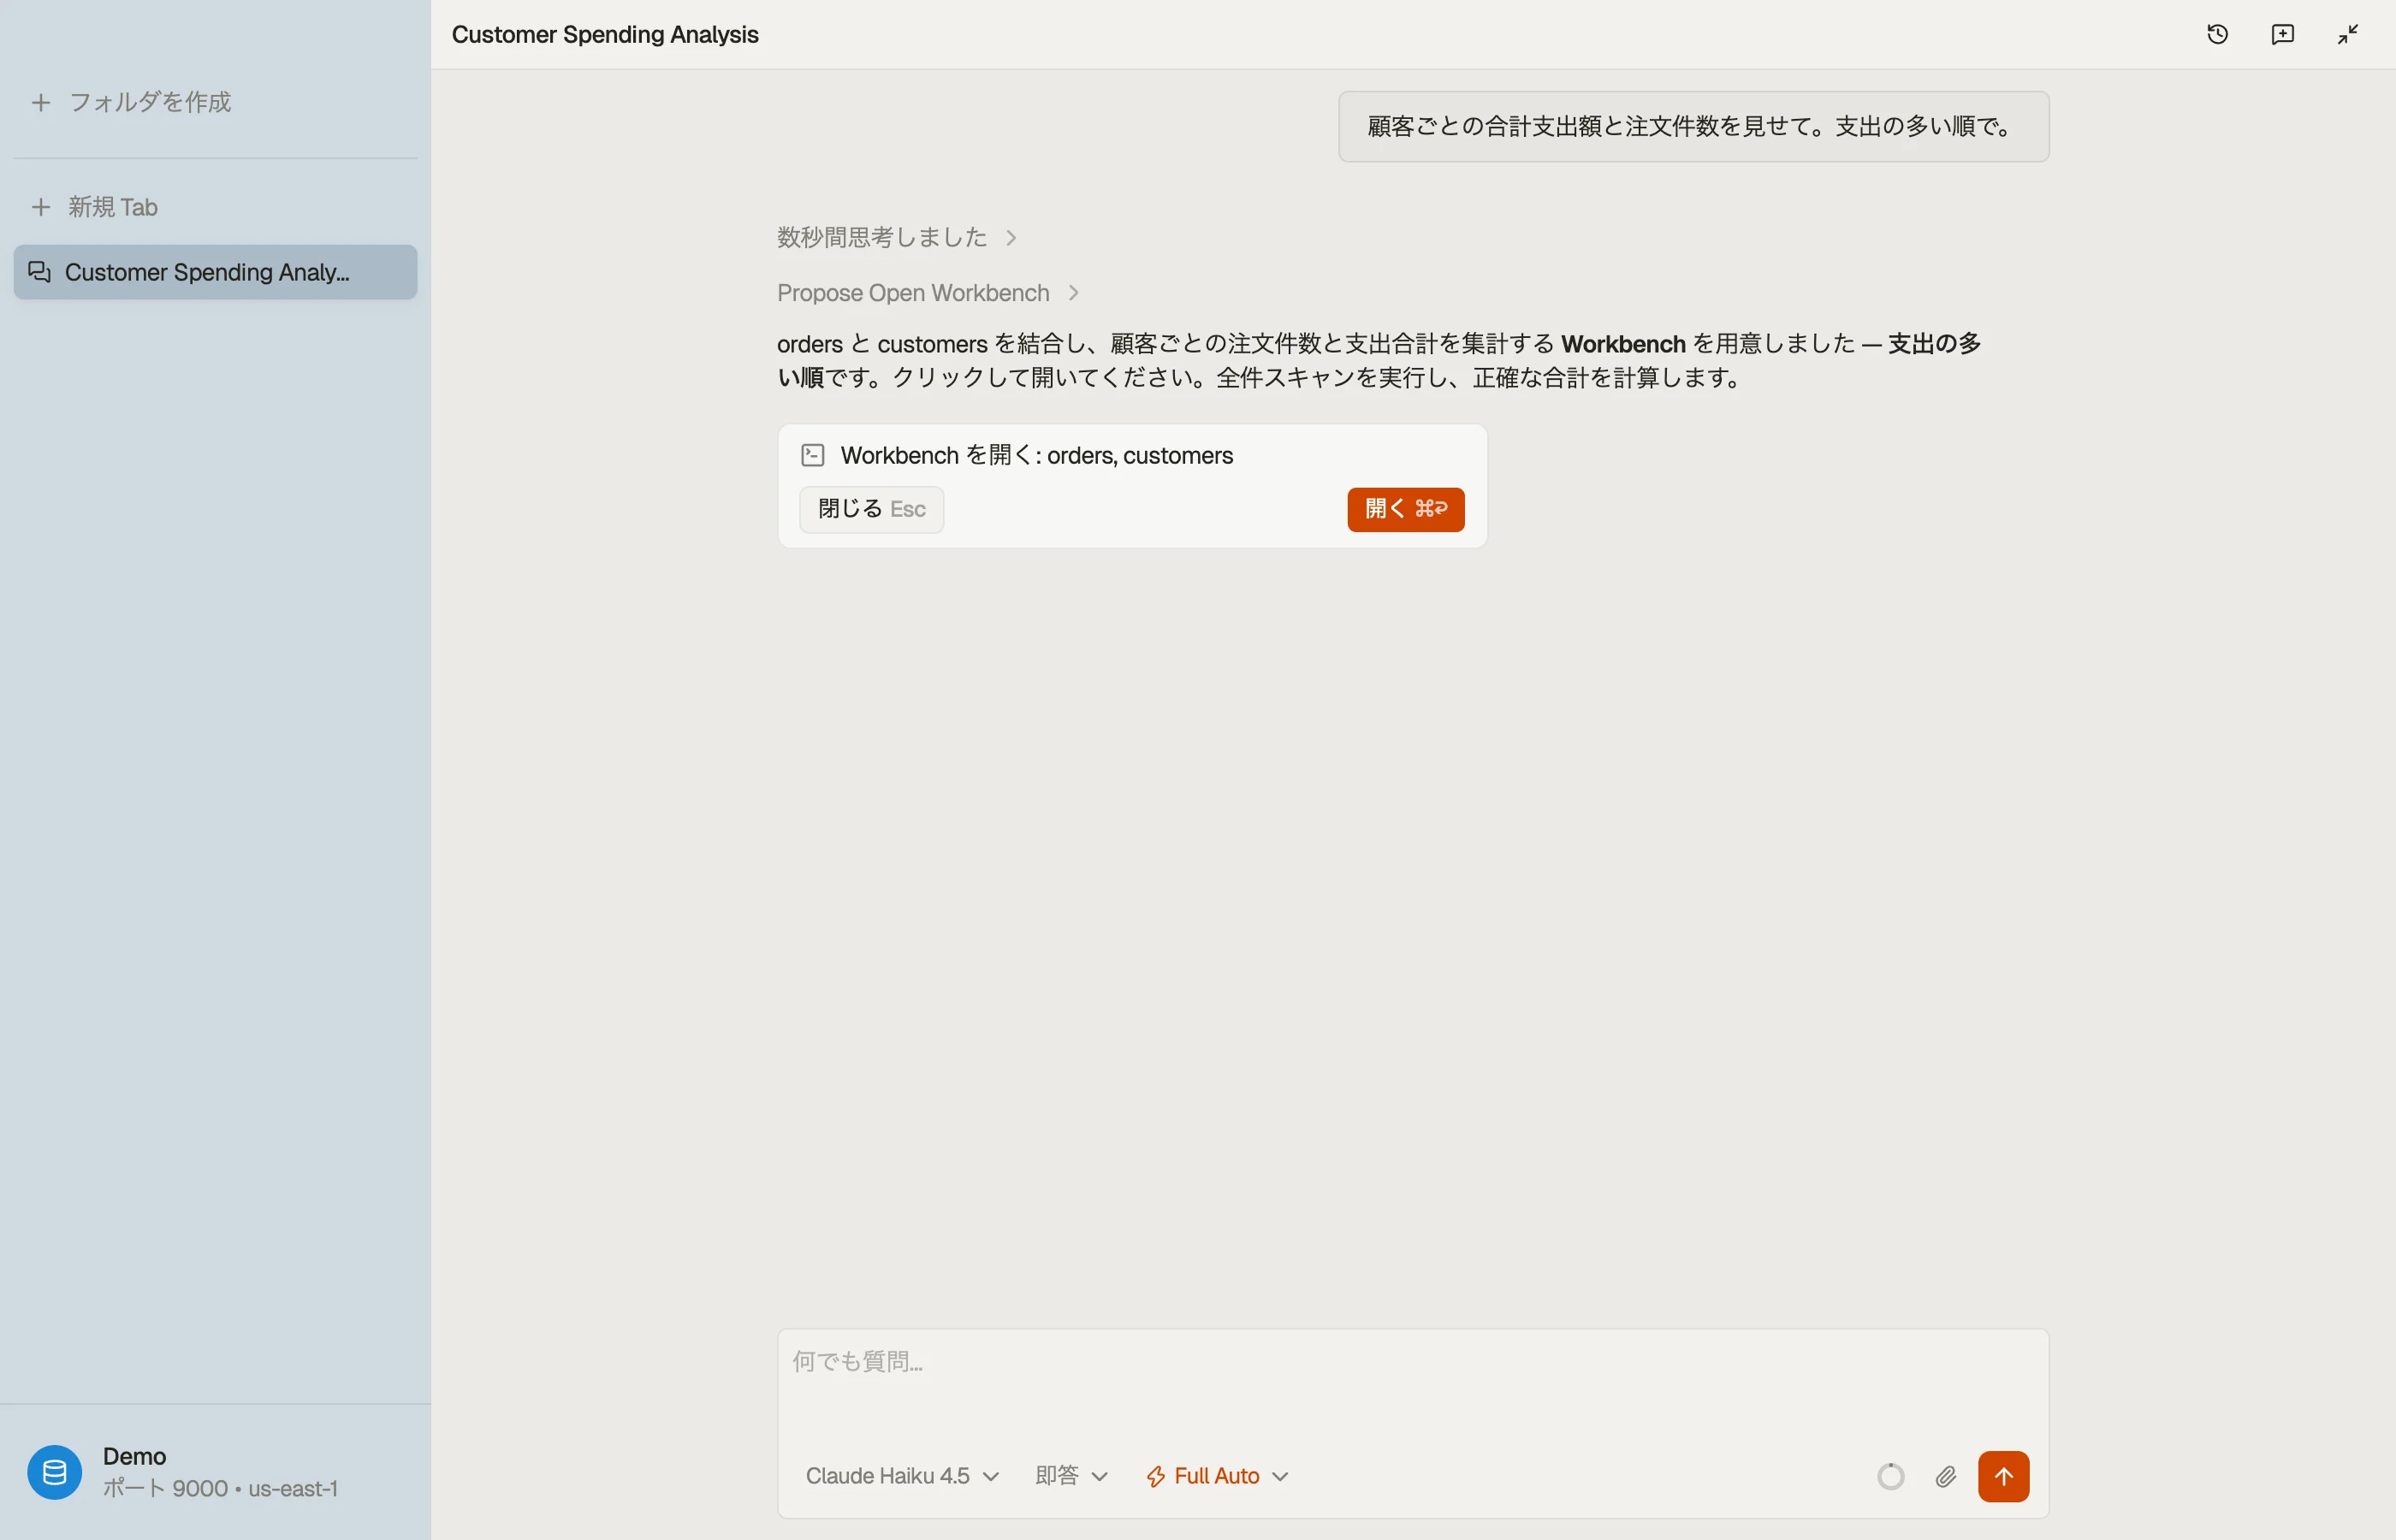
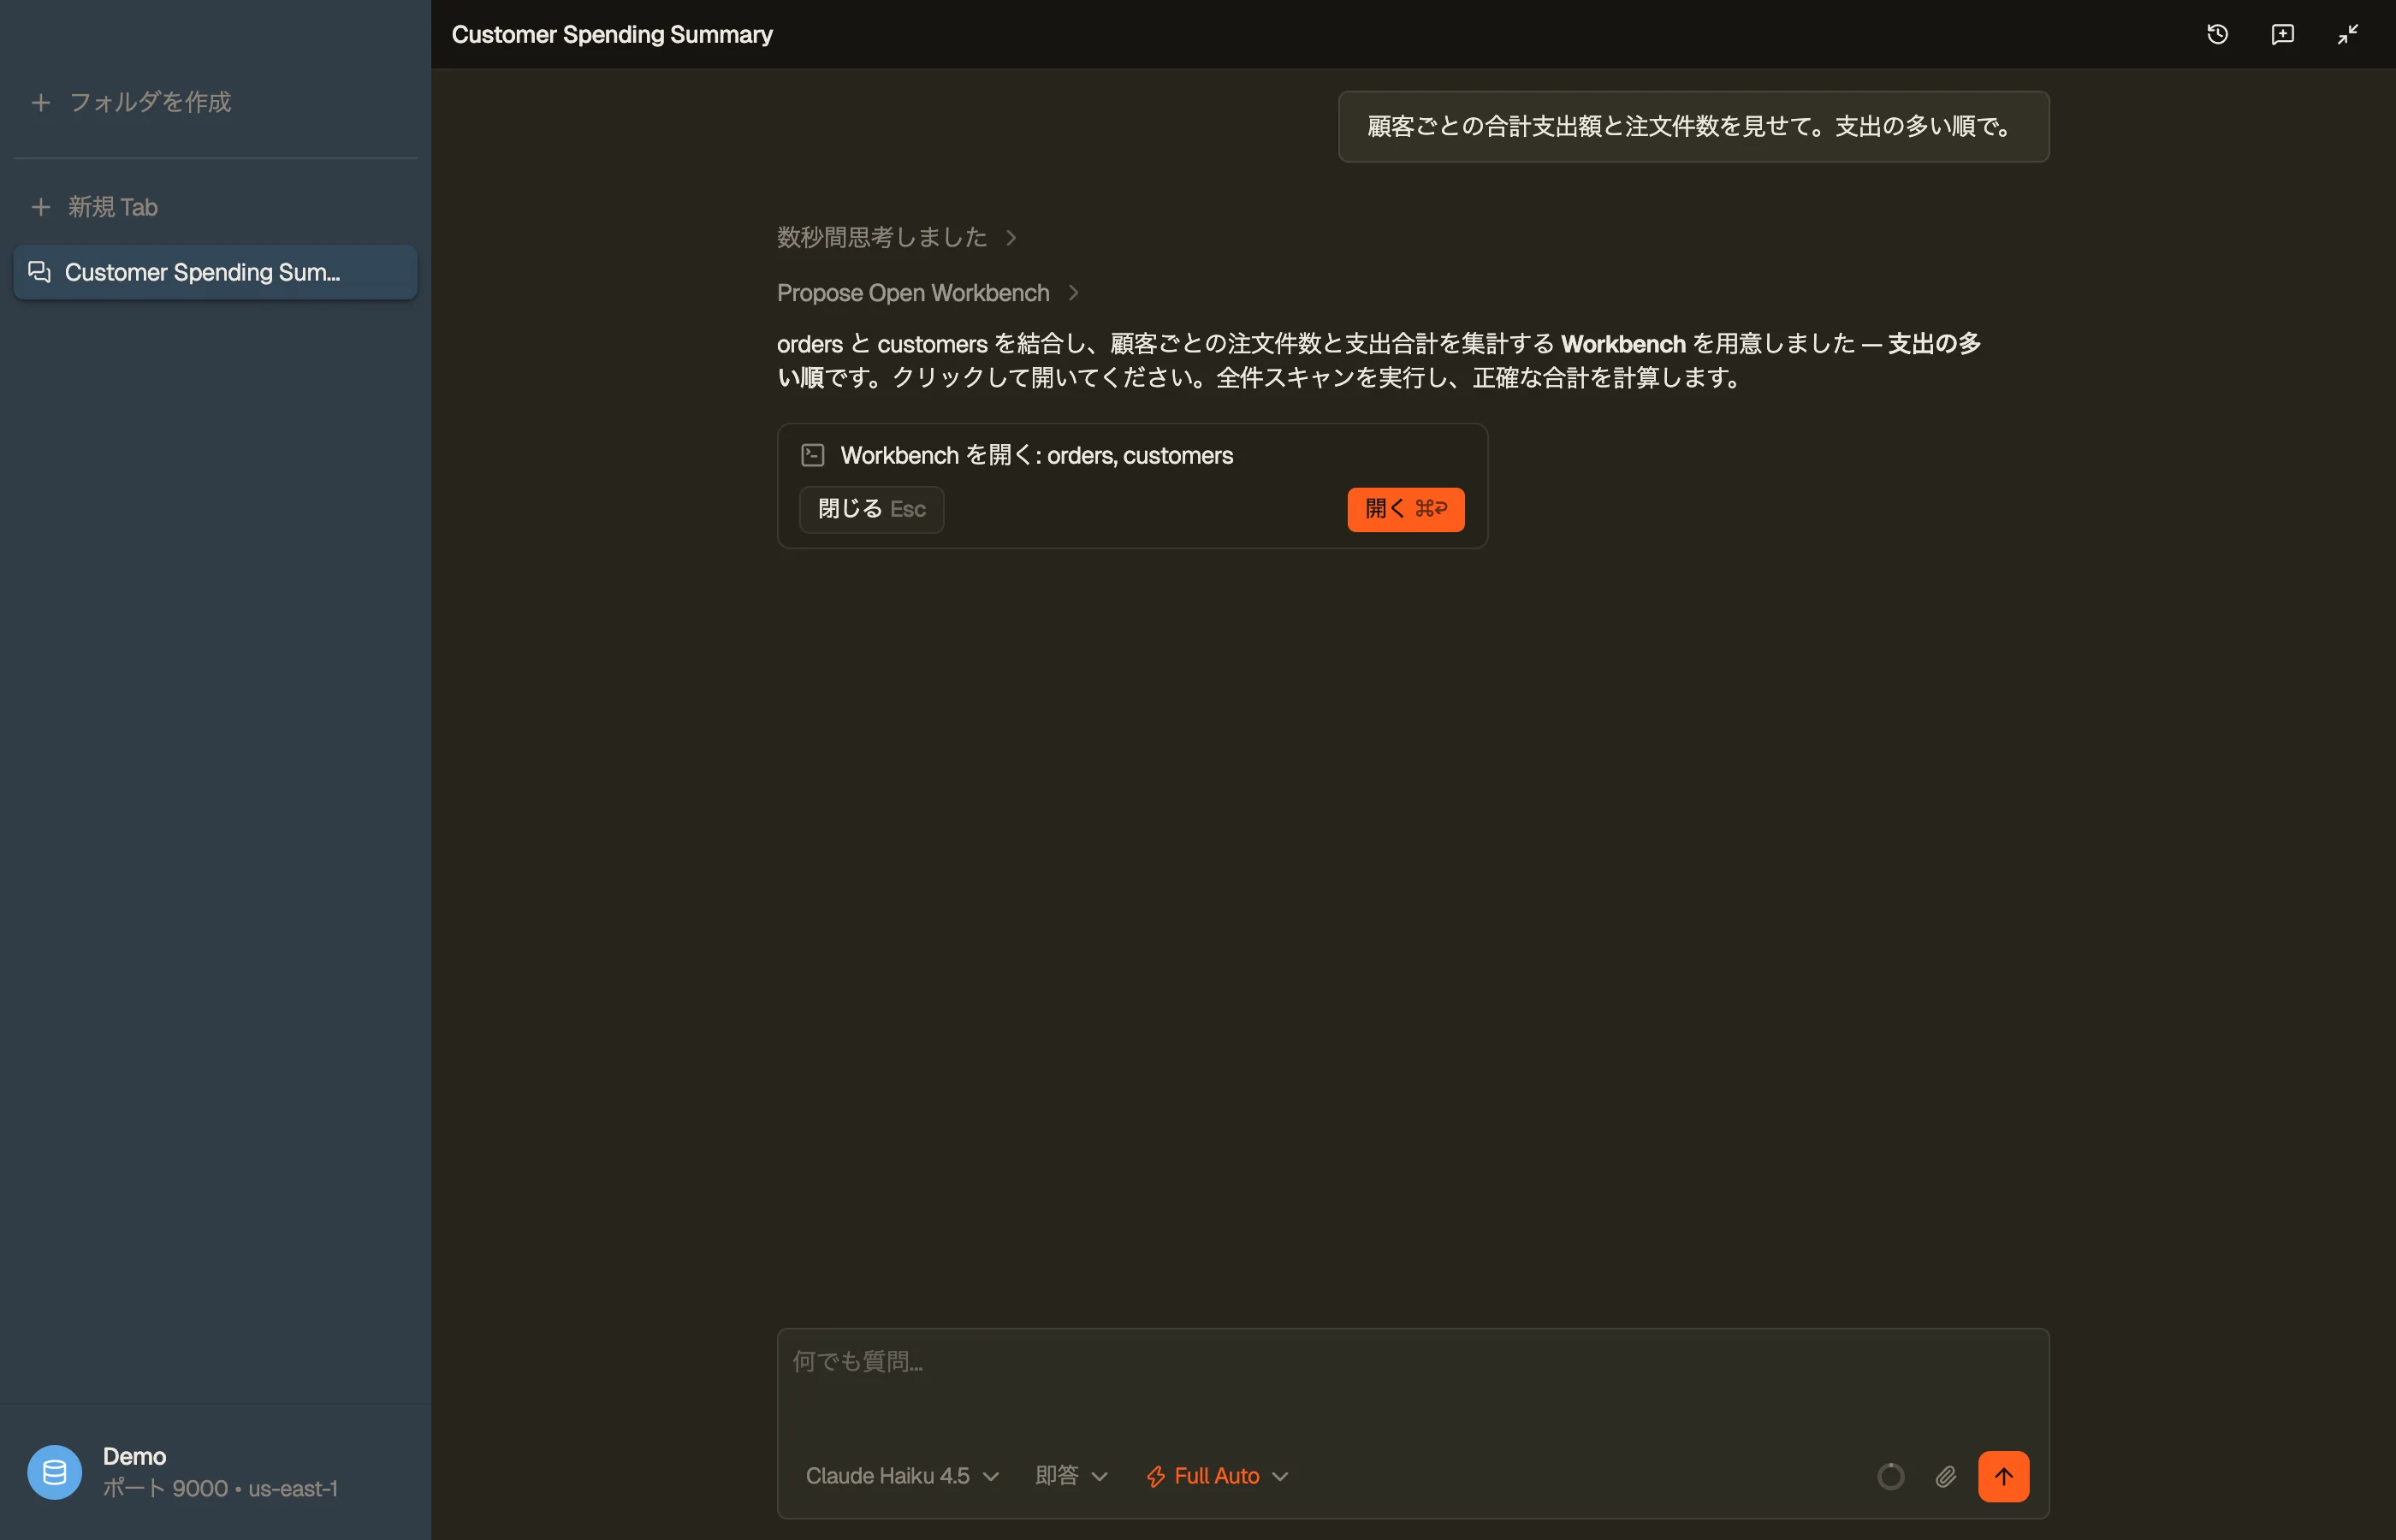
上限が適用されるのは、モデルが目にするものだけです。Workbench はベーステーブルのすべてのページを読み、結合される各行をキーで取得するので、SUM や GROUP BY はテーブル全体を対象にします:
回帰シナリオは、10,000 アイテムのテーブルに対して LIMIT なしのクエリを実行します。結果が切り詰め済みとしてマークされて返らない限り失敗するので、上限が気づかれないまま消えることはありません。


eval は直感が見逃したものを捕まえた
私たちは、プロンプトのすべての節、バリデーターのメッセージ、上限を eval でテストしています。スイートは、シードデータを投入した DynamoDB Local に対して、Bedrock 上の実際のモデルで本物のエージェントループを実行します。
それらのループを実行するコードである eval ハーネスは、本番のバリデーターと上限を再利用します。eval のランタイムでツールを実行できない箇所では、ミラーが代わりを務めます。
チェックでは、ツールのトレース、エージェントが提案したり開いたりしたもの、そして最終的な回答を採点します。
プロンプトやメッセージの変更は、それが機能すると言う前に下限モデルで合格しなければなりません。回帰実行では、Nova 2 Lite と Claude Haiku 4.5 でそれを繰り返します。比較のために、13 モデルのラダーが選択したシナリオを実行します。
これらの実行から得た教訓の一部を以下に挙げます。そのスコアは、次のセクションで説明する eval の監査より前のものです:
- プロンプトをきれいにしたら、あるシナリオが 100% から 0% に落ちた: 読みやすかったので、ある指示をより汎用的にしました。顧客ごとの注文を数えるシナリオが、下限モデルで合格しなくなりました。気づいたのは eval だけでした。
- フロンティアモデル向けのプロンプトの助言は通用しない: Anthropic のプロンプトのガイダンスは、最新のモデルが CRITICAL や MUST に過剰に反応するため、それらを控えるよう勧めています。安価なモデルには強い表現が必要です。私たちは借り物の助言を eval でゲートしています。
- 厳格な採点者が正しい振る舞いを罰した: 確認のために
askツールを要求するチェックは、実行の 19% しか合格しませんでした。失敗のほとんどは、質問を平易なテキストで尋ねた安価なモデルでした。現在、採点者はどちらも受け入れます。 - 実際の実行がモデルの一覧を形作った: ある系統は Bedrock でプロンプトキャッシュが使えず、すべてのステップでプロンプト全体の料金を満額支払っていました。Nova Pro は
customers.customerNameのような結合カラム名をでっち上げました。実際の属性はnameです。 - メタデータが障害を隠していた: ある系統の Bedrock アダプターはツール呼び出しをプレーンテキストとして返しますが、モデルのメタデータにはそう書かれていません。実際のツール呼び出しを 1 回送って発見し、その系統は現在ブロックしています。
プロンプトの例はテストデータに存在しない中立的なテーブル名を使い、eval は別のテーブルで実行します。そのため、合格はモデルがパターンを一般化したことを示します。
無料のテスト実行では、何も答えないモックモデルを使います。これは各シナリオが登録されて実行されることを確認するものです。そのスコアは何も測定しないので、私たちが引用するスコアはすべて、実際のモデルで実際のトークンを使って得たものです。
eval が誤った答えを正解として採点していた
8 月 4 日、私たちはハーネスを本番と照らし合わせて監査し、次のバグを見つけました:
- あるツールがすべての呼び出しで失敗していた: ハーネスのコピーは、本番が宣言しているものとは別の引数名を読んでいました。その 314 回の呼び出しはすべて失敗し、それを使うシナリオはそれでも完璧な 1.0 を記録していました。
- カウントが間違っていたのに正解と採点された: カウントツールのハーネスのコピーは、
Scanの最初の 1 MB ページを行数として報告していました。10,000 行のテーブルで 2,090 です。採点者は、その数値をそのまま伝えたモデルに点を与えていました。 - Workbench が何も返さなかった: ハーネスの Workbench は、SQL をパースするだけで行を返さない代用品でした。すべての集計が空に見えたため、安価なモデルはループの上限で止められるまで同じクエリを再実行しました。
- 一部の採点者は失敗しようがなかった: トレースの採点者は拒否された呼び出しを合格として数えており、約 40 の採点者は実質的に何も検証していませんでした。
5 月に行った 6 モデルの比較はこのハーネスで実行していたため、そのスコアはもう引用していません。翌日には、getItem のハーネスのコピーが、本番がすでに送らなくなったレスポンスの形を返していたことがわかりました。
どちらの側もそれ自体では一貫していたので、この乖離はどのテストでも捕まえられませんでした。そのため現在、ハーネスは eval のランタイムが許す限り本番のコードをインポートしています。これらのバグは目で見て見つけたものなので、まだ残っている可能性が高いです。
8 月 5 日、私たちはスイート全体で、ツール名のチェックを結果のチェックに置き換えました。すべての採点者は下限モデルが合格するまで調整されており、そのせいで下限モデルのツール選択が正解の定義になっていました。
その採点者の一部は間違っていました。ある採点者は DescribeTable のアイテム数の見積もりを受け入れ、正確なカウントを不合格にしていました。別の採点者は、orders をそれ自身と結合した結合ビューに対して、下限モデルに 1.0 を与えていました。
その変更の前後のスコアは別の測定器によるものなので、比較しません。GPT-5.6 Luna のベンチマークは、結果で採点した数値だけを報告しています。
曖昧な指示は強いモデルも失敗させる
DynamoDB はどのモデルからの JOIN も拒否するので、経路とバリデーターはどの段でも重要です。私たち自身の言い回しは、安価なモデルと同じくらい簡単に強いモデルも失敗させます。
監査前の 5 月、私たちの指示はエージェントにビューとクエリの提案を優先するよう伝えるだけでした。ビュー提案のシナリオのスコアは 33 回中 0 回でした。Claude Sonnet 4.6 でさえ平易なテキストで回答したので、原因は私たちの言い回しでした。
モデルが修正のある経路を通らないこともあります。getItem のヒントは GPT-5.6 Luna には一度も届きませんでした。修正後の 9 回の実行すべてで、Luna は getItem を一度も呼び出しませんでした。代わりに PartiQL でクエリするか、テーブルビューを開いていました。
そのため、修正があるモデルで失敗したと判断する前に、トレースを確認してください。
自分で構築するときのチェックリスト
- まず下限モデルを選び、すべての変更をそのモデルでゲートする。
- ツールの内側で検証し、モデルが行動に移せるエラーを返す。
- 各拒否を、何が間違っているかに加えて
FIX:と正確な次のアクションとして書き、そこにユーザーの実際のテーブル名を含める。 - 指示的なエラーには、それぞれ指示内の汎用的なルールを組み合わせ、2 つをまとめて測定する。
- 拒否するつもりのものはパースし、メッセージがそれを名指しできるようにする。
- 各バリデーターをデータモデルと照らし合わせ、正当なクエリを拒否するものは削除する。
- ツールの結果には収まる量より低い上限を設け、切り詰めの通知で次のツールを示す。
- eval を、本番のコードパスで、実際のローカルバックエンドに対する本物のループとして実行し、例データはテストデータと分けておく。
- 採点者を監査する。ユーザーが目にする結果をアサートし、各採点者が失敗しうることを確認する。
- 効果がなかった結果も記録し、すでに何も変えなかった一連の実行を誰もやり直さないようにする。
同じ検証済みのツールがアプリと MCP で提供されている
これらはすべて、DynoTable のエージェントとそのゲートされたツールカタログに搭載されています。
あなた自身の Bedrock 認証情報での自然言語によるクエリ、テーブル全体の正確な集計、そしてステージングエリアであなたのレビューを待つ書き込みを利用できます。
外部エージェントは、MCP サーバーを通じて同じ検証済みのクエリツールを使えます。MCP サーバーをどう構築したかは、それ自体が別の話です。
コードにコミットする固定のクエリが欲しいときは、モデルを使わずに済ませましょう。Expression Builder が正確なリクエストを組み立てます。