DynamoDB 向けのローカル SQL エンジンを構築した方法
DynamoDB は 100 GB のテーブルをエクスポートできますが、集計はできません。JOIN も GROUP BY もありません。唯一の正確なカウントは、Query または Scan が Select=COUNT で返すページごとの Count で、それを自分で合計する必要があります。
AWS 自身の SQL 風インターフェースである PartiQL も、それらを追加しません。そのため、チームは同じ使い捨てのスクリプトを何度も書くことになります。Scan をページネーションし、行をマップに畳み込み、答えを出力し、スクリプトを削除する、というものです。
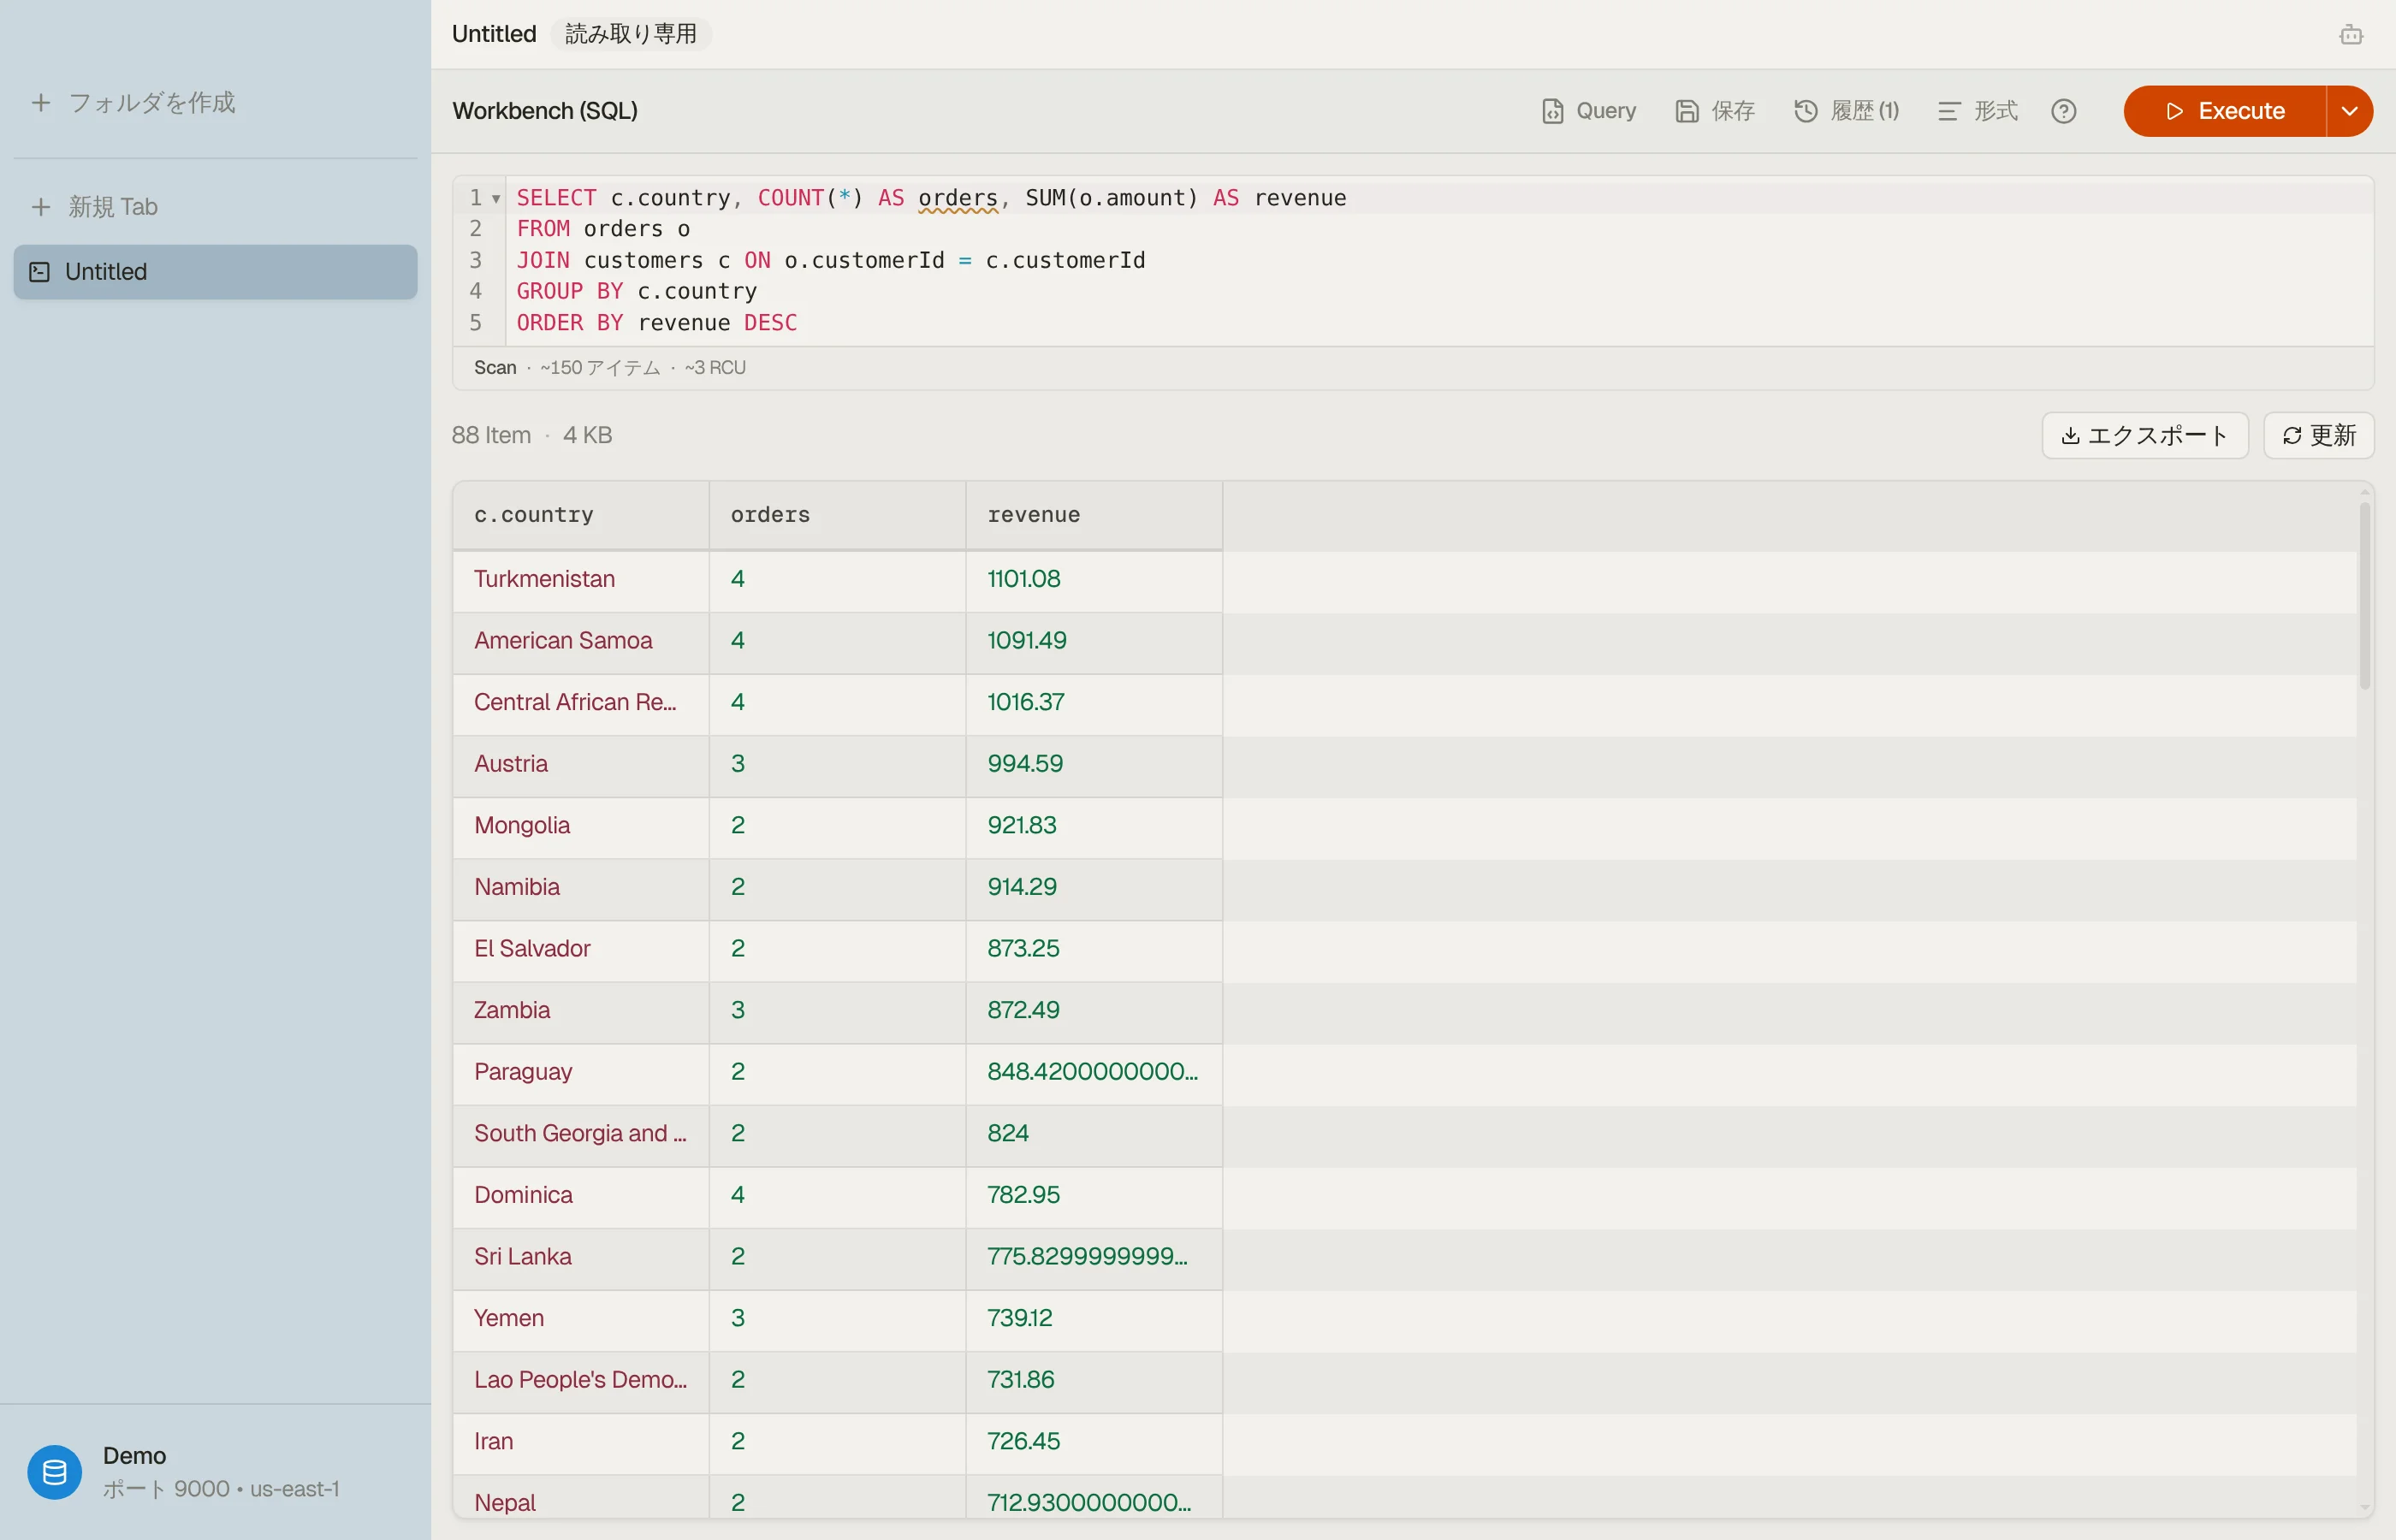
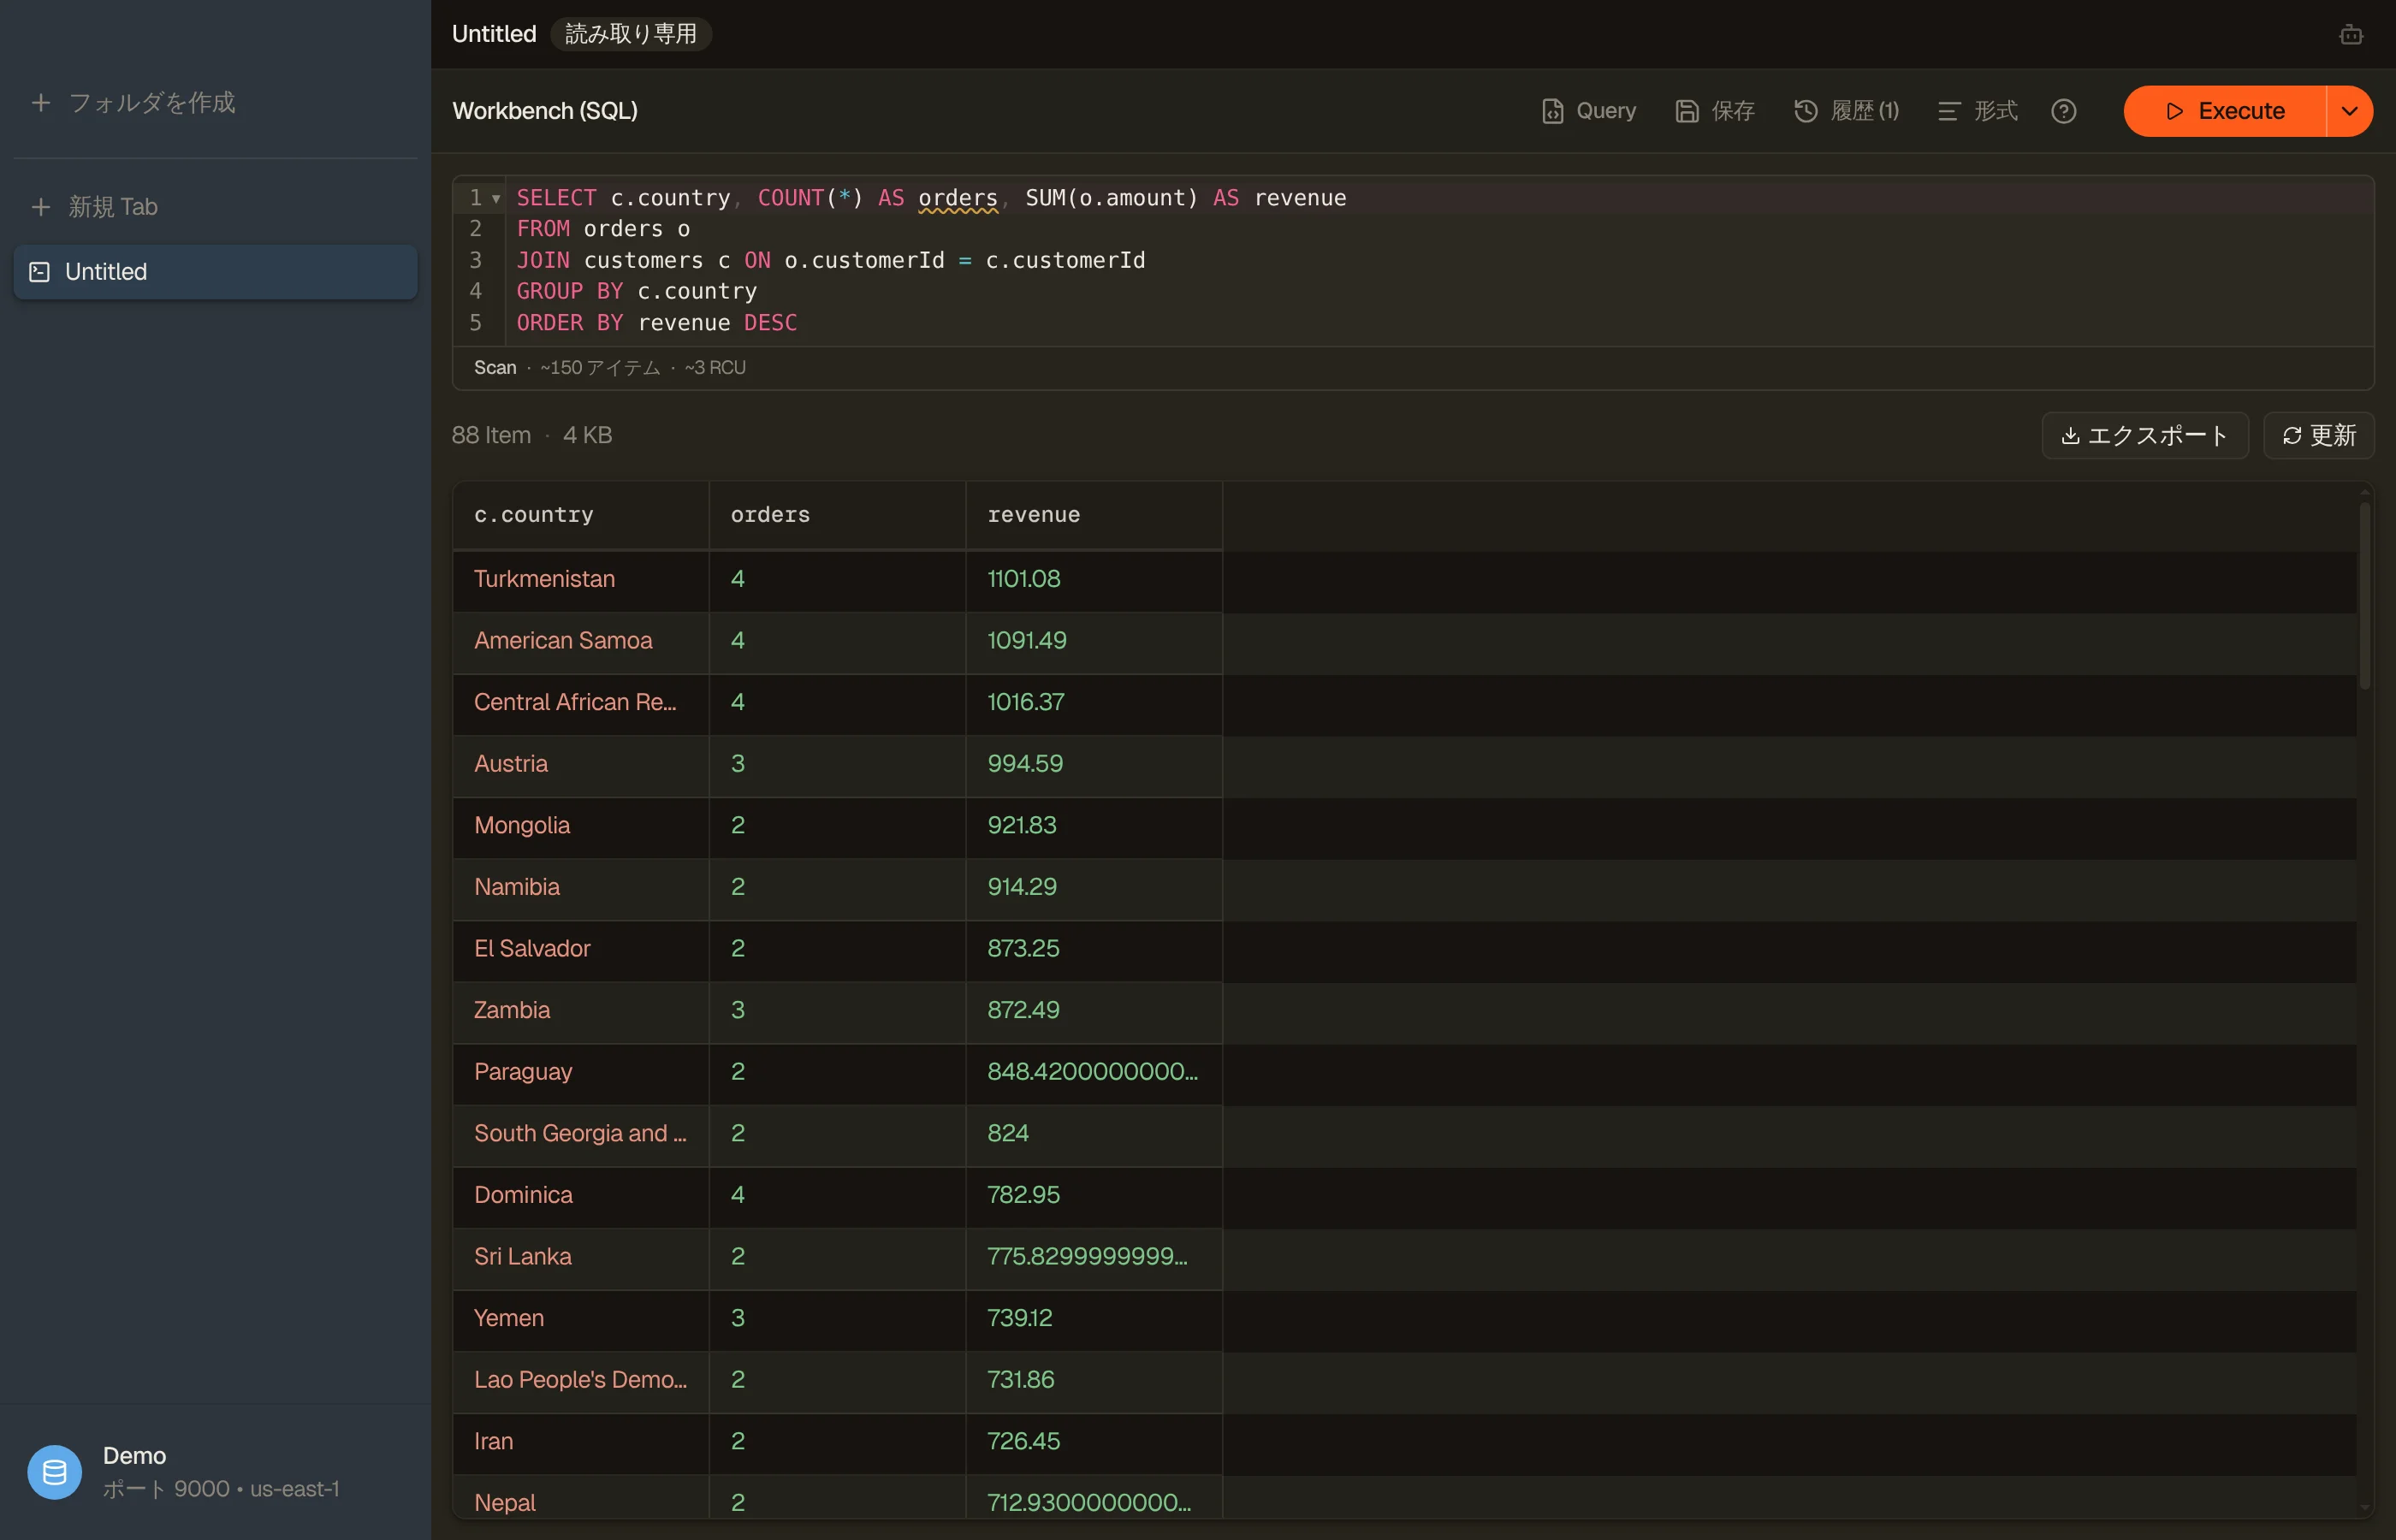
DynoTable の Workbench は、そのスクリプトを置き換えます。複数テーブルの JOIN … ON、WHERE、GROUP BY、HAVING、DISTINCT、CASE、集計を含む 1 つの SELECT を書けるタブです。
この記事では、その仕組み、エラーを出さずに誤った答えを返していた最初のコンパイラー、そして後にエンジンのメモリモデルを置き換えた理由を説明します。
既存のエンジンに SQL をコンパイルする
核となる決定は、リレーショナルな実行エンジンを書かないことでした。DynamoDB のページは埋め込みの SQLite データベースにストリーミングされ、SQLite がリレーショナルな処理を担います。私たちのコードは、あなたの SQL とそのエンジンの間にあるコンパイラーです。
各 DynamoDB アイテムは、{"platform": {"S": "ios"}} のような生の型付きエンベロープのまま、単一のカラムに格納されて SQLite に入ります。小さなユーザー定義関数が、クエリ時に属性をアンラップします。
そのため、SELECT platform はその関数の呼び出しにコンパイルされます。この関数は自身の JSON パースエラーを catch し、その行に対して NULL を返します。
catch がなければ、SQLite のバインディングは 1 つの不正な行のエラーを、ステートメント全体の中断に変えてしまいます。
Workbench のタブは、DynamoDB のアクセスパターンのルールの範囲内で SQL を実行します。JOIN の結合先は、ソートキーを持たないテーブルのパーティションキーか、GSI のパーティションキーでなければなりません。
エンジンは各結合をキー参照で解決し、結合先のテーブルをスキャンすることはありません。非キー属性に対する結合はコンパイルエラーになります。その解決はデータモデリングの問題です。


最初のコンパイラーはエラーを出さずに誤った答えを返していた
最初のバージョンは、人気のある既製の SQL パーサーを使っていました。約 1 週間のうちに 4 つの正しさのバグが積み重なり、そのパーサーが修正を阻みました。
そのうち 2 つはエミッターにありました。エミッターは、パースされた各ノードをローカルエンジン向けの SQL に戻す、コンパイラーの一部です。
SELECT DISTINCTが警告なしに落とされていた。 パーサーはそれを受け付け、エミッターは無視したため、重複行がすべて返ってきました。あるユーザーのバグ報告には "shows a table of all the values, not counters." と書かれていました。- 未対応の構文はすべてリテラルの SQL
NULLになっていた。CASE、CAST、スカラーサブクエリに対して、エミッターはreturn 'NULL'にフォールバックしていました。クエリは実行され、誤った答えを返し、エラーは出ませんでした。 - 識別子の大文字小文字が SQL のように振る舞わなかった。 属性が
platformのとき、SELECT PLATFORM FROM tは null を返しました。標準 SQL では、引用符なしの名前は大文字小文字を区別しません。 - オートコンプリートが一致する名前を見逃していた。 大文字小文字を変えて名前を入力すると何も見つからず、引用符付きの名前の候補も常に表示されるとは限りませんでした。
引用符を保持するパーサーを選んだ
置き換えとなった sql-parser-cst は、私たちが評価したパーサーの中で唯一、すべての識別子について生のテキストと正規化された名前の両方を木に保持するものでした。両方があれば、コンパイラーは platform と "PLATFORM" を区別できます。
この 1 つの区別によって、単一の文法に適切な ANSI のセマンティクスを持たせられます。引用符なしの識別子は、大文字小文字を区別せずに解決されます。引用符付きの識別子は、Postgres と同じく、大文字小文字を区別するための抜け道です。
これがなければ、大文字小文字を区別しない検索と正しいオートコンプリートを両立できませんでした。厳密な一致では行が落ちます。完全に大文字小文字を区別しない一致では、アイテムに platform と Platform の両方があるとき、Platform ではなく platform を選ぶ手段がなくなります。
パーサーはすべてのノードにソース範囲も付与するため、診断は失敗した構文そのものに下線を引きます。
私たちは return 'NULL' のフォールバックを、固定のルールに置き換えました。エミッターがサポートしないものはすべて、そのノードの範囲でエラーになります。ウィンドウ関数には次のエラーが出ます:
Unsupported expression: window function. Supported: column refs, literals, arithmetic, comparison, AND/OR/NOT, IN, BETWEEN, IS NULL, LIKE, CASE, CAST, function calls, aggregates. Not yet: window functions, scalar subqueries, set operations, CTEs.このメッセージは Workbench がサポートしているものを列挙するので、推測せずにクエリを書き直せます。
sql-parser-cst はまだ 1.0 未満です。私たちは正確なバージョンに固定し、テストスイートをゲートとして、手作業でのみアップグレードします。
私たちは 5 つの代替案を却下しました。古いパーサーにパッチを当てるには、引用符の情報を取り戻すための 2 つ目のトークナイザーが必要で、すべての入力を 2 回パースすることになります。
エディター自身の構文木を再利用する案は、その木がトークンレベルで、コンパイラーがたどれる句の構造を持たないため、うまくいきませんでした。
独自のパーサーを書くことは、SQLite パーサーの大部分を書き、終わりのないメンテナンスを抱えることを意味しました。sql-parser-cst 1.0 を待てば、4 つの正しさのバグをユーザーの前に残すことになりました。
Workbench を古いパーサーが扱える SQL に制限すれば、SQL ユーザーが動いて当然と考える CASE、CAST、DISTINCT を禁止することになっていました。
ある警告は、意図的にクエリをブロックしません。フィルターは、スキーマでは大文字小文字を確認できない属性を指定できます。DynamoDB はキー属性しか宣言せず、そのサーバー側のフィルターは大文字小文字を区別するからです。
そのようなフィルターには警告が出ますが、警告によってクエリの実行が止まることはありません。私たちのバリデーターの取り組みからも同じ教訓を得ました。最も一般的な正当なクエリを拒否するゲートは、ゲートがないよりも害が大きいのです。
メモリ内のバッファリングは、大きなテーブルで失敗するか、その一部から答えていた
最初の集計エンジンは、スキャンした行をメモリ内の SQLite データベースにバッファしていました。AI エージェントの SQL ツールでは上限が 64 MB または 100,000 行、変換ツールでは 250 MB でした。上限に達するとクエリは失敗しました。
Workbench のタブには上限がありませんでした。それまでに読み込んだページを集計していたため、大きなテーブルのすべてのページを読み込むと、アプリがメモリ不足になる可能性がありました。
再設計にあたって、私たちは使い捨てのスクリプトならどうするかを考えました。有能なスクリプトはストリーミングし、各ページを累計に畳み込むので、メモリ使用量は一定の範囲に収まります。
テーブルの一部に対する GROUP BY は誤った答えを出し、それをもとにしたランキングは誤った行を上位に置きます。私たち自身の AI デモでも、一部のデータだけによる「支出上位者」ランキングを事実として提示したことがありました。
プランナーがクエリごとにストリーミングか保存かを選ぶ
Workbench のタブは現在、ページをディスクに支えられた SQLite ファイルに保存するので、最後まで実行してもメモリに収める必要はなくなりました。
AI エージェントと MCP クライアントが呼び出す SQL ツールは、さらに先へ進みます。スクリプトと同じように動作し、そのうえでスクリプトが省くものを加えます。プランナーが各クエリを最初に読み、2 つの経路のいずれかを選びます:
- ストリーミングしながら畳み込む。 1 つのテーブルに対する単純な
COUNT、SUM、AVG、MIN、MAXで、射影するすべてのカラムがGROUP BYに含まれるもの。DynoTable は各ページを累計に畳み込みます。 - 保存してからクエリする。 ソート、キーで範囲が決まる結合、そのほかプランナーがモデル化できるクエリは、ディスクに支えられた SQLite ファイルに格納されます。上限は空きディスク容量で決まります。
プランナーがクエリをモデル化できない場合、ツールはアドホックな経路にフォールバックします。参照される各テーブルを SQLite ファイルにストリーミングし、そこで SQL を実行します。
そのため、Workbench のタブでは拒否される非キー属性での結合も、エージェントと MCP 経由では動作します。その代償は、クエリ内のすべてのテーブルのフルスキャンです。
アプリ内のエージェントでは、テーブルのサイズが畳み込み経路を妨げることはありません。テーブルが大きいほど時間がかかるだけです。
畳み込み経路は意図的に狭くしてあります。WHERE、HAVING、ORDER BY、LIMIT、結合、あるいは GROUP BY にないカラムがあると、そのクエリは保存経路に回されます。
畳み込みはそれらの句をどれも適用しません。句を 1 つ飛ばしたまま正確な結果だと報告する畳み込みは、このプランナーが防ぐために存在する、自信たっぷりの誤った答えそのものになってしまいます。
正確さは結果の一部です。Workbench のタブでは、ページがストリーミングされている間、集計に「一部」バッジが付き、スキャンが完了したときにだけバッジが外れます。
ストリーミング経路では、エンジンが整数の合計を 64 ビット整数として保存するため、2⁵³ を超えても正確なままです。2⁵³ を超える小数の合計は、黙って丸めるのではなく、自らを一部の結果としてマークします。
保存経路では、2⁵³ を超える値が 1 つでもあれば、結果は一部としてマークされます。
大規模なスキャンには同意が必要です。アプリでは、500 万アイテムまたは 1 GiB を超えるテーブルに対して単一テーブルのタブを最後まで実行する前に、確認を求めます。AI エージェントが開いたタブも対象です。
MCP の呼び出し元にはダイアログがないため、代わりにスキャン予算が適用されます。5,000 万アイテム、50 GiB、または 30 分です。キャンセルされたリクエストはスキャンを停止します。
アプリでも MCP 経由でも、モデルが読む結果は意図的に切り詰めてあります。正確さとスキャンしたアイテム数は含みますが、サイズの見積もりは含みません。その見積もりは、数時間前のものかもしれないテーブルのメタデータに基づくからです。
古い推測を与えられたモデルはそれを事実として語るので、私たちは推測を省いています。
一度きりの集計なら、ライブの Scan のほうが安い経路です。us-east-1 では、結果整合性のあるオンデマンド読み込みによるフル Scan のコストは、S3 への DynamoDB エクスポートのおよそ 6 分の 1 です。
強力な整合性のある読み込みの場合、Scan のコストはエクスポートのおよそ 3 分の 1 です。さらに、エクスポートにはテーブルでポイントインタイムリカバリを有効にしておく必要があります。
そのため、ライブの Scan がデフォルトで、エクスポートと Athena の組み合わせは繰り返し行う重い分析向けの推奨です。料金計算ツールで、月々の読み込みと書き込みのコストを見積もれます。
Workbench の SQL はテーブルに書き込めない
ローカルエンジンに届く SQL は、読み取り専用の SELECT 1 つでなければなりません。それ以外は実行前に拒否され、コンパイラーのバグとして扱われます。コンパイラーがそれを生成することは決してないはずだからです。
エンジンは、拡張機能の読み込みやその他の危険な組み込み機能を無効にした状態で動作します。Workbench の SQL には DynamoDB に書き込む経路がありません。グリッドやアイテムエディタで行った編集は、一括の直接実行を除き、まずステージされます。
自分で作るなら応用できること
- すでに存在するエンジンにコンパイルする。バグは継ぎ目に潜みます。識別子の大文字小文字、型エンベロープ、壊れた行です。
- パーサーに引用符の情報を求める。
nameと"NAME"を区別できなければ、SQL の大文字小文字のルールは実装できません。 - 未対応の構文は明示的なエラーにする。黙って
NULLをデフォルトにすることこそ、自信たっぷりの誤った答えが出荷される原因です。 - 設計を、ユーザーが書くであろう使い捨てのスクリプトと比べて測る。スクリプトがストリーミングしているのにバッファしているなら、設計を変えましょう。
- 一部の集計には一部であるとラベルを付ける。ラベルのない数値を、ユーザーは答えとして読みます。
Workbench のドキュメントは日常的に使う機能を扱っています。DynamoDB のための SQLは、エコシステム全体で何が動くのかをまとめています。
試すには、DynoTable をダウンロードし、⌘⌥B で Workbench のタブを開いて、JOIN を持たないデータベースに対して JOIN を実行してみてください。